6.1 Profiling 与瓶颈定位
6.1 Profiling 与瓶颈定位
本节摘要:开启 SessionOptions.enable_profiling 或环境变量 ORT_PROFILE,ORT 记录每 kernel 耗时、分配事件,输出 JSON trace。结合算子占比判断该改 EP、改融合还是改线程——避免凭感觉调参。
40ms 花在了哪里
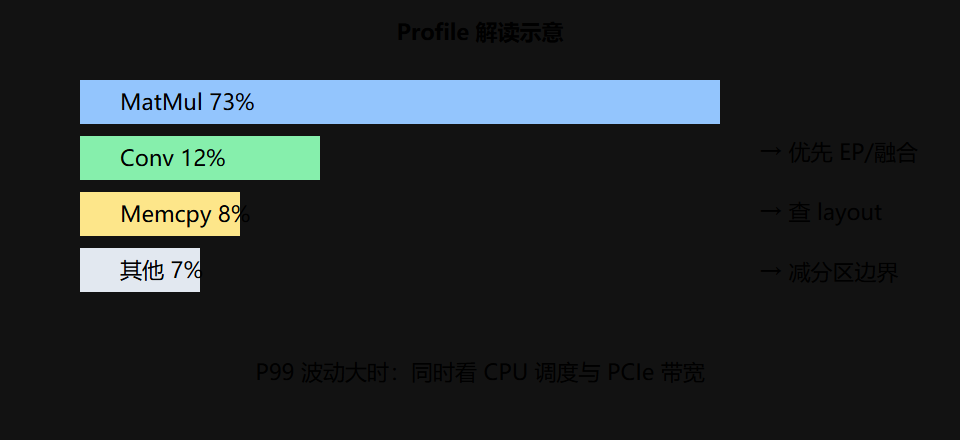
「整体 40ms,不知道花在哪」——Profile 显示单个 MatMul 占 73%,或 Gather 触发 12 次跨 NUMA 拷贝(SOURCE 7.1 类案例)。没有 trace,团队会在量化、换 GPU、改 batch 之间随机试。Profile 把 40ms 拆成每个节点的耗时,让"盲猜"变成"定点"。
ORT 性能演进三阶段:2019–2021 手工调参 → 2022–2023 可测量(ORT_PROFILE)→ 2024+ 策略化治理闭环。现在至少要做到底线:任何性能问题,先出 profile,再说话。
瓶颈信号与处置
| 信号 | 可能根因 | 动作 |
|---|---|---|
| MatMul 高占比 | GEMM 未上 TRT | 换 TRT EP |
| Memcpy 高 | EP 边界多 | 改分区/合并子图 |
| 小算子碎片化 | 融合失败 | 查导出/优化级别 |
| Softmax warp divergence | axis 设置 | 改 layout 或 CPU |
| 单算子独占 | 算子内瓶颈 | 改 intra / 换 kernel |
信号到动作的映射是本文核心:MatMul 占比高,第一反应不是量化而是看它是否被 TRT/CUDA 接管——接管了还慢才谈优化;Memcpy 占比高,回第2章查分区;小算子碎片化,回第2章查融合;没有单一热点,才轮到线程与内存策略。
开启 Profiling 并解析
import onnxruntime as ort import numpy as np import json so = ort.SessionOptions() so.enable_profiling = True sess = ort.InferenceSession("model.onnx", sess_options=so, providers=["CPUExecutionProvider"]) feed = {"input": np.random.randn(1, 3, 224, 224).astype(np.float32)} for _ in range(50): # 足够 warmup,再采集 sess.run(None, feed) prof_file = sess.end_profiling() # 返回生成的 json 路径 print("profile:", prof_file) # 解析:按节点耗时排序 with open(prof_file) as f: prof = json.load(f) node_times = {} for ev in prof: if ev.get("cat") == "Node" and ev.get("dur"): name = ev.get("name", "?") node_times[name] = node_times.get(name, 0) + ev["dur"] total = sum(node_times.values()) / 1000 # us -> ms for name, us in sorted(node_times.items(), key=lambda x: -x[1])[:10]: print(f"{name}: {us/1000:.2f} ms ({us/total:.1%})")
注意采集纪律:warmup 不足时 CUDA kernel 未热身、cuDNN 算法未确定,排名失真。至少跑 10~50 次再读数据,且固定输入 shape 与 batch。
命令行基准
# 版本间延迟回归的标准姿势 onnxruntime_perf_test -m model.onnx -t 10 -e cpu onnxruntime_perf_test -m model.onnx -t 10 -e cuda
onnxruntime_perf_test 输出 latency 分布(均值/百分位),比手工脚本更可控,适合 CI 集成。-t 指定测试时长,-e 选 EP。
判断直觉与常见误区
⚠️ profile 样本太少(<10 run)——CUDA kernel 未热身,排名失真。GPU 上第一次调用 kernel 有加载与 autotune 成本,用它判断热点会把编译开销当成计算开销。
💡 先固定输入 shape 与 batch,再对比两次 profile diff。优化前后各出一份 profile,diff 的差异才是优化效果,绝对值会被环境噪声淹没。
工程实践要点
- 生产短期开 profiling,完事即关
- 与 ETW/perfetto 等系统 trace 关联(Windows/Linux),看 CPU/GPU 重叠与中断
- 建立 Performance Fingerprint 进 CI:latency + 关键算子占比
- Profile 结果归档,与模型版本绑定,方便回溯
重点提炼
- enable_profiling / ORT_PROFILE 生成 JSON trace
- Top 算子 决定优化方向
- Memcpy 暗示分区问题
- perf_test 做版本间回归
- Profile 需足够 warmup 次数
- 信号到动作映射表是定位的脚手架
性能指纹进 CI
Profile 的结果不止用于本次排查,还要沉淀成性能指纹:关键算子占比、P99、Memcpy 占比。指纹存进仓库,CI 每次模型变更后自动重测并 diff,超阈值即失败。这样性能问题在合并前暴露,而不是上线后。
# 性能指纹采集示意 import json, onnxruntime as ort def fingerprint(model, feeds): so = ort.SessionOptions() so.enable_profiling = True sess = ort.InferenceSession(model, sess_options=so, providers=["CUDAExecutionProvider"]) for _ in range(30): sess.run(None, feeds) prof = json.load(open(sess.end_profiling())) node_ms = {} for ev in prof: if ev.get("cat") == "Node": node_ms[ev["name"]] = node_ms.get(ev["name"], 0) + ev["dur"] top = sorted(node_ms.items(), key=lambda x: -x[1])[:5] return {"top": top, "total_ms": sum(node_ms.values()) / 1000}
指纹库的演进就是团队的性能资产:谁优化了什么、提升了多少、什么时候回归的,全有记录。这比"记得上次好像调过"可靠得多。
Profile 与系统 trace 联合
ORT 的 JSON 只覆盖图内节点,瓶颈有时在进程级:CUDA 同步等待、内存分配器锁、线程切换。把 ORT trace 与系统 trace 对齐(Windows 的 ETW、Linux 的 perfetto)能看到完整时间线:哪些等待是图内的,哪些是图外的。联合分析的一个典型发现是"GPU 空闲率高但延迟高"——问题不在计算,在 host 端 launch 与同步。
常见误区速查
| 误区 | 后果 | 正确做法 |
|---|---|---|
| 用单次 run 当结论 | 噪声误导 | warmup + 多次取百分位 |
| 只看均值 | 掩盖长尾 | P50 与 P99 一起看 |
| profile 开着上线 | 性能掉 | 完事即关 |
| 换参数不重测 | 无法归因 | 每次一变量 |
| 只测 CPU 不上 GPU | 部署翻车 | 目标 EP 必测 |
下一节:把调参沉淀为 SessionOptions 策略。
常见瓶颈排查清单
当推理时延不符合预期时,按以下顺序排查:
- 是否为算子调度问题:查看各节点耗时分布,单个算子占比超过 30% 优先看它;连续小算子堆积则关注图优化是否生效
- 是否受限于数据拷贝:检查输入输出的 dtype/内存布局,Host↔Device 拷贝常被 profiling 报告单独列出,占比高时改用异步拷贝或预分配缓冲
- 是否受限于线程/并发:CPU 推理看线程数是否匹配核数,IO 密集场景看是否可流水线并行
- 是否受限于批处理:小 batch 下框架开销占比高,可尝试动态 batch 或并发实例
# profile_check.py —— 打印每个节点的耗时占比(示意) import onnxruntime as ort sess = ort.InferenceSession("model.onnx", providers=["CPUExecutionProvider"]) prof = sess.run_with_profiler(["output"], {"input": x}) # 读取 session 输出目录下的 profile 文件,解析各节点 exec 时间
一份好的 profiling 报告应该回答三个问题:瓶颈在哪个阶段、是计算型还是拷贝型、优化后预期收益多少。带着问题做优化,比盲目调参数高效得多。