6.2 SessionOptions 调优参数
6.2 SessionOptions 调优参数
本节摘要:graph_optimization_level、execution_mode、线程、mem_pattern、CUDA/TRT 专有选项构成超大搜索空间(合法组合可达 10^12 量级)。工程上应打包为命名策略(low_latency_edge、cloud_gpu_fp16),写入 metadata 或 CI 模板。
参数组合爆炸下的策略化
前四章涉及的 SessionOptions 参数彼此独立:graph_optimization_level 有 3 档、execution_mode 有 2 种、线程数有几十档、EP 专有选项有十几个。理论组合数轻松超过 10^12——逐个试既不现实,也没意义。工程正解是策略化:把一组经过验证的参数打包成命名策略(如 low_latency_edge、cloud_gpu_fp16),策略作为配置单元流转,而不是散落的魔法数。
同一模型换 ORT 小版本 P99 漂移——可能是 LayerNorm 被拆算子 或 默认 conv algo 变了。参数应版本化,而非散落在代码魔法数里。策略文件的另一个价值就在这:参数随版本可 diff、可回滚。
跨 EP 通用参数
| 参数 | 典型值 | 说明 |
|---|---|---|
| graph_optimization_level | EXTENDED | 融合强度 |
| execution_mode | SEQUENTIAL | GPU 低延迟 |
| intra_op_num_threads | 物理核 | CPU EP |
| enable_mem_pattern | True | 静态 shape |
| enable_profiling | False | 生产关闭 |
五个通用参数覆盖图优化、调度、线程、内存、可观测性五个维度,是所有 EP 的共同底座。先定这五个,再谈 EP 专有选项。
CUDA 与 TensorRT 专有选项
CUDA EP 示例:
cuda_opts = { "device_id": 0, "cudnn_conv_algo_search": "HEURISTIC", # 或 EXHAUSTIVE 首帧慢 "arena_extend_strategy": "kSameAsRequested", } providers = [("CUDAExecutionProvider", cuda_opts)]
TensorRT:
trt_opts = { "trt_fp16_enable": True, "trt_int8_enable": False, "trt_max_workspace_size": 2147483648, }
cudnn_conv_algo_search 决定卷积算法搜索策略:HEURISTIC 启发式快,EXHAUSTIVE 逐个试最优但首帧慢到分钟级;arena_extend_strategy 控制显存扩容;TRT 的 trt_max_workspace_size 决定编译期能用的临时显存,影响融合能力。这些选项都是"EP 本地语言",放进策略包时要标注适用 EP。
策略包的组装
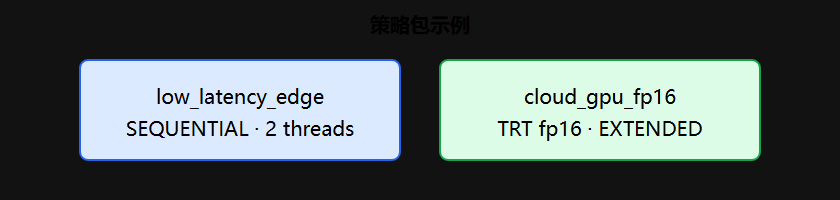
low_latency_edge = { "execution_mode": "SEQUENTIAL", "graph_optimization_level": "ORT_ENABLE_EXTENDED", "intra_op_num_threads": 2, "inter_op_num_threads": 1, "memory_limit_mb": 512, } cloud_gpu_fp16 = { "execution_mode": "SEQUENTIAL", "graph_optimization_level": "ORT_ENABLE_ALL", "intra_op_num_threads": 1, "inter_op_num_threads": 1, "enable_mem_pattern": True, "providers": [("TensorrtExecutionProvider", {"trt_fp16_enable": True}), ("CUDAExecutionProvider", {})], }
策略包声明 + providers 组合 = 一个完整的部署配置单元。策略名进 metadata_props,部署时按名字拉取,CI 按名字回归:
场景化策略表
| 场景 | 策略要点 | 备注 |
|---|---|---|
| 云 GPU 低延迟 | SEQUENTIAL + ALL + TRT FP16 | 缓存 engine |
| CPU 批处理 | PARALLEL + intra=核数 | 看多分支 |
| 边缘 INT8 | BASIC 优化 + INT8 模型 | 先验精度 |
| Windows 桌面 | DML + SEQUENTIAL | 免 CUDA |
| 吞吐敏感 | PARALLEL + 大 batch | Profile 验证 |
判断直觉与常见误区
⚠️ Provider 选项对 CPU 无效的项(如 arena_extend_strategy 在 CoreML 上被忽略)应分 EP 文档维护——把 CUDA 的选项写进 CPU 策略,配置看起来生效,实际毫无作用,还误导排查。
💡 策略即接口,参数即实现。团队之间只传策略名,不传参数表;改参数走 PR,回滚走策略版本。
本章回顾
- 参数组合爆炸 需策略打包
- CUDA conv algo 影响首帧,生产用 HEURISTIC
- TRT workspace 影响融合能力
- metadata 可携带策略 id
- 通用与 EP 专有参数分开管理
- 策略随版本可 diff、可回滚
策略的生命周期管理
策略包不是写死一次,它有完整生命周期:定义(验证过的参数组合)→ 发布(随模型版本)→ 灰度(部分流量)→ 回滚(性能回归时)。实现上不复杂,关键是策略名进 metadata,参数表进仓库:
import onnxruntime as ort POLICIES = { "low_latency_edge": { "execution_mode": "ORT_SEQUENTIAL", "graph_optimization_level": "ORT_ENABLE_EXTENDED", "intra_op_num_threads": 2, "inter_op_num_threads": 1, }, "cloud_gpu_fp16": { "execution_mode": "ORT_SEQUENTIAL", "graph_optimization_level": "ORT_ENABLE_ALL", "providers": [("TensorrtExecutionProvider", {"trt_fp16_enable": True})], }, } def apply_policy(policy_id, model_path): cfg = POLICIES[policy_id] so = ort.SessionOptions() so.graph_optimization_level = getattr( ort.GraphOptimizationLevel, cfg["graph_optimization_level"]) # ... 逐项映射到 SessionOptions return ort.InferenceSession(model_path, sess_options=so)
策略灰度:用 metadata 里的 policy_id 区分流量,观察 P99 与错误率后再全量。回滚就是改回上一版 policy_id,一条配置的事,而不是回滚代码。
参数与 ORT 版本的绑定
同一策略在不同 ORT 版本下行为可能不同(新增参数、默认值变化)。策略文件里记录"验证过的 ORT 版本",CI 升级 ORT 时先跑策略兼容性测试:
| ORT 版本 | 策略兼容性 | 备注 |
|---|---|---|
| 1.16 | 全部策略 | 基线 |
| 1.17 | 需重测 conv_algo | 默认算法变 |
| 1.18 | 需重测 TRT 选项 | 参数名变化 |
升级流程:新版本上重跑性能指纹 → 参数映射表 diff → 不兼容的参数显式处理 → 通过后才允许线上切换。版本升级的性能回归,第6章 6.3 的 CI 门禁会兜底。
下一节:部署模式与 CI 门禁。
线程与内存配置的权衡
SessionOptions 提供一组影响吞吐与延迟的参数,它们之间存在耦合:
| 参数 | 作用 | 权衡 |
|---|---|---|
| intra_op_num_threads | 单算子内并行线程 | 过大导致线程竞争,过小浪费多核 |
| inter_op_num_threads | 算子间并行度 | 流水线化多算子,但增加调度开销 |
| execution_mode | 顺序/并行执行 | 并行适合多输入,顺序适合单路低延迟 |
| enable_mem_pattern | 内存复用模式 | 关闭可减少内存但降低缓存友好性 |
| graph_optimization_level | 图优化力度 | 级别越高启动越慢,运行时收益越大 |
经验法则:CPU 推理把 intra 线程设为物理核数(或减一),inter 设为 1~2;GPU 推理线程参数影响较小,重点放在 CUDA EP 的 arena 内存配置与模型加载时的 session 复用。
# session_options.py —— 典型配置示例 import onnxruntime as ort so = ort.SessionOptions() so.intra_op_num_threads = 8 so.inter_op_num_threads = 2 so.execution_mode = ort.ExecutionMode.ORT_SEQUENTIAL so.graph_optimization_level = ort.GraphOptimizationLevel.ORT_ENABLE_ALL sess = ort.InferenceSession("model.onnx", sess_options=so, providers=["CPUExecutionProvider"])
调优时用控制变量法:一次只改一个参数,记录 P50/P99 延迟与吞吐,避免参数间相互掩盖。