6.3 部署模式与 CI 实践
6.3 部署模式与 CI 实践
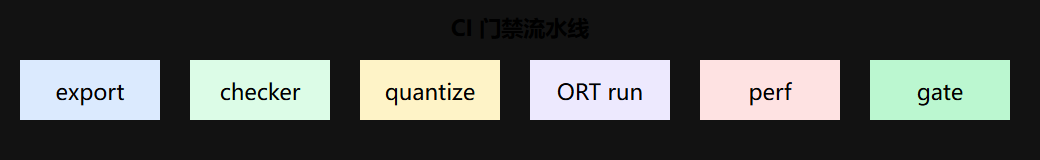
本节摘要:云/边/端部署差异不在算力大小,而在冷启动、隔离与隐私约束。CI 应对 ONNX 导出、checker、ORT 试跑、精度/延迟指纹与 EP 版本做门禁,并用 contract_hash 追踪模型-ORT-EP 四维版本矩阵,防止语义漂移。
一次 ORT 升级引发的线上事故
PyTorch 2.0 升级后线上误拒率飙升——原因是 ORT 升级改变了 Where 算子 NaN 传播 行为(SOURCE 8.3 类金融案例)。仅测精度不够,须 锁版本 + 契约 hash。这个案例说明部署的敌人是"无声的语义漂移":版本一换,某个算子的边界行为变了,离线指标没测到,线上直接爆发。
云边端三种部署模式
| 模式 | 约束 | ORT 关注点 |
|---|---|---|
| 云 GPU 服务 | 冷启动可分钟级、强隔离 | TRT engine 缓存、多租户 Session |
| 边缘盒子 | 内存≤GB、毫秒响应 | INT8、DML/CoreML |
| 端侧本地 | 隐私、离线 | 小体积 ORT build、CPU/ANE |
三者的差异不在算力,而在信任模型:云服务可接受秒级冷启动,换来全精度与强隔离;边缘盒子要毫秒响应且内存受限,量化与轻量 EP 是刚需;端侧本地要离线可用,模型必须内置、体积最小化。对应到工程动作:云服务做 engine 缓存与 Session 池化;边缘做 INT8 与内存规划;端侧做裁剪 build 与模型加密。
多框架导出统一汇入 ORT
多框架导出统一汇入 ORT(SOURCE 8.1):
| 来源 | 工具 |
|---|---|
| PyTorch | torch.onnx.export |
| TensorFlow | tf2onnx |
| sklearn | skl2onnx |
统一汇入的好处是后端只需维护一套推理栈。导出侧的工具差异(tracer 行为、opset 默认值)在 CI 里用同一套门禁消化。
Model Service Contract
Model Service Contract 思路:在 metadata 声明 input shape、最大显存、P95 延迟、INT8 容忍度,CI 自动比对。契约把"部署应该满足什么"写进模型本身,而不是散落在部署文档里。
# 嵌入 custom_metadata_map 便于追踪 import onnx m = onnx.load("model.onnx") meta = m.metadata_props.add() meta.key = "ort_min_version"; meta.value = "1.17.0" meta2 = m.metadata_props.add() meta2.key = "policy_id"; meta2.value = "cloud_trt_fp16_v2" meta3 = m.metadata_props.add() meta3.key = "p95_latency_ms"; meta3.value = "15" meta4 = m.metadata_props.add() meta4.key = "int8_tolerance"; meta4.value = "0.01" onnx.save(m, "model.onnx")
metadata 里写入"最低 ORT 版本 + 策略 id + 性能契约",CI 就能在模型层面自证:版本不够拒绝发布,指标超限拒绝发布。
CI 最小门禁清单
- opset 与 ORT 版本矩阵文档化
- FP32 vs INT8 输出 allclose 阈值
- perf_test P99 相对基线 ±X%
sess.get_providers()与目标 EP 一致- 升级 ORT 时重跑全量门禁
# ci 门禁示意(伪配置) # stage1 export: torch.onnx.export + onnx.checker.check_model # stage2 run: ORT 试跑双 shape,get_providers 断言目标 EP # stage3 perf: onnxruntime_perf_test P99 vs 基线 ±5% # stage4 quant: INT8 精度 allclose 阈值 # stage5 contract: metadata 版本/策略/指标比对
门禁设计原则:CI 用的 EP 必须贴近生产。用 CPU EP 通过、生产 CUDA 失败,等于 CI 形同虚设。
判断直觉与常见误区
⚠️ CI 用 CPU EP 通过,生产 CUDA EP 失败——CI 须含目标 EP 或同等 smoke。EP 差异是语义级的,CPU 的"能跑"不能推断 CUDA 的"能跑"。
💡 版本四维(模型/opset/ORT/EP)任一变动都触发完整回归。任何一维变化都可能改变算子行为,别做"只改一行没影响"的假设。
工程实践要点
- Triton / Azure ML 等托管 ORT 时,engine/plan 与模型同仓库存储
- Windows 服务:DmlExecutionProvider + 签名 DLL
- 持续集成扩展为 CI/MD(Model Drift Detection)监控线上分布偏移
- 升级 ORT 时先跑全量门禁再发布,禁止跳过
要点串联
- 云边端 信任模型不同,EP 选型不同
- CI = export + checker + run + perf + 精度
- contract_hash / metadata 防语义漂移
- CI EP 须贴近生产
- ORT 升级必做全量回归
- 性能与精度双指纹进 CI,优化可回滚
部署前检查清单
无论云边端哪种模式,上线前过一遍九项检查,能拦下绝大多数事故:
get_providers()与目标 EP 一致- 模型 metadata 含 ort_min_version 与 policy_id
- Session 池已复用,无每请求新建
- profiling 与 verbose 日志已关闭
- 显存预算有 manifest 记录
- engine 缓存路径已挂载(TRT)
- INT8/FP16 精度验收报告已归档
- 性能指纹基线已入库
- 回滚方案明确(策略版本 + 模型版本)
# 上线前 smoke:目标 EP 跑通 + 关键指标记录 python smoke.py --model model.onnx --ep tensorrt \ --expect-p99 15 --warmup 30 --runs 100
事故复盘模板
线上出问题不可怕,怕的是归因错误。复盘五问:版本是否变动(模型/opset/ORT/EP 四维)?Profile 与基线差多少?日志与 trace 是否留存?灰度范围有多大?回滚耗时多长?五问闭环后把结论写进契约与 CI,防止复发。
版本矩阵的追踪实现
四维版本(模型/opset/ORT/EP)的追踪靠 metadata 与仓库双写:模型文件里写 version,仓库里写部署记录,CI 每次发布生成一条不可变的 manifest:
# 发布 manifest 片段(JSON) { "model_hash": "sha256:...", "opset": 17, "ort_version": "1.17.0", "ep": "tensorrt", "policy_id": "cloud_trt_fp16_v2", "p99_ms": 12.8, "released_at": "2025-01-15" }
任何一次"线上表现异常"的排查,都从拉取当前 manifest 开始——先确认跑的是不是预期组合,再谈性能与精度。
本教程六章构成 ORT 从导出到部署的完整排查链;遇问题按「图是否合法 → EP 是否接管 → 内存/线程 → 量化 → Profile → 版本契约」顺序倒查。
CI 集成与回归防护
把模型性能纳入 CI 是防回归的关键。推荐流程:
- 每次模型变更触发量化/优化构建,产出一份性能基线
- 对比基线:延迟增长超过 10% 或精度下降超过阈值则阻断合并
- 固化测试环境:容器镜像锁定推理引擎版本与硬件驱动,保证对比可复现
# ci-pipeline.yml —— 性能回归检查示意 check-inference: stage: test script: - python build_optimized_model.py - python run_benchmark.py --baseline baseline.json - python check_regression.py --threshold 0.10 artifacts: paths: [benchmark_report.json]
部署模式选择:在线服务优先常驻 Session 并复用线程池;离线批处理可一次性建 Session 处理完即释放;边缘设备要显式控制内存上限并预热。三者共享的教训是:性能数据必须来自生产配置,测试机与生产机的 CPU 型号不同会让所有结论失真。