3.1 运行时核心 API 体系
3.1 运行时核心 API 体系
本节摘要:Runtime 的主干由四个对象构成——Core 管设备与插件、Model 是网络描述、CompiledModel 是面向设备的可执行体、InferRequest 承载单次推理。本节讲清四者的生命周期与线程安全边界,并给出第一个完整的推理程序骨架。
第 2 章结束时,我们手里有了一份合法的 IR。第 3 章的任务是让它真正跑起来、跑得明白。这一节先立骨架:四个核心对象谁生谁、谁活多久、谁能被几个线程同时摸。这些边界问题在单机演示里看不出来,上了多线程服务才发现踩线,代价就大了——所以本节宁可先讲契约,再给代码。
四个对象,一条生命周期
先看它们怎么接力。Core 是入口,启动时按需加载设备插件,回答「有哪些设备、各自什么能力」;read_model 产出 Model,它只是网络描述,与任何设备无关;compile_model 把 Model 和某个设备绑在一起做编译,产出 CompiledModel——图优化、内存规划、内核选择都发生在这一步,所以它慢,且产物不能跨设备复用;create_infer_request 从编译产物里领出 InferRequest,它持有输入输出张量,是真正执行推理的对象。
图 3-1 核心对象生命周期与所属阶段
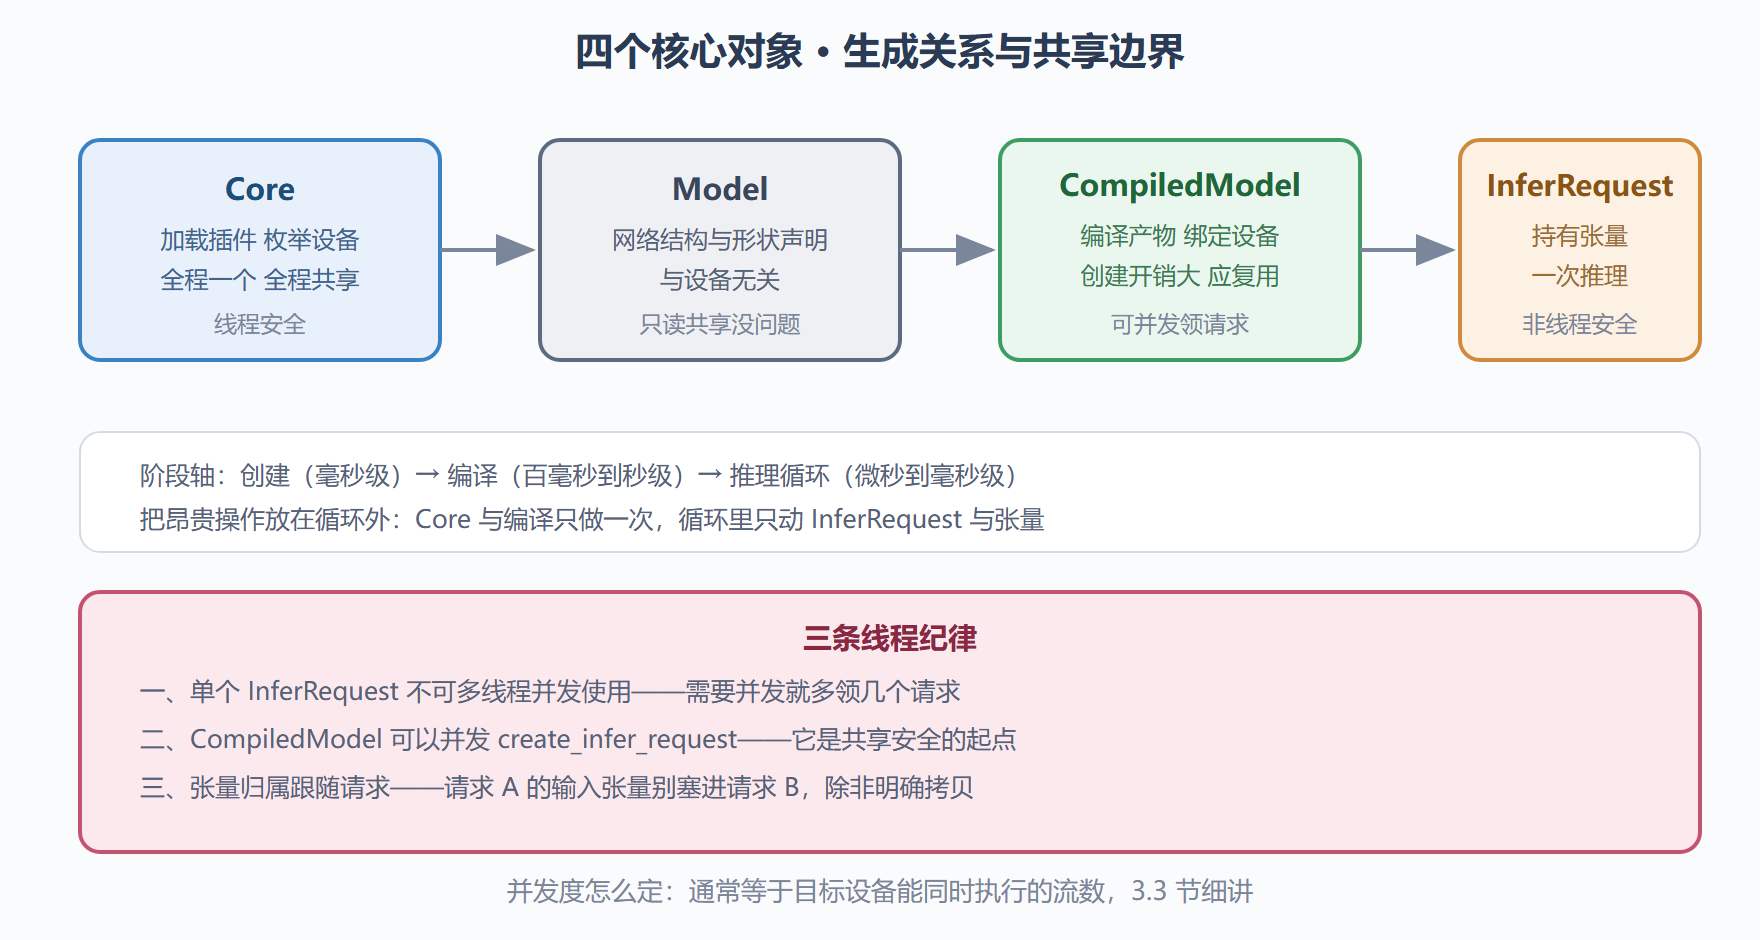
生命周期纪律可以浓缩成一句:把贵的留在循环外,把便宜的放进循环里。创建 Core 便宜,编译贵,领请求中等,单次推理最快。服务启动时把前三步做完,请求循环里只做「填张量、跑推理、取结果」,性能架子就搭对了。反过来,每来一帧就重新编译一次模型的做法,性能报告会难看得让人怀疑人生。
第一个完整骨架
概念落成代码,一个最小但姿势正确的推理程序长这样:
import openvino as ov import numpy as np core = ov.Core() # 1. 创建运行时 model = core.read_model("classifier.xml") # 2. 读模型 compiled = core.compile_model(model, "CPU") # 3. 编译到设备 request = compiled.create_infer_request() # 4. 领请求 x = np.random.random((1, 3, 224, 224)).astype(np.float32) input_tensor = ov.Tensor(x) request.infer(input_tensor) # 5. 同步推理 out = request.get_output_tensor().data # 6. 取结果 print(out.shape)
六步里只有第五步该出现在热路径上。张量也可以不显式构造,直接把 numpy 数组传给 infer——运行时会按形状与类型声明做匹配,不匹配时抛出带具体维度信息的异常,这类异常信息的读法是 7.2 节排错清单里的常客。
属性系统:面向设备的每一问都有答案
编译前后都可以向对象提问。设备能力用 Core 的属性接口查(1.3 节演示过);编译产物的形状、输入输出张量布局用 CompiledModel 查;性能模式、流数这类运行期配置,则通过编译参数传入——3.3 节的调度策略全部经由这套属性系统落地。属性的意义在 1.1 节说过:契约式 API。每一次「系统替你做了决定」都被记录成一个可查询的属性,性能分析时这些属性就是现场证据。
有一个容易忽略的点:同一份 Model 可以编译到多个设备,得到多个独立的 CompiledModel,各自持有各自的优化产物。CPU 一份、核显一份,按负载状况分流——这正是第 6 章服务化部署里多设备分流的实现基础。
一次生命周期错位的性能事故
把生命周期纪律用一个事故讲实。某服务的性能压测结果只有预期的三分之一,工程团队的第一反应是换设备、加机器。会诊时先看代码结构,十分钟后就找到了病灶:服务的每个请求处理函数里都在执行「读模型、编译、推理」三连——也就是说,每一个 HTTP 请求都完整付了一次编译的钱,而编译耗时是推理本身的十几倍。修复把三连拆开:编译挪到服务启动,请求处理只领请求与推理,压测数字立刻回到预期。
这单事故的细节值得回放:为什么它没在开发期被发现?因为开发期用的是单条测试请求,「每次编译」的浪费被绝对延迟掩盖了;压测把并发放大后,重复编译把 CPU 打满,瓶颈才现形。教训写成一条通用检查项:性能不达标的第一个动作是看代码里 compile_model 出现的位置——它应该只出现在服务启动路径上,任何出现在请求处理路径里的编译都是事故。
对象池:并发服务的标准形态
顺着请求并发再往前一步。固定并发数的服务(比如处理两路视频、八个并发请求),推荐的对象形态是「请求池」:启动时一次性创建 N 个 InferRequest,请求到来时从池里取、用完归还。池化避免了频繁创建销毁的开销,更重要的是把并发度变成了显式配置——池的大小就是服务的并发上限,超出即排队,系统行为可预期。第 6 章服务化清单里「并发度与设备流数对齐」那一项,落地形态就是请求池。
池化的两个伴生细节:其一,池中每个请求各持独立的输入输出张量,互不共享(3.2 节的张量归属规则);其二,请求归还前要把状态清理干净——异步请求必须确认等待完成后才能复用,带着未完成的异步状态归还是并发场景的经典 bug。把这两个细节写进池的实现注释,后来者会感谢你。
错误处理的姿势
最后补错误处理。属性契约的另一面是异常会精确指向契约违约点:形状不符的异常会带两侧的具体维度,设备不可用的异常会带设备名。配套的正确姿势是让异常早抛、上层处理:推理组件内部不要吞异常返回默认值——静默的默认值会把「设备没编上」变成「结果全错」,把配置问题伪装成精度问题。服务层统一兜底:捕获、记日志(带属性快照)、降级或重试。这套分工让排错时的第一现场保持完整,是第 7 章排错效率的底层保障。
三个高频追问
对象体系收尾,回答三个高频追问。追问一:Core 应该建几个?通常一个进程一个——它只管设备与插件,重复创建不带来隔离只带来开销;确实需要隔离的场景(比如不同业务线独立配置)按进程边界隔离,别在进程内造多个 Core。追问二:编译产物可以缓存到磁盘吗?设备内核缓存在多数设备插件上可用,重启服务免二次编译,对「启动速度敏感、模型固定」的服务值得开启;注意缓存与设备驱动版本绑定,驱动升级后旧缓存会失效重建,属于正常现象。追问三:同一模型编译到两个设备,两张 CompiledModel 会互相影响吗?各自独立——各自的图优化、内存、请求互不干扰,这正是多设备分流(第 6 章)的物理基础;唯一要管的是设备总资源,两张产物吃的是两份显存或两份主机内存。三个追问的共同答案:对象边界即资源边界,边界清楚了,架构题就变成了配置题。
本节要点回顾
- 四对象接力:Core 管设备、Model 是图纸、CompiledModel 是产线、InferRequest 是工单。
- 昂贵操作出循环:编译只做一次,请求可复用,热路径上只留张量与推理。
- 线程纪律三条:请求级不并发、编译产物可共享领请求、张量不跨请求乱用。
- 属性即证据:所有运行期决策都可查询,为第 7 章的性能归因留了现场。
对象体系立住了,下一节钻进执行时最深的暗层——张量内存从哪来、到哪去,零拷贝的边界在哪里,预处理为什么值得搬进流水线。