3.3 推理模式与调度策略
3.3 推理模式与调度策略
本节摘要:同步与异步解决「线程等不等」,性能提示解决「按延迟还是按吞吐优化」,多设备模式解决「负载给谁」。本节把三层调度决策拆开讲清,并给出从单一同步调用演进到流水线服务的完整路径——这是第 3 章的落点,也是第 6 章服务化部署的技术底座。
前两节把对象与内存讲完,这一节回答「怎么跑」。调度决策分三层:调用层选同步还是异步;优化层声明延迟优先还是吞吐优先;设备层决定单设备还是多设备协同。三层互相独立又彼此牵制,一次把三层想清楚,后面的性能工作就有了章法。
第一层:同步与异步,是线程时间的归属问题
同步调用 infer() 的语义是当前线程守到结果返回为止。它逻辑直白、排错直观,单次交互场景(点一下按钮处理一张图)完全够用。问题出在持续负载:视频流 30 帧每秒、单帧推理 25 毫秒,同步模式下主线程每帧干等 25 毫秒,解码、后处理全部串行排队——设备的空窗与线程的空转同时发生。
异步调用 start_async() 把控制权立刻还给你,推理在后台推进,wait() 或回调负责收割结果。这样解码下一帧、处理上一帧的结果与当前推理三者重叠,单帧实际耗时不降,但每秒能处理的总帧数显著上升。异步不改模型、不改设备,只改时间线的组织方式,是流水线服务的地基:
# 异步骨架:提交后先干活,收割前再等待 request.start_async(input_tensor) do_other_work() # 解码下一帧或后处理上一帧 request.wait() result = request.get_output_tensor().data
回调模式是异步的变体:注册回调函数,推理完成自动触发。它省掉轮询,但回调线程与应用线程的同步责任落在你自己肩上——回调里别做重活,把结果丢回主队列处理是更稳的姿势。
第二层:性能提示——延迟优先还是吞吐优先
编译时的性能提示(performance hint)让运行时按目标自动配置内部参数。延迟优先模式压缩单请求路径:少开流、复用缓冲,把首结果时间压到最低;吞吐优先模式反其道而行:多流并发填满设备,单位时间总处理量最大,单请求延迟反而让步。
一个直观的对照:同样的模型、同样的 CPU,延迟模式下单请求约 8 毫秒、并发能力约两路;吞吐模式切到四流后单请求升到 14 毫秒,总吞吐却接近翻倍。哪个正确取决于业务问的是「这一帧多快回来」还是「一秒能处理多少帧」——视频墙选后者,交互式助手选前者。流数不必手工指定,提示模式下运行时按设备探测自动配置;确有特殊需要时再手工覆盖流数参数,覆盖前先用 benchmark_app 验证(第 7 章演示完整方法)。
图 3-3 三层调度决策与典型组合
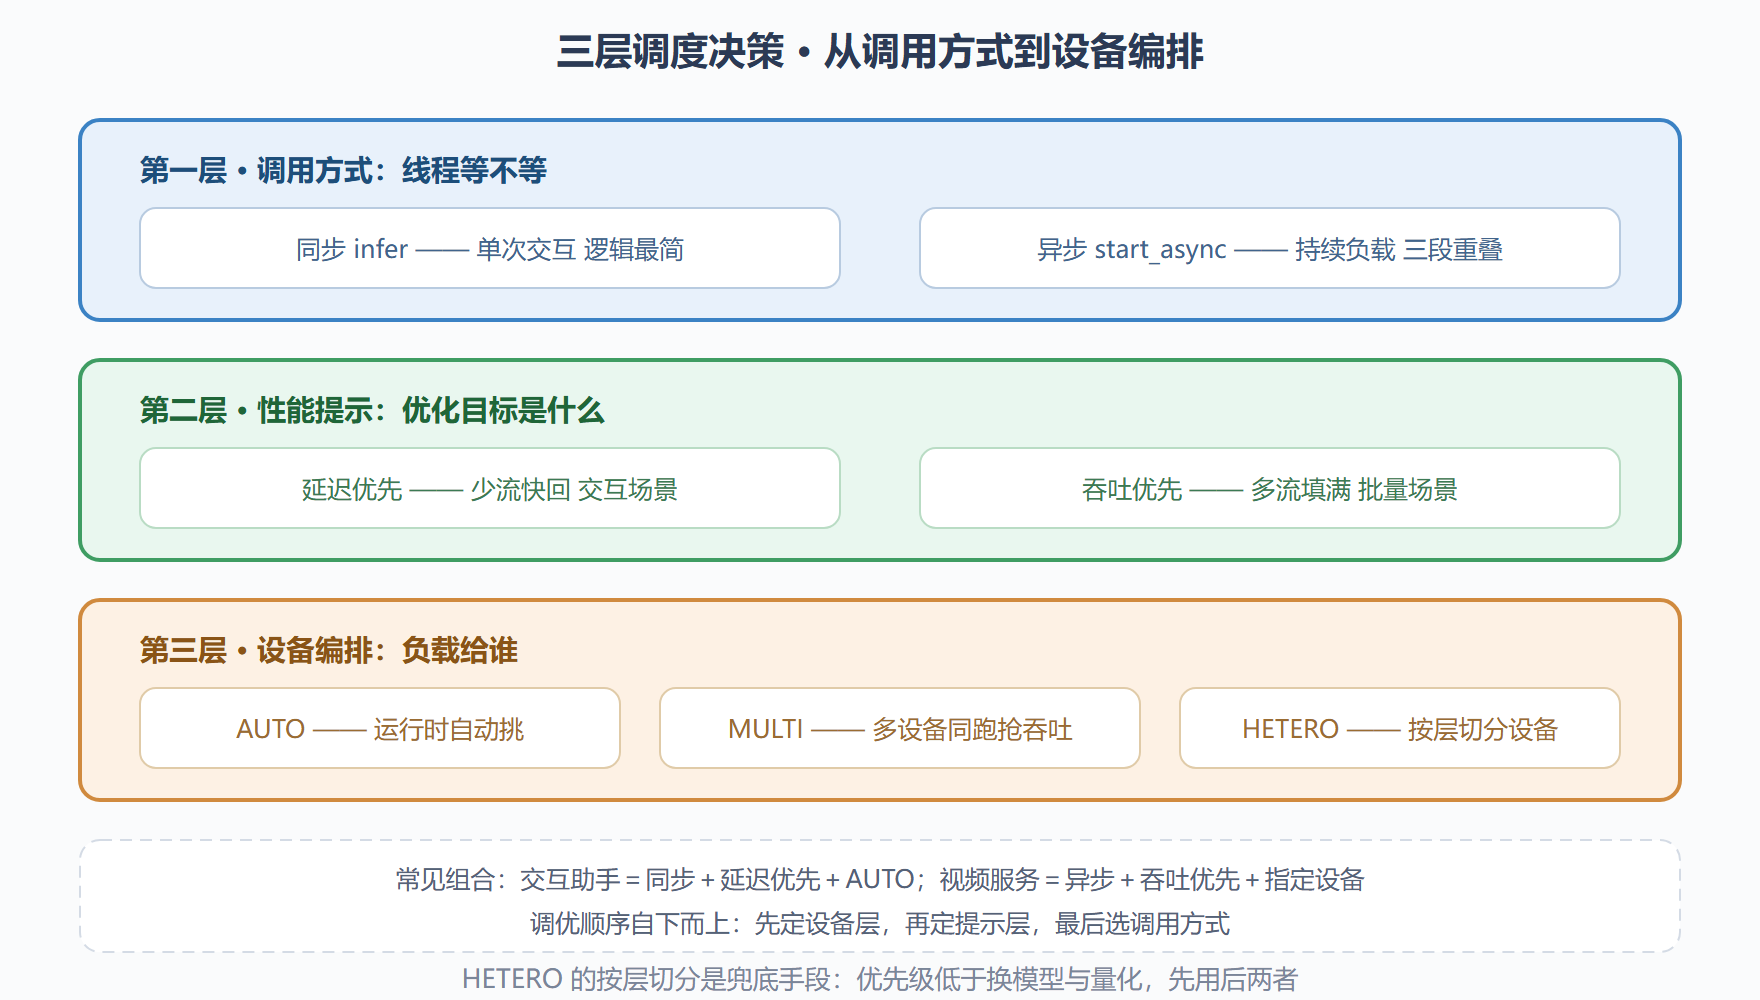
第三层:多设备编排的三个模式
AUTO 模式把设备选择交给运行时:按模型与负载特征在可用设备里挑一个,启动期可能多次切换直到稳定。它最适合「不知道该跑哪」的通用发布包——一份产物发到各种机器,各自落到合适设备。代价是首请求延迟可能波动,延迟敏感的服务上线前最好固定设备并实测。
MULTI 模式把多个同类设备编成一队抢吞吐:请求轮流分发,多块显卡合力吃流量。适合批处理与高并发服务。HETERO 模式按层切分:个别算子某设备不支持时,把这部分层落到 CPU、其余留在主力设备。它是兼容性兜底,不是性能手段——层间切换有搬运开销,能用量化或换模型解决的算子缺口,别习惯性依赖 HETERO。
异步改造成的一次完整前后对照
调度三层的实战价值,用一次异步改造的前后对照来说明。改造对象是一条单路视频检测服务:同步版每帧处理耗时 32 毫秒,其中推理 14 毫秒、解码与预处理 11 毫秒、后处理 7 毫秒——串行执行,帧率约 31 帧。改造动作只有两处:解码线程与推理线程分离,推理换 start_async 加 wait 的双缓冲骨架。改造后整体帧率升到 48 帧——推理的 14 毫秒被解码与后处理完全掩盖,串行路径从 32 毫米压缩到「最长段加同步开销」。
数字之外的两个细节更有价值。其一,改造后帧率没有到理论值(1 除以最长段 11 毫秒约 90 帧),因为队列同步与张量写入有开销——流水线收益以「最长段」为地板,而不是归零,预估收益时用最长段算,不用总时长算。其二,改造暴露了后处理的线程安全 bug:后处理里的统计字典被两个线程并发写,改造前单线程没事,改造后偶发崩溃。这印证了 7.2 节要说的话:异步化的成本不在代码,在「单线程假设」悄悄散落的每个角落。
性能提示的两条误用与纠正
提示机制简单,误用却集中。误用一:用吞吐模式跑延迟验收。团队为了压测数字好看把提示切成吞吐,单请求延迟劣化后又在验收时解释「平均吞吐达标」——业务要的是每次都快,不是平均快。纠正:提示与业务指标一一对应,验收指标是什么,提示就配什么。误用二:手工流数压过提示。有人发现手工设流数参数比提示的效果「更好」,就四处复制这个魔数——换设备后魔数失效甚至反噬。纠正:提示是设备自适应的入口,手工参数只应在「提示确实不适合」且经过实测的场合使用,并注明适用环境。
多设备模式的实测口诀
三个模式的适用边界,补一组实测口诀帮助记忆。AUTO 问「在哪跑」,适合通用发布与开发期,生产环境延迟敏感时固定设备;MULTI 问「一起跑」,多块同类设备吞吐线性扩展的场合用它,注意它不减少单请求延迟;HETERO 问「分工跑」,只处理「主力设备有算子缺口」的兼容场景,用完要对照逐层耗时确认切分代价可接受——层间数据搬运的成本经常比想象中大。三句口诀各配一个否决项:延迟敏感别用 AUTO 裸上线、单请求延迟问题别指望 MULTI、性能问题别拿 HETERO 当优化。口诀背后是同一个原则:每个模式为特定问题而生,拿它治别的病,药费比病贵。
三个高频追问
调度话题收尾,回答三个高频追问。追问一:异步请求同时挂几个合适?经验起点是设备流数(延迟模式一两个、吞吐模式按提示自动),再按「提交侧生产率」微调——挂太多只是排队,不增吞吐反增内存;用 7.1 章的基准工具扫一遍并发档位,曲线拐点就是答案。追问二:性能提示能运行时切换吗?提示在编译时生效,切换等于重新编译——高频切换的场景把两个提示各编译一份产物,按负载在产物间切换,比反复编译便宜得多。追问三:批处理什么时候值得用?端侧场景多数不划算——凑批的等待抵消了批量收益,只有「请求天然成批」(离线转写一批图、定时批量评分)才直接受益;在线服务凑批是服务端框架的活,与第 6 章的排队设计合流。三个追问的共同提示:调度的最优解都在「实测曲线」里,不在经验教条里——本章给的是画曲线的坐标轴,不是曲线本身。
无论最终选了哪套组合,把最终生效的调度配置——调用方式、性能提示、设备目标、流数——写进服务的部署档案。它是这条产线的驾驶手册:排错时拿来对照配置漂移,复测时拿来对齐基准参数,交接时拿来省半小时口头交代。三层调度的所有决策,最终都应该落在这一份可查的档案里。
本节要点回顾
- 调度分三层:调用方式管线程等待、性能提示管优化目标、设备编排管负载归属。
- 异步是流水线地基:提交、执行、消费三段时间重叠,吞吐提升不改模型不换设备。
- 性能提示二选一:延迟优先压首结果时间,吞吐优先拉总处理量,按业务指标定。
- AUTO 通用、MULTI 抢吞吐、HETERO 兜底:兜底手段别当性能工具用。
三层决策配好,Runtime 的核心机制就走完了。第 4 章转入优化主题:模型太大、推理太慢的第一板斧——量化压缩,以及它的代价管理。