4.1 模型量化技术
4.1 模型量化技术
本节摘要:量化把浮点权重与激活映射成低比特整数,换存储、带宽与算力三重收益,代价是精度风险。本节讲清量化参数的直觉含义、训练后量化与量化感知训练的分界、NNCF 的标准工作流,以及哪些模型天生好压、哪些要小心。
第 3 章把调度调顺了,这一章开始动模型本身。优化三板斧的第一斧是量化——成本最低、见效最快,也是坑最多的一斧。它的本质是一门「精度换性能」的生意:先弄清自己愿意支付多少精度、能换回多少性能,再用工具把交易做实。本节给的是交易框架,4.4 节会拿一单真实的「翻车与修复」复盘。
量化的直觉:刻度变粗了
浮点数在硬件里是一份昂贵的契约:存储多、带宽大、计算单元贵。量化做的事是换一套便宜的记账方式——用一组刻度均匀(或近似均匀)的整数去逼近原来的浮点分布。逼近需要两个参数:缩放因子决定一个整数刻度代表多大的浮点区间,零点声明浮点零落在哪个整数上。有了这组参数,任意浮点值都能四舍五入成整数存储,计算时再展开回来。
误差从哪来也就清楚了:刻度粗了,落在两个刻度之间的值就产生舍入误差。误差是否可接受,取决于模型对微小扰动的敏感度——这正是同样压到 INT8,有的模型纹丝不动、有的模型精度崩盘的原因。卷积类视觉模型普遍皮实,注意力占比高的大模型与对数值敏感的小目标检测头要格外小心。
两条路线:训练后量化与量化感知训练
**训练后量化(PTQ)**拿训练好的模型直接压,用一小批有代表性的数据(通常几百到几千条)统计各层激活的分布,算出缩放参数。不需要训练管线、不需要标签,几十分钟出结果,是默认起点。
**量化感知训练(QAT)**在训练或微调过程中插入伪量化节点,让模型在训练时就去适应量化误差。精度恢复能力远强于 PTQ,但需要完整训练管线、原始数据与训练算力,周期以天计。
决策标准一句话:PTQ 先试,掉点在容忍内就收工;超了再看差距大小——差零点几个点,试调校准集与排除敏感层;差出一片,才值得上 QAT。跳过 PTQ 直接 QAT 是常见的资源浪费,除非业务明确要求极限精度。
图 4-1 训练后量化的工作流与验收闭环
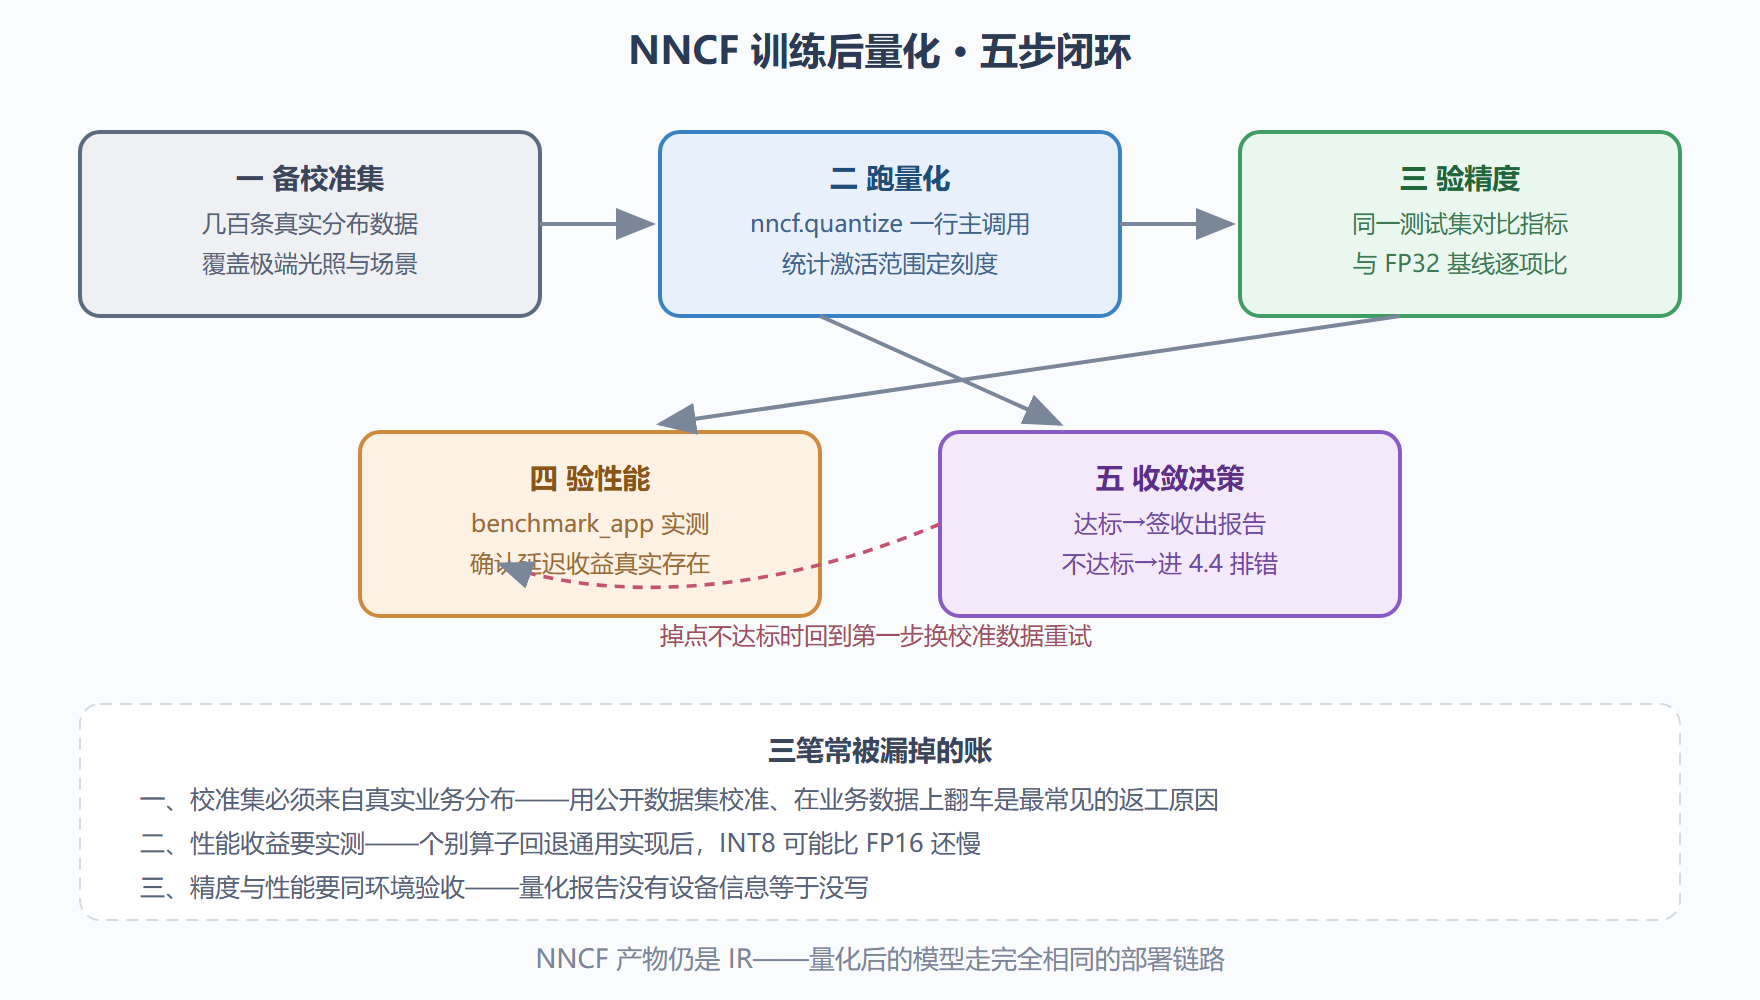
NNCF 工作流:十行代码的量化
工具侧,NNCF 的训练后量化接口相当克制,核心调用集中在十几行内:
import openvino as ov import nncf core = ov.Core() model = core.read_model("detector.xml") # 校准数据提供器:每次返回一条模型输入 def calib_data(): for image in calibration_images: # 业务分布的真实样本 yield image quantized = nncf.quantize( model, core, calibration_dataset=nncf.Dataset(calib_data), preset=nncf.QuantizationPreset.PERFORMANCE, # 或 ACCURACY,权重激活用不同位宽组合 ) ov.save_model(quantized, "detector_int8.xml")
两处值得停一下。校准数据生成器吃的是「模型期望的输入」,不是原始文件——预处理要跟推理时完全一致,否则统计出的激活范围就是错的。预设参数决定权重与激活的位宽搭配:性能预设激进,精度预设保守,拿不准就从精度预设起步,性能差距再用敏感层调整补。
量化产物仍是 IR,后续编译、调度、部署链路一概不变——这是 OpenVINO 工具链设计上讨喜的地方:压缩只是 IR 上的一道变换,不引入第二套运行时。
什么模型好压:一张经验表
| 模型族 | INT8 表现 | 注意点 |
|---|---|---|
| 分类骨干(ResNet、EfficientNet 系) | 几乎无损 | 标准靶子,PTQ 即可 |
| 检测(YOLO 系、SSD 系) | 掉点通常一个点内 | 小目标召回敏感,重点盯小目标指标 |
| 分割(UNet 系、DeepLab 系) | 中等 | 边缘精细度可能退化,IoU 之外看边界指标 |
| 注意力为主(Transformer、ViT) | 波动大 | Softmax 与 LayerNorm 附近敏感,常需排除若干层 |
| 轻量网络(MobileNet 系) | 收益相对小 | 本身算力弱,瓶颈常在预处理而非推理 |
表的经验价值在于预期管理:开压之前先对号入座,知道自己的模型站在哪一档,验收标准就能定得合理。至于压完掉点怎么查、怎么一层一层揪出元凶,交给 4.4 节的实录——那里有一单从崩溃到修复的完整过程。
校准集怎么搭:一份可执行配方
校准集既然是命门,就给出搭法。规模上,几百条起步、两三千条封顶——统计激活范围要的是覆盖度,不是样本量。构成上按「三分法」:七成来自真实业务分布的随机抽样,两成来自边缘场景定向补充(夜班、极端光照、罕见品类),一成故意保留「脏数据」——模糊帧、遮挡样本,它们在生产里一定会出现。校准输入的预处理与推理侧逐字节一致,拿不准时直接复用推理的数据加载代码。搭好后做一次健全性检查:把校准集的统计范围与线上采样数据的实际范围对比,明显偏窄就回头补样本。这份配方四十分钟执行完毕,换来的是量化结果的第一遍可靠。
量化模式与位宽的速查
参数选择再补一张速查卡。预设上,PERFORMANCE 档权重与激活都走八比特整型,速度优先;ACCURACY 档激活保留较高精度、权重整型,精度优先——两者实测延迟差通常在一到两成之间,掉点敏感的场景直接从 ACCURACY 起步。范围统计上,默认的最小最大值法对离群值敏感,对激活分布长尾的模型换百分位裁剪法(忽略万分之一的极端值)常能把掉点再压一半。粒度上,逐通道刻度对卷积几乎是免费午餐——精度更好、开销可忽略,保持默认开启即可。这张卡配合 4.4 节的排错路径,覆盖了 INT8 量化九成的参数决策。
量化收益的预期账
最后把「能快多少」的预期账算清。理论峰值是算力与带宽的双重收益,现实收益要打折:算子回退(个别层没有整型内核)、融合边界(量化节点打断融合模式)、带宽之外的固定开销(预处理、调度)都会吃掉收益。我们多轮实测的统计直觉:视觉卷积类模型 INT8 相对 FP32 的端到端加速多落在一点五到二点五倍之间,能到三倍以上的是算子规整、预处理较轻的幸运场景;不足一点五倍的,八成是预处理或后处理在总耗时里占了大头——此时该优化的是流水线(第 3 章)而不是继续压模型。开压之前用这笔账设定期望,验收时就不会拿理论峰值当 KPI。
三个高频追问
量化话题收尾,回答三个高频追问。追问一:FP16 算量化吗?严格说是精度收缩而非整型量化——没有刻度参数与舍入误差的量级问题,多数设备上近乎无损,所以 4.3 节把它列为「量化前的免费试验」;两者的验收严格度不同,FP16 只需对拍,INT8 要全量评测。追问二:量化的模型还能再剪枝吗?顺序上应该先剪后量化——剪枝改变激活分布,剪完重定刻度;反过来「先量化再剪」会让刻度作废,两条流水线打架。追问三:量化后模型文件一定变小吗?权重变小是肯定的,但部署包还包含配置与元数据,端侧打包环节若不做对齐,小模型也可能塞进大包——看部署包总体积,别只盯权重文件。三个追问里,「先剪后量」的顺序纪律最值得写进团队规范,它能省掉一轮完整的量化返工。
本节要点回顾
- 量化是交易:缩放因子与零点换存储、带宽、算力三重收益,代价是刻度粗化带来的舍入误差。
- PTQ 先行:几分钟到几十分钟出结果;QAT 是精度救不回来时的重武器,不是起点。
- 校准集即命运:分布不真实,刻度就定错,后面全错——第一笔投入要花在数据上。
- 对号入座定预期:模型族决定 INT8 波动区间,验收标准开压前定好。
量化之外还有别的瘦身路径——剪枝把整块结构拆掉,蒸馏让小网络学大网络的本事。4.2 节讲清它们的原理边界,以及为什么「稀疏」在硬件上不一定等于「省时间」。