4.3 硬件级特定优化与实测对照
4.3 硬件级特定优化与实测对照
本节摘要:同一份模型在 CPU 与核显上的表现可能差出一倍以上,方向取决于精度、分辨率与批量。本节用一组同环境实测数据拆解设备差异的来源——指令集、内存共享、频率墙——并给出各设备的调参要点与「什么时候别换设备」的判断。
量化与结构优化都在模型侧发力,这一节把镜头转向硬件侧:同样的模型、同样的代码,换一个 compile_model 的目标参数,性能天差地别。差异从哪来、哪些可以调、哪些是物理墙——本节用一组我们自己环境里的实测对照回答。所有数字来自同一台笔记本(较新酷睿 CPU 加 Xe 核显),你的绝对值必然不同,相对关系才是可迁移的结论。
一组实测:CPU 与核显的正面对照
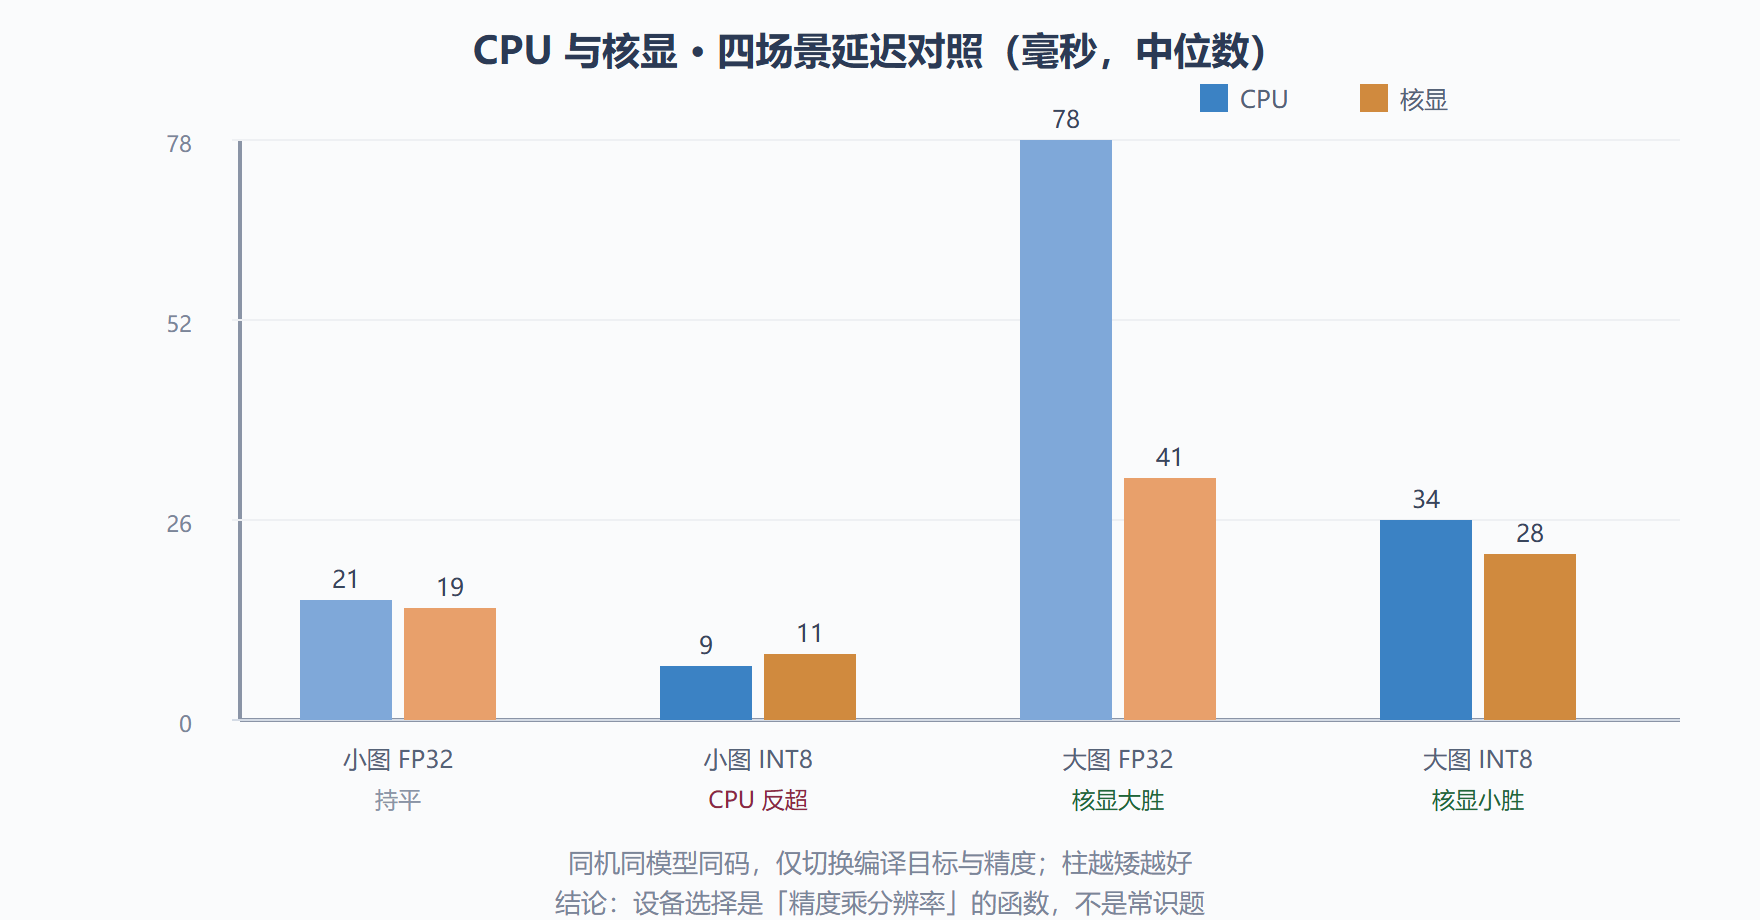
测试对象是一个中等规模的检测模型(约五千万参数量级),输入两档分辨率,FP32 与 INT8 两档精度,延迟优先模式,单请求同步推理。数字取百次中位数:
| 场景 | CPU 延迟 | 核显延迟 | 差距方向 |
|---|---|---|---|
| 小分辨率 FP32 | 约 21 毫秒 | 约 19 毫秒 | 基本持平 |
| 小分辨率 INT8 | 约 9 毫秒 | 约 11 毫秒 | CPU 反超 |
| 大分辨率 FP32 | 约 78 毫秒 | 约 41 毫秒 | 核显明显胜出 |
| 大分辨率 INT8 | 约 34 毫秒 | 约 28 毫秒 | 核显小胜 |
四行数字讲了三个故事。第一,输入越大核显越占优:分辨率抬升后计算密度超过 CPU 向量单元的吞吐上限,核显的并行阵列开始拉开差距。第二,INT8 是 CPU 的主场:AVX 指令集的整型路径对量化内核的加持立竿见影,小分辨率下反超核显。第三,设备排序不是常数,是「精度×分辨率」的函数——这直接推翻「换 GPU 一定快」的直觉,也是 1.3 节「设备没有全场最优」的定量注脚。
图 4-2 实测对照:设备优势随精度与分辨率切换
差异从哪来:三个物理源
指令集路径决定 CPU 的下限与上限。AVX2 与 AVX-512 的 FP32/INT8 吞吐差异直接映射到延迟;AMX 瓦片单元在新至强上进一步改写矩阵运算的账本。CPU 上调优的第一件事是确认内核真的走上了高阶指令路径——运行时属性里可以查到指令集标志,编译期选错指令集架构,性能差三成都正常。
内存拓扑决定核显的起点。核显与 CPU 共享系统内存,输入数据不用过总线,这对每帧几十兆的大分辨率输入是巨大让利;代价是核显算力上限低于独显,重模型会暴露短板。频率与散热墙则是笔记本设备的共同宿命:持续负载下频率回落,跑分软件里的峰值数字撑不过一分钟。实测必须跑持续负载取稳态——这正是第 7 章 benchmark 强调时长参数的原因。
调参要点:每台设备有自己的开关
CPU 侧:大核小核混合架构的机器关注线程亲和配置,把推理线程绑到性能核;吞吐模式的开销主要在流间竞争,流数交给性能提示自动定。核显侧:FP16 推理精度通常是免费午餐——算力翻倍、精度几乎无损,性能模式选延迟还是吞吐对照 3.3 节的口径。NPU 侧:静态形状、INT8/FP16、批量为 1 是它的舒适区,动态形状编译失败先查形状声明(2.1 节埋过伏笔)。
还有一个横跨设备的参数——推理精度提示:声明「内部计算允许降到 FP16」往往能在不改模型的情况下拿到接近量化的收益。它是量化之前最便宜的一步试验,尤其适合核显。
什么时候别换设备
换设备不是免费的:编译产物不可跨设备复用(多一份编译时间与内存)、张量搬运与格式转换可能吃掉理论收益、不同设备的精度行为需要重新验证。判断标准照旧是数据先行:先用 benchmark_app 把候选设备都测一遍(第 7 章的完整流程),差距在一个标准差内的,选运维更简单的那个——通常就是离数据最近的那个。
实测环境的一致性清单
实测数字要可信,先管住环境变量。给出一套实测前的一致性检查:供电与散热——笔记本插电源、性能模式、同一室温,连续测试前预留散热间歇;后台负载——关闭浏览器与同步盘,确认 CPU 占用基线接近零;频率状态——测试前跑一小段预热,让频率调节先稳定;批次记录——每组数据记录时间戳与环境快照,跨天的数据分开标注。这张清单执行成本五分钟,却决定了数据是「工程证据」还是「随机数」。第 7 章的基准方法论会把同样的纪律推广到所有性能测量,这里的版本是它的设备侧特例。
混合部署:让每个设备干擅长的事
实测对照的另一个推论值得展开:既然不同设备在不同场景各有胜负,同一个业务里让它们分工往往优于全押一边。一个典型分工:视频解码走核显的专用单元,检测主干按分辨率档位分流——小图批处理给 CPU 的整型路径,大图实时帧给核显,常驻的轻量分类丢给 NPU 省电。分工的粒度以「模型」为单位而不是以「层」为单位(以层切分是第 3 章说过的兜底手段),设备间只传结果不传大张量,搬运成本就藏不住。这套混合编排在第 6 章的流水线实战里会实际落地,此处先立一个意识:设备编排是设计出来的,不是测出来的——知道每个设备的擅长区间,编排图自然浮现。
常见的三个设备调参误区
补三个高频误区作收尾。误区一,迷信设备峰值算力:厂商标称的 TOPS 是理论峰值,实际可用算力受内存带宽与算子实现制约,评估看实测不看宣传页。误区二,忽视 CPU 侧的NUMA与核绑定:多路服务器上推理线程跨 NUMA 访问远程内存,延迟差可达三成,绑定线程到模型所在 NUMA 节点是服务器调参的常规动作。误区三,用同一份基准横评所有设备:每设备有自己的舒适配置(提示、流数、精度),「统一默认配置横评」评出的是各设备的下限而非上限,正确的横评是「各设备各自调到最佳再比」。三个误区的共同解药都是 7.1 章的测量纪律——让数据替直觉站岗。
三个高频追问
实测话题收尾,回答三个高频追问。追问一:为什么我的实测数字与本章的表对不上?必然对不上——本章数字来自特定机型、特定模型、特定版本,你该对标的是「相对关系」:大图偏核显、小图整型偏 CPU 的方向性结论跨设备基本成立,绝对值请用自己的环境重测。追问二:同一台机器不同批次测试波动明显怎么办?回到环境一致性清单,重点查散热与后台任务;波动超过半成的测试环境,先修环境再修模型。追问三:新设备发布后,旧实测结论要重测吗?方向性结论通常稳定,具体参数建议(流数、提示组合)要重测——设备代际变化最大的就是这些参数的最优值。把「哪些结论跨设备可迁移、哪些必须逐设备重测」分清楚,是设备实测从「跑分游戏」变成「工程依据」的分水岭。给本章的实测表补最后一句使用说明:表中数字的置信区间大约在正负一成,任何两个配置的差距小于这个量级时,都应视为打平——按运维简单者选。差距显著时才值得为性能切换配置,这是让实测数据服务于决策、而不是绑架决策的最后一道闸。
本节要点回顾
- 设备排序是函数不是常数:小图 INT8 CPU 反超,大图 FP32 核显领先,先定场景再定设备。
- 三个物理源:指令集路径定 CPU 上限,共享内存定核显起点,频率墙定笔记本稳态。
- 便宜的试验先做:FP16 推理提示是量化之前性价比最高的一步。
- 换设备要算全成本:编译、搬运、精度重验,差距不大时选运维简单的。
调参完毕仍有掉点或性能缺口怎么办?4.4 节进入实战:一单 INT8 量化掉点的完整排错复盘,把本章方法串成一次真实作业。