5.1 GenAI 扩展库
5.1 GenAI 扩展库
本节摘要:OpenVINO GenAI 是面向生成式负载的扩展库:把分词、循环解码、采样、KV 缓存管理打包成开箱可用的流水线组件,补上静态图运行时天然不擅长的「循环与状态」。本节讲清它解决什么问题、不解决什么问题,并给出第一个大模型推理程序。
第 4 章收尾时留了一个悬念:量化的思路在大模型上会以另一种形式重生。这一章兑现它,但先要回答一个前置问题——判别式模型「一次前向出结果」的运行模式,为什么装不下大语言模型。弄清这个问题,GenAI 扩展库的存在理由就自明了。
一个新负载,一类新问题
文本生成不是一次推理,是一个循环:分词、前向计算、按概率分布采样下一个词、把它接回输入、再来一轮——直到结束符。循环里藏着三个静态图运行时不友好的东西。
一是变长:输入文本长度不定,输出更不定,静态形状的舒适区完全不覆盖。二是状态累积:每生成一个词,历史词的注意力中间结果(KV 缓存)就多一份,缓存的形状随序列增长。三是采样逻辑:温度、top-p 这些采样策略活在模型外面,纯图执行表达不了。用裸 Runtime 硬写这个循环当然可行,但分词器、缓存管理、采样器全要自己搭——每一件都是独立的工程量,且极难写对。
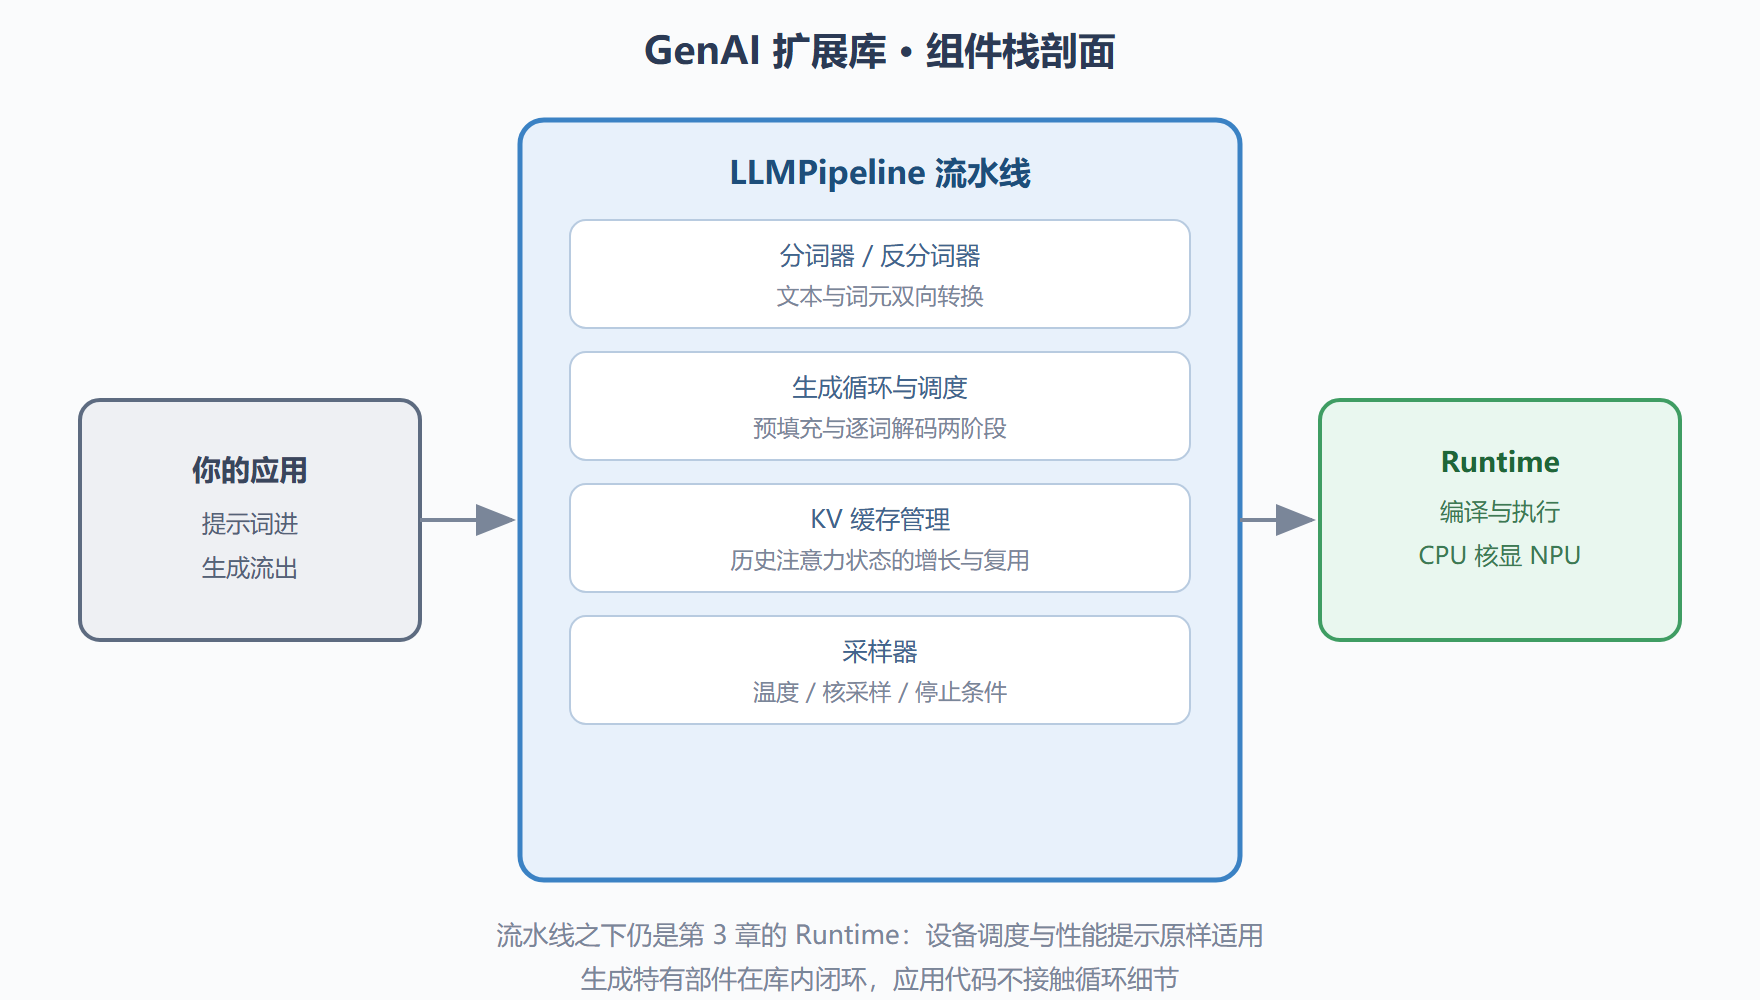
GenAI 扩展库把这些打包成组件:分词与反分词、生成循环、KV 缓存管理、采样策略、流式输出,以「流水线」对象一处交付。你面对的不再是「用运行时拼装一个生成器」,而是「配置一个生成器」。
图 5-1 GenAI 扩展库的组件栈与裸用 Runtime 的对比
十行跑起一个大模型
流水线对象的用法与它的承诺一致地克制:
import openvino_genai as ovgen pipe = ovgen.LLMPipeline("./qwen2-1_8b-ir", "CPU") pipe.start_chat() output = pipe.generate("用一句话解释什么是中间表示", max_new_tokens=100) print(output) pipe.finish_chat()
模型参数指向一个目录:IR 权重、分词器配置、生成配置住在一起,搬家即部署。设备参数照旧是第 3 章的语法;对话状态由 start_chat 与 finish_chat 圈定,缓存复用自动完成。多轮对话时历史词元不再重算——这是流水线替你省下的最贵的一笔账,裸写循环时最容易漏的也正是这笔。
边界:它管什么,不管什么
GenAI 管生成负载的骨架,不替你做三件事。模型本身要自己准备——从训练框架导出、转换成 IR 的路径仍是第 2 章的内容,官方模型库与社区转换好的模型目录可以直接取用;权重压缩要自己决定——五. 二节展开压缩选项与代价;业务级的问题——提示词工程、内容安全、结果评估——在部署工具的边界之外。
另一条边界是硬件支持面:流水线组件在 CPU 与核显上最成熟,NPU 支持在快速演进中,具体模型结构是否可跑要以版本说明为准。选型阶段把「目标设备加目标模型」这一对组合先在真机上验证,是第 1 章三问决策法的延续。
流式输出:体验工程的第一个杠杆
流水线能力里有一项对体验影响巨大却常被低估:流式生成。逐词拿到输出并立即推送,用户感知的等待从「全文生成完毕」压缩到「首词出现」,主观速度感提升远大于任何底层数字优化。流水线的生成接口原生支持流式回调——每产出一个词触发一次回调,应用把词追加到前端即可。配套两个体验细节:回调里别做重活(格式化、敏感词扫描放到收尾或单独线程),以及给输出加「正在生成」的可视状态——等待感是心理量,管理它和优化它是两件互补的事。把流式与 5.2 节将讲的两阶段延迟合起来看,就得到端侧对话产品的一条铁律:产品体验的上限由首字延迟决定,下限由生成速率决定,两者要分开优化、分别验收。
多模型组合:流水线不止管文本
GenAI 扩展库的流水线家族不止文本生成:语音识别、语音合成、图像生成的流水线接口同样在列,统一遵循「给目录、给设备、给输入」的用法范式。对部署设计的意义在于组合成本可控——语音助手形态的应用(语音进、语音出)可以用识别流水线接生成流水线再接合成流水线,三段各自的模型与设备独立配置。组合时的工程要点与 6.4 节的流水线总装完全同构:段间用队列解耦、按各段耗时设计并发、警惕段间的格式转换开销。选型评估时,把「应用需要哪几段、每段选什么模型」画成一张流水线草图,比逐个模型孤立评估更能暴露真实瓶颈。
版本与兼容:扩展库的升级节奏
扩展库比核心运行时迭代得更快,这是生成式领域高热度的自然结果。升级策略因此要多一道心眼:扩展库新版本可能调整生成接口的参数语义(采样默认值、流式回调签名),升级后先跑一遍功能回归——对话质量抽样对比加接口行为核对——再决定推送。锁版本是最稳的做法,把「扩展库加核心运行时」的组合版本写进部署清单,生产环境的所有机器保持同一组合。这套纪律与第 2 章的转换版本管理一脉相承:推理链路上每一环的可复现性,都是排错时最重要的资产。
三个高频追问
扩展库话题收尾,回答三个高频追问。追问一:只用裸 Runtime 手写生成循环,到底行不行?行,但不值——分词、缓存、采样三件套的正确实现各有一堆细节(词元截断规则、缓存的增长与回收、采样里的数值稳定性),手写一遍的工程量够做好几个业务功能;扩展库的价值正是把这些「与业务无关但必须正确」的部分封装掉。追问二:GenAI 流水线与直接调 Hugging Face 加 OpenVINO 后端的组合,怎么选?后者适合算法验证期——生态组件全、换模型方便;前者适合部署期——没有 Python 解释器依赖,部署体积与启动时间都占优。以部署为目标的项目,验证期就可以用流水线的接口习惯写代码,迁移成本最低。追问三:模型目录里该有什么、缺了会怎样?完整的目录是 IR 加分词器配置加生成配置三件,缺任何一件流水线在初始化时就报错——报错信息会明确指出缺哪个文件,拿到别人分享的模型目录时先清点这三件再跑。三个追问的指向一致:扩展库把生成式部署的门槛压到「配置正确」,你的精力应该花在配置之下的模型选择与配置之上的业务逻辑。
选型阶段的快速验证清单
进入 5.2 与 5.3 之前,给「要不要在项目里引入生成式能力」一个二十分钟的预检清单:一,目标设备上用最小模型跑通流水线,确认扩展库安装与设备插件正常;二,拿业务的十个典型问题喂给候选小模型,人工看回答质量的天花板够不够业务下限;三,量一下首字延迟与生成速率的裸数字,对照业务的体验预期算差距;四,确认模型许可与数据出域约束不冲突。四项全过,生成式能力对你的项目就是现实的;任何一项不过,先解决那一项再谈集成——预检的成本是半小时,跳过它的代价常常是一个季度的方向性浪费。
本节要点回顾
- 生成负载三难点:变长序列、KV 状态累积、采样逻辑,静态图运行时不覆盖,GenAI 以流水线组件打包解决。
- 组件栈五层:分词、生成循环、缓存管理、采样器位于应用与 Runtime 之间,下方仍是熟悉的设备调度。
- 十行可用:流水线对象把部署门槛压到「给目录、给设备、给提示词」。
- 边界清晰:模型转换、权重压缩、业务安全各归各家,NPU 支持面以真机验证为准。
流水线跑起来了,性能却远未到头。下一节进入大模型优化的腹地:权重怎么压到四比特、KV 缓存怎么管、预填充与解码两段延迟为什么必须分开看——5.2 节讲三堵墙。