7.1 性能工具链
7.1 性能工具链
本节摘要:性能工作的三件套:benchmark_app 给全局成绩单,性能计数器给逐层耗时,运行时属性给配置证据。本节讲清各工具的适用问题、benchmark 报告的完整读法、逐层计时怎么开启,以及「平均延迟骗人」的百分位常识。
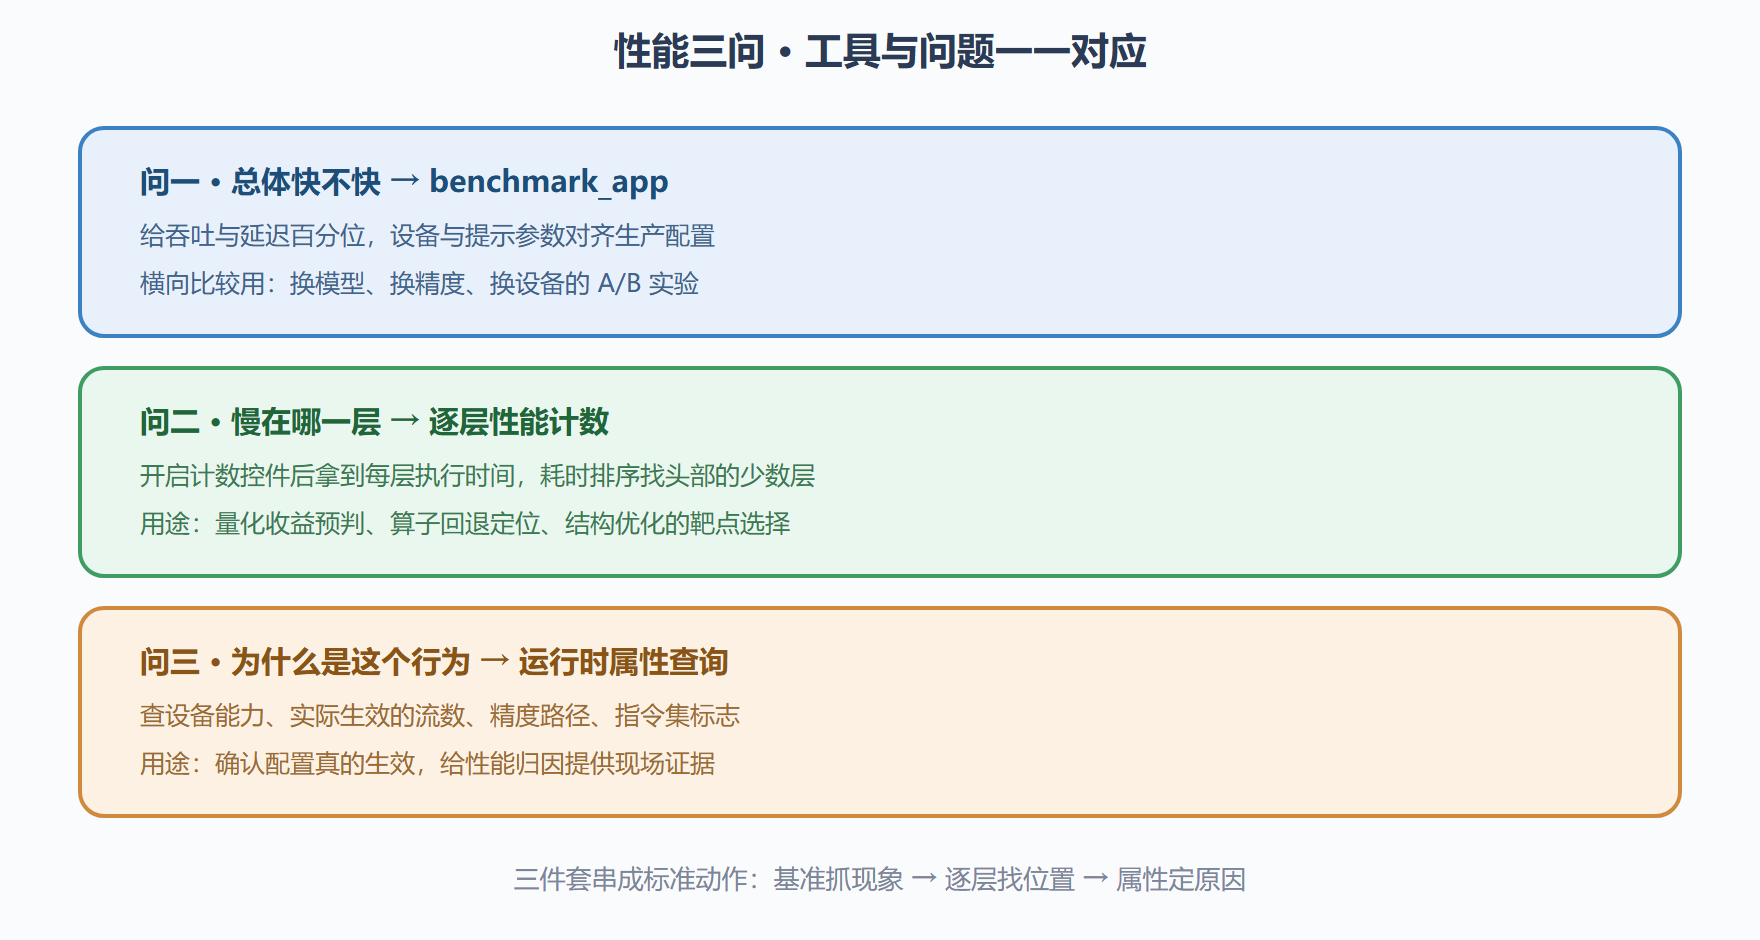
全书多次预告「第 7 章给测量方法」,现在兑现。性能工具的选型逻辑很简单:先问要回答什么问题——「总体快不快」用基准工具,「慢在哪一层」用逐层计时,「为什么是这个行为」用运行时属性。三个问题三个工具,一一对应。
benchmark_app:三十秒拿到成绩单
这是官方基准工具,一条命令覆盖大部分测量需求:
$ benchmark_app -m detector_int8.xml -d GPU -hint throughput -t 30
四个参数各管一件事:模型路径指定测谁;设备指定编译目标;性能提示对齐生产配置——这条最容易被忽略,用延迟模式测出的数字去预测吞吐模式的服务毫无意义;时长控制测量窗口,持续 30 秒起步,让频率回落、缓存稳定后再取数,笔记本设备尤其如此。
报告读法有讲究。吞吐与延迟两组数字之外,重点看三处:百分位延迟——中位数正常而尾延迟爆表的服务,监控上会以「偶发投诉」的形态出现;编译加载耗时——它决定了服务重启与扩容的速度,往往单独优化;设备信息回显——确认内核真的跑在你以为的指令集路径上(4.3 节的教训)。另外记得一个原则:基准工具的数字用于横向比较,不能直接当线上容量数字——真实服务的预处理、并发干扰都不在基准里。
图 7-1 性能工具链的分层地图
逐层计时:把慢定位到层
基准报告说「整体慢了」,下一步是打开逐层计数,让每一层自报执行时间:
import openvino as ov core = ov.Core() config = {"PERFORMANCE_HINT": "THROUGHPUT"} compiled = core.compile_model("detector.xml", "CPU", config) # 启用逐层性能计数后执行推理 # 再从推理请求读取性能计数数据 perf = request.get_profiling_info() # 概念示意 for layer in sorted(perf, key=lambda x: -x.real_time): print(layer.node_name, round(layer.real_time_us / 1000, 3), "ms")
读法是排序看头部:推理耗时高度集中,前五层常占八成时间。头部若出现预期之外的算子类型(比如某层回退到了通用实现),就找到了优化靶点——换设备、排除出量化、或者回报 2.3 节做算子替换。逐层数据还有个妙用:量化决策的预演。把头部层的算子类型对照 4.1 节的经验表,压完能快多少基本可以预估,避免「压完才发现白压」。
属性查询:配置的现场证据
第 1 章说过 API 2.0 是契约式设计,契约的另一半是「可查证」。性能归因时常用的几个查询:设备实际生效的流数(确认吞吐提示真的被采纳)、推理内部精度(确认 FP16 提示生效)、设备全名与驱动版本(对齐测试环境记录)。这些查询加起来不超过十行代码,却在每一次「为什么测试机和生产机表现不同」的讨论里充当仲裁者——环境差异的九成,都藏在属性里。
把三件套固化成团队习惯的办法是写进发布流程:任何性能相关的变更(模型、精度、设备、并发配置)合并前,附一份基准对比与属性快照。数字不会说谎,前提是你每次都问它。
一次完整的性能会诊流程
三件套怎么配合,走一遍完整会诊。现象:某服务的 P99 延迟从八十毫秒劣化到两百毫秒,平均延迟基本没变——平均数没变意味着多数请求正常,是尾部出了问题,这直接排除了「模型变慢」的假设(模型变慢会整体抬升)。第一步基准复测:对齐生产配置跑基准,基准环境 P99 正常——排除模型与配置,嫌疑收窄到服务环境。第二步属性查询:对比测试机与生产机的属性快照,发现生产机的性能提示配置丢失,运行时按默认策略跑在延迟模式且流数为一——并发请求在单流上排队,尾延迟自然爆表。第三步修复验证:配置回填,P99 回到八十五毫秒,关闭工单。
三分钟的会诊走了三件套各一招,顺序值得记:基准定性(是模型问题还是环境问题)、属性定位(哪个配置没生效)、逐层计时兜底(前面都排除时才动用)。多数性能工单走不到第三步——配置类问题占了大半,这正是 1.1 节「契约式 API」的排错红利:所有决策可查证,配置漂移无处藏身。
基准数据的档案化
单次基准数据只回答眼前问题,档案化的数据才能回答趋势问题。建议给每个上线模型建立一份基准档案:每次重大变更(模型迭代、精度调整、设备迁移)后跑一轮标准基准,数据连同环境快照追加进档案。档案的价值在时间轴上:三个版本后吞吐的缓慢下滑、半年后新驱动带来的性能回退,只有靠历史数据对比才能发现——这些「温水煮青蛙」式的劣化,单点测量永远看不见。档案格式不必复杂,一张表加一列备注即可,关键是测量口径永远不变:同一参数、同一时长、同一环境记录规范。口径漂移的档案比没有档案更误导。
从工具到习惯:性能文化的三个动作
工具和方法要变成团队习惯才产生持续价值。三个落地动作:其一,变更附基准——任何影响推理路径的合并请求,描述里附前后对比数据,没有数据的性能优化不进主干;其二,告警连档案——线上性能告警触发时,值班人员第一步是调出基准档案对比,快速判断是新问题还是慢性劣化越过了阈值;其三,季度复测——每季度对在线模型抽测一轮,捕获环境漂移(驱动更新、系统升级)带来的隐性变化。三个动作都不重,坚持半年,团队对「性能」的认知会从「感觉变慢了」进化到「第几版之后、哪项指标、劣化多少」——这正是本章名字里「工具链」的真义:工具连成链,数据才能变成组织的记忆。
三个高频追问
工具链话题收尾,回答三个高频追问。追问一:基准数字与线上监控数字对不上,信哪个?都对不齐也都有用——基准是受控环境下的「实验室体检」,监控是真实负载下的「临床记录」;两者差异本身就是信息,差异大说明线上有基准未覆盖的因素(并发干扰、数据分布、共存服务),顺着差异查往往就是瓶颈。追问二:逐层计时的开销会不会影响测量结果?会——计数本身有代价,开启计数后的绝对数值偏高,但层与层之间的相对占比依然可信;用它做归因(哪层最贵)没问题,用它对外报告绝对延迟不行。追问三:性能档案应该存多久、多细?按版本存、按里程碑归档——每个上线版本一条记录,活跃模型保留全历史,退役模型归档冻结;粒度到「参数加关键指标」即可,原始日志不必长存。三个追问的共同提醒:性能数据的价值在使用方式,不在采集精度——对齐口径、理解开销、管好档案,工具才真正连成链。
本节要点回顾
- 三问三工具:总体快不快用基准、慢在哪用逐层计数、为什么用属性查询。
- 基准对齐生产:设备、性能提示、持续时长都要与线上配置一致,否则测的是另一个系统。
- 头部层定靶点:逐层排序找耗时头部,量化与结构优化的靶点从这来。
- 属性即证据:环境差异先查属性快照,配置是否生效一查便知。
工具齐了,最后一课是「出问题时怎么查」。7.2 节按症状给出排查索引——把前面六章的机制知识,变成一张快速定位的故障地图。