4.1 虚拟内存与 Sv39 页表手解
4.1 虚拟内存与 Sv39 页表手解
本节摘要:Sv39 是 RISC-V 在六十四位应用上的主力分页方案:三十九位虚拟地址、三级查表、四 KiB 标准页与两级大页。本节把一次完整的三级查表逐位走通,拆解页表项九个标志位的分工,并讨论翻译缓存为何是性能命门——以及裸机环境如何搭一张最小页表跑通虚拟地址。
给地址分层的三种理由
程序直接使用物理地址会立刻撞上三堵墙:两个进程想用同一地址放各自的数据,必有一方让位;进程想看住自己的数据不被他人读写,无从下手;内存碎片让"要一块连续物理内存"变得昂贵。虚拟内存用一层地址翻译同时拆掉三堵墙:每个进程活在自己独立的虚拟地址空间里,内核把虚拟页按需映射到任意物理页,隔离靠权限位、弹性靠映射表。代价是每次访存多了一轮查表——本节的全部内容,就是把这笔账算清楚并让它付得值。
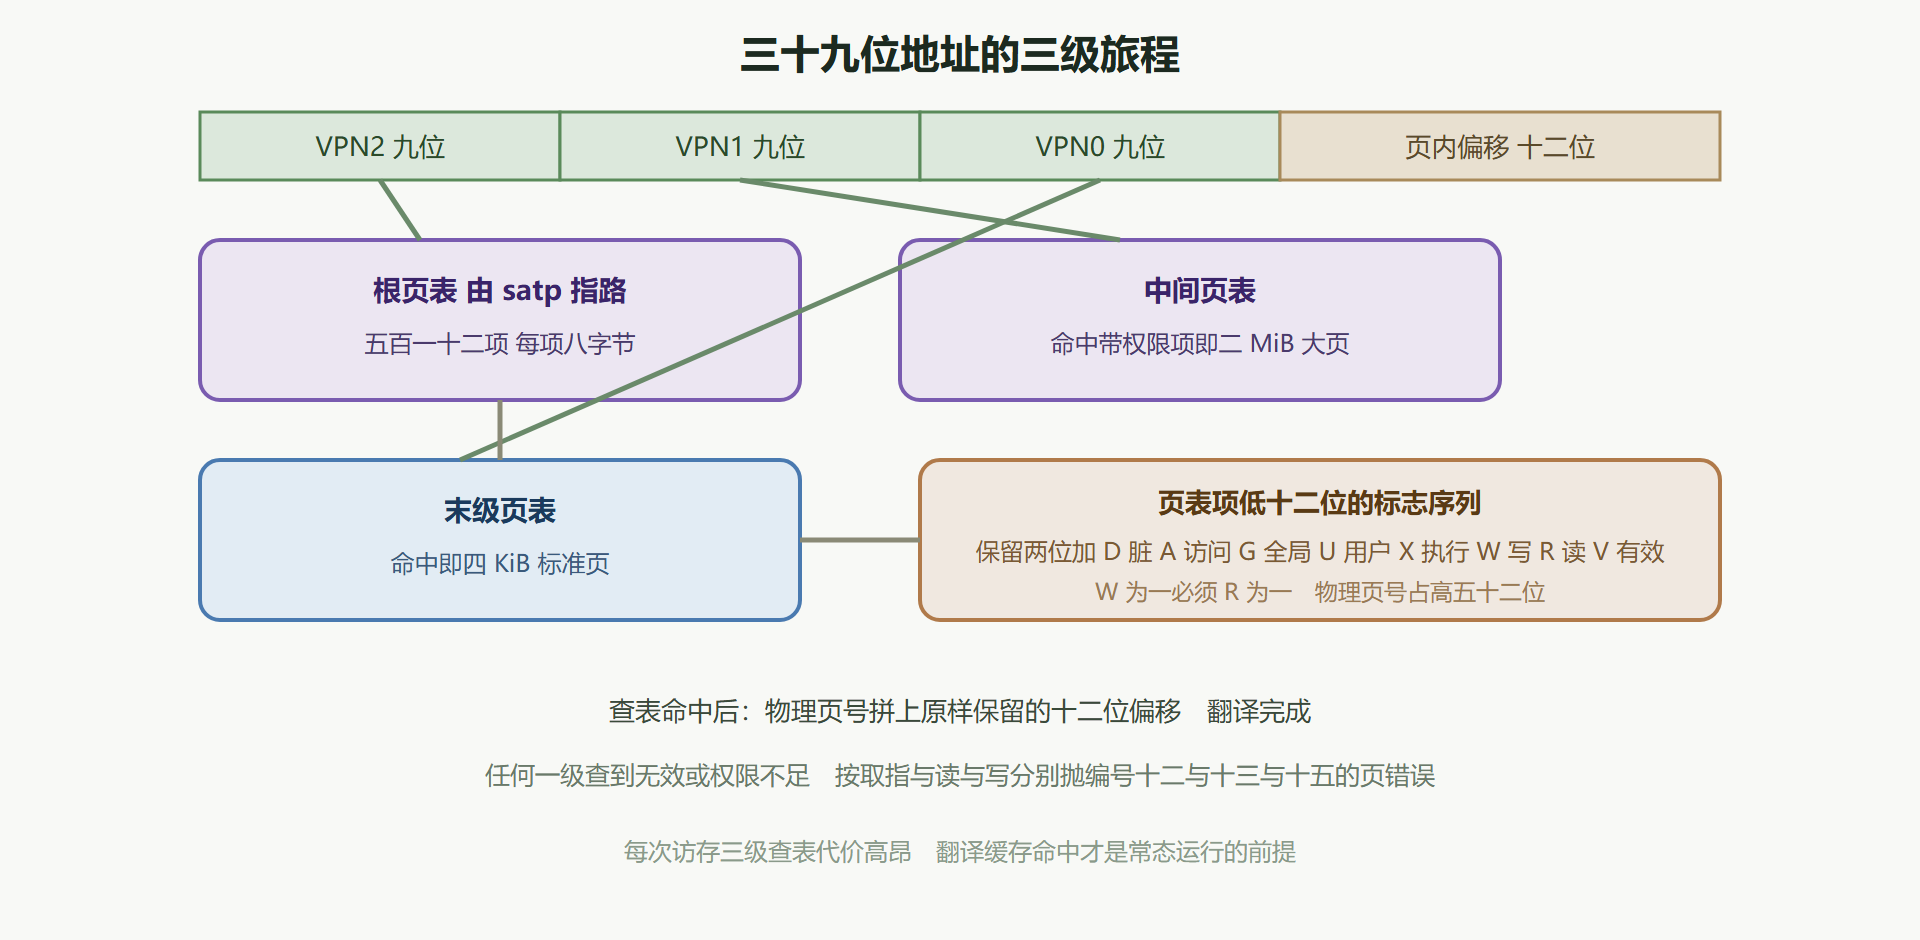
Sv39 方案的参数先立起来:虚拟地址三十九位,低十二位是页内偏移(页大小四 KiB),中间二十七位是虚页号,被切成三段各九位,分别索引三级页表;物理地址五十六位,其中四十四位是物理页号。三级、九位、四 KiB 这组数字互相咬合:九位索引对应每张表五百一十二项,每项八字节,恰好一张表占一页——页表自己也能被页表管理,递归结构整齐得可以写进编译器常量。
三级查表:一笔一笔算
规范里页表基址住在 satp 寄存器:高四位是模式域(Sv39 写八),接下来十六位是地址空间标识符 ASID,低四十四位是根页表的物理页号。翻译从根开始:
- 取虚拟地址第三段(第三十到三十八位)作索引,在根表中定位一个页表项;
- 读该项:若有效位为零或仅有访问权限而无读写执行权限且非指针项,触发页错误;若有效且无任何读写执行权限,则它是指向下级的指针,取其物理页号,用第二段(第二十一到二十九位)索引中间表,重复判断;
- 到最底层表,读出的页表项若有效,其物理页号拼上原始地址的低十二位偏移,翻译完成。
顺带认识大页:若第一级就查到带读或执行权限的有效项,它映射的是一 GiB 巨页;第二级命中则是二 MiB 大页。内核映射大块连续内存时用大页能把查表从三级压到一级,翻译缓存的压力也随之骤减——这是数据库与大内存服务调优的常用杠杆。
页表项的低十二位是九个标志位加两位保留位,值得列一张表看清分工。
| 位 | 名称 | 含义与要点 |
|---|---|---|
| 0 | V 有效 | 为零即映射不存在,访问必报页错误 |
| 1 | R 可读 | 允许加载指令访问 |
| 2 | W 可写 | 与 R 互斥约束:W 为一必须 R 为一,只写页不存在 |
| 3 | X 可执行 | 允许取指,数据执行防护的地基 |
| 4 | U 用户 | 为零则用户级访问触发页错误,内核页的保护栓 |
| 5 | G 全局 | 翻译缓存项不随 ASID 切换失效,内核映射专用 |
| 6 | A 已访问 | 硬件可置位或报错由软件补记,页面置换算法的依据 |
| 7 | D 已脏 | 写入时置位,决定换出时是否需要回写 |
标志位里藏着两个高频坑。其一,W 依赖 R 的约束是规范明文:不存在"只可写不可读"的页面,某些老教程按其他架构经验设置的权限位组合,在 RISC-V 上会直接变成无效映射。其二,U 位是用户隔离的真正的栓——内核映射若忘清 U 位,用户态就能直接读写内核内存;反过来,内核读用户缓冲区时又被 U 位挡住,需要 mstatus 里 sstatus 的求和位临时放行。这两个坑在自研内核的早期都是必修课。
图 4-2 Sv39 三级翻译与页表项位段
工程现场:裸机搭一张最小页表
背景:在无操作系统的裸机环境验证虚拟内存:让一段代码从物理地址切换到完全不同的虚拟地址运行,这是自研内核的第一块试金石。
操作:规划一张两张叶子项的迷你页表。准备三个对齐的页作三级表,建立恒等映射(虚拟地址等于物理地址,保证开启分页的瞬间正在执行的代码不摔跟头),再把虚拟地址高半区映射到内核数据页。关键代码序列如下。
la t0, root_table srli t0, t0, 12 # satp 里存的是物理页号 li t1, 8 # 模式域 Sv39 slli t1, t1, 60 or t0, t0, t1 csrw satp, t0 sfence.vma zero, zero # 冲刷陈旧翻译
结果:写完 satp 的下一条指令仍按旧翻译继续执行(恒等映射保证了连续性),随后跳转到高半区虚拟地址成功,访问映射页数据正常;故意访问一个未映射地址,mcause 立刻报出编号十五的存储页错误,mepc 与 mtval 精确指向作案指令与出错地址。
解读:这个实验把翻译机制的几个关键处变成肌肉记忆:satp 存的是页号不是字节地址;切换 satp 后必须 fence 否则翻译缓存里的旧映射会阴魂不散;页错误三兄弟(编号十二取指、十三读、十五写)配合 mtval 能把现场交代得一清二楚。另外注意恒等映射的工程意义:切换瞬间的"翻译断层"是所有内核页表设计的公共暗礁,惯例是恒等映射保底加事后拆除。
变式:把中间级表项改成带权限的大页项,映射一块二 MiB 区域,对比两种映射下访问速度的差异;再把内核数据页的 U 位置一并从用户态试探访问,观察页错误编号不变而权限语义不同——两个变式分别对应大页调优与用户隔离两条实战线。
翻译缓存:性能的隐形阀门
查表三级、每级一次访存,意味着没有缓存的机器每次内存访问要变成四次访存——性能直接坍缩。翻译缓存(TLB)因此是所有实现的核心部件:把最近用过的虚拟页到物理页映射存进硬件表,命中则零成本通过。它的存在带来两个工程后果。第一,改页表不等于立即生效:旧映射可能还躺在缓存里,这就是 sfence.vma 存在的理由——按地址冲刷、按 ASID 冲刷或全部冲刷,粒度越细代价越小,内核切换进程时靠 ASID 避免全量冲洗。第二,缓存的规模与策略是微架构差异最大的地方之一,同一份内核代码在不同芯片上的系统调用延迟可能差出数倍,排查性能问题时要记得这一层变量的存在。
本节要点回顾
- 三层九位三级表:Sv39 的全部骨架,五百一十二项与四 KiB 页表页互相咬合成递归结构;
- satp 三段式:模式域、ASID、根页表物理页号,切换后必跟 sfence.vma;
- 标志位两坑:W 依赖 R 的硬约束、U 位既是隔离栓也是内核读用户缓冲的拦路虎;
- 大页是查表捷径:一级命中一 GiB、二级命中二 MiB,大内存服务的基础调优杠杆;
- 翻译缓存决定性能下限:改映射必须冲刷,冲刷粒度是内核性能工程的一部分。
翻译层管住了地址的真假,但它只对开启分页的世界负责。物理地址层面还有一道更原始也更硬的关卡——下一节的物理内存保护。