5.1 向量扩展 V:可变长的算术引擎
5.1 向量扩展 V:可变长的算术引擎
本节摘要:向量扩展给 RISC-V 装上一台可变长算术引擎:三十二个宽度可伸缩的向量寄存器、运行时决定元素宽度与分组方式的配置指令、以及把"残余元素"处理内置进硬件的长度寄存器。本节沿一条信号滤波的代码主线,把手写向量序列的每一步状态变化拆到位。
从一个性能死结说起
标量指令处理成批数据时的窘境可以量化:对一万个采样点做乘加,标量循环要取指一万次、每次搬运一个数据,取指与译码的功耗花在"指挥"而非"干活"上。固定宽度 SIMD(比如主流架构上的一百二十八位或二百五十六位指令)前进了一步,却埋下兼容性的雷:宽度焊在指令编码里,代码为宽度定制,换硬件宽度就得维护另一套二进制。RISC-V 向量扩展的破局思路是把决策权后移——指令只说"对一组元素做乘加",一组多少个、每个几位,由运行时读硬件报告后现场决定。同一份二进制,在一百二十八位的低功耗核上跑一百二十八位宽,在五百一十二位的服务器核上自动吃满宽度,这正延续着第五章支柱页说的那个哲学:规范不替硬件定型。
家底:寄存器与两个旋钮
向量扩展的地基是三十二个向量寄存器 v0 到 v31,每个的位宽由实现决定,规范支持从一百二十八位起、以二的幂次伸到六十五位以上任何长度(常见实现选二百五十六位或五百一十二位)。所有向量寄存器的总位宽(乘上三十二)构成实现的"向量架构状态",规范允许实现按此伸缩,软件通过读取向量长度参数自适应——这个参数没有写死,是"可变长"三个字的物理载体。
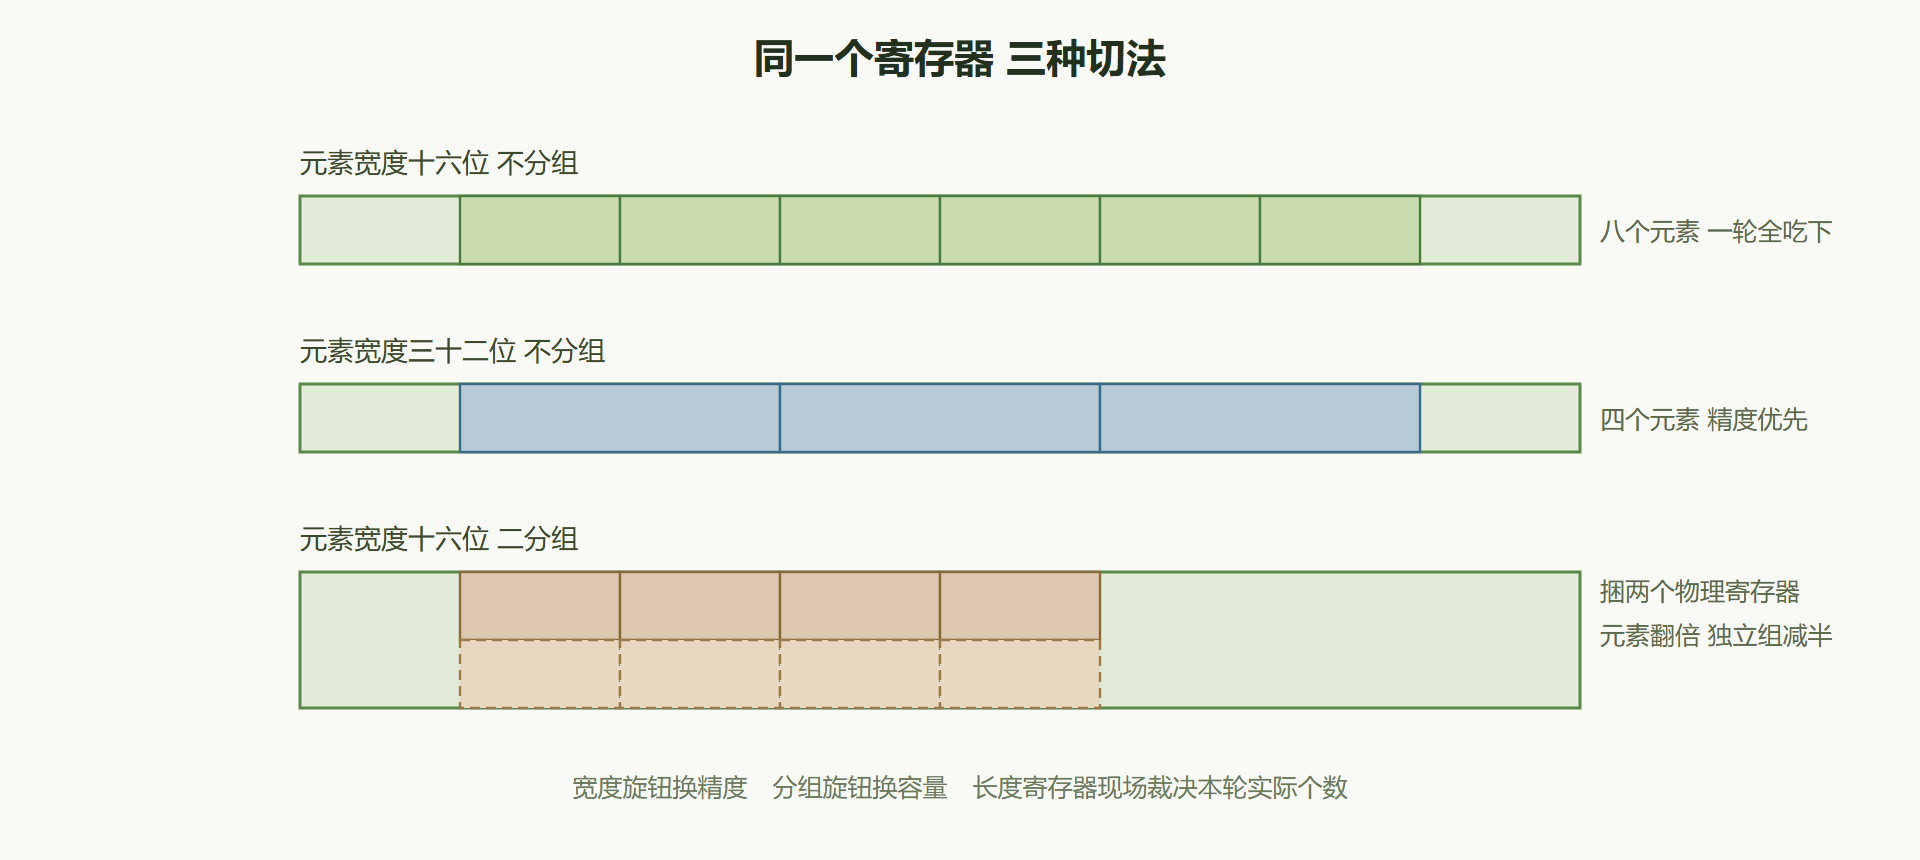
两个旋钮决定了每条向量指令实际驱动多少数据。第一个旋钮是单元素宽度(SEW,选元素宽度):八、十六、三十二、六十四位可选,按数据类型切换——处理字节流选八位,处理浮点选三十二位。第二个旋钮是寄存器分组(LMUL):把相邻几个向量寄存器捆成一个逻辑组,一个逻辑寄存器装下更多元素,适合数据量大而寄存器少的场合;代价是分组后可用的独立逻辑寄存器变少,编译器调度空间被压缩。两个旋钮组合出单个逻辑寄存器容纳的元素个数上限,再由第三个关键角色——向量长度寄存器 vl——现场裁定本轮实际处理几个。
三十二个寄存器里 v0 身兼二职:既可作普通数据寄存器,又可在带掩码的指令里充当掩码位图,逐个元素地决定"这个元素参与运算还是保持原值"。掩码让向量代码能用无分支的方式表达条件逻辑,是消除循环内 if 的核心武器。
手解实验:一段滤波序列的完整状态跟踪
纸上跟踪一遍向量代码的状态变化,比任何描述都直观。任务:两个数组逐元素相加,长度不定。核心序列如下。
li t0, 1024 # 总元素数 la a0, src_a la a1, src_b la a2, dst loop: vsetvli t1, t0, e32, m1, ta, ma # 按剩余量定长度 vle32.v v1, (a0) # 加载一组 vle32.v v2, (a1) vadd.vv v3, v1, v2 # 逐元素相加 vse32.v v3, (a2) # 存回一组 sub t0, t0, t1 # 减去本轮处理的个数 add a0, a0, t1 # 指针按实际长度推进 add a1, a1, t1 add a2, a2, t1 bnez t0, loop
vsetvli 那一行是全段的灵魂,五个参数各管一事:e32 声明元素三十二位;m1 不分组;ta 与 ma 是尾元素与掩码的策略位(稍后细讲);第二个操作数 t0 是请求长度。指令返回时,t1 写入本轮实际处理的元素个数——硬件在"请求值"与"本轮容量"之间取小。于是循环最后一轮天然只剩残余:请求八个硬件只肯给三个,vl 就等于三,加载、运算、存储全部按三个元素动作,指针按三推进,循环体零特判。传统 SIMD 需要单独写"标量尾巴循环"的残余问题,在这里被长度寄存器一个机制吞掉。
策略位与性能的暗礁
ta 与 ma 两个策略位解决一个隐蔽问题:当 vl 小于逻辑寄存器容量时,尾部那几个"没参与本轮运算"的元素(尾元素)该保持原值还是清零?保持原值(tu)省一次清零,但寄存器里残留旧数据;清零(ta)牺牲一点带宽换确定性。掩码未选中的元素同理。选错策略不会出错——语义上尾元素不该被读——但会在寄存器复用时埋下性能暗礁,密集调优时值得回头检查。
向量代码的真正性能杀手另有两位。一是跨步访存:数据在内存里不连续时,带步长的加载要发起多个分散访存事务,带宽利用率骤降,这时该考虑先用聚集与散射指令整理布局,或者改数据结构(结构数组换数组结构)。二是寄存器压力:LMUL 开大后逻辑寄存器翻倍缩水,活变量一多就互相踩踏,循环展开系数要随之回调。这两条暗礁与底层缓存行为联动,调优时往往要在向量长度、分组、展开度之间做三角权衡——没有一键最优,只有实测说话。
图 5-2 一个向量寄存器的元素视图
工程现场:滤波负载上向量化的完整收益核算
背景:边缘音频设备的三百二十抽头有限冲激响应滤波,标量实现每帧处理延迟超标,目标是延迟减半。
操作:先用性能分析器定位热点,确认九成时间在乘加内循环;随后按本节方法改写内层:外层循环遍历输出样本,内层用向量乘加遍历抽头系数数组,vsetvli 放循环外一次性配置(长度固定时无需每轮重算),LMUL 选二增加每轮吞吐;数据布局上把系数数组按四字节对齐整理,消除跨步访存。
结果:在一颗五百一十二位向量宽度的实现上,内层每轮处理十六个抽头,滤波延迟降到标量版本的三成;同一份二进制换到同事的一百二十八位开发板上重跑,延迟也降到了四成半——代码一行未改,只是宽度旋钮自动收窄。
解读:这个案例验证了可变长设计的核心承诺(二进制跨宽度通用),也暴露了代价核算的必要性:向量寄存器堆的面积与功耗不小,低功耗产品若负载里向量化机会稀少,拼 V 就要重新掂量——扩展选型永远回到"你的负载里有多少成批规整数据"这个原问题上。
变式:把内层循环改成带掩码的条件累加(只累计幅度超过阈值的样本),观察掩码如何消灭分支;再试着把 LMUL 从二调回一并加大循环展开,对比寄存器压力与吞吐的变化——两个变式分别通向分支消除与调度调优两条进阶路。
本节要点回顾
- 可变长是设计灵魂:指令表达意图、硬件报告能力,一份二进制跨宽度通用;
- 两个旋钮:元素宽度选精度,寄存器分组选容量,组合决定每轮吞吐;
- 长度寄存器吞掉残余:请求与容量取小,传统 SIMD 的标量尾巴循环被一个机制消解;
- 掩码消灭分支:v0 当位图,逐元素决定参与与否,条件逻辑向量化的正路;
- 暗礁在布局与压力:跨步访存伤带宽,LMUL 过大伤调度,三角权衡靠实测裁决。
向量解决的是算力密度。但当一台物理机器要同时伺候多个互不信任的租户,光快还不够——下一节的两阶段翻译与安全原语,处理的是隔离与信任的课题。