2.2 冗余设计:为故障而设计
2.2 冗余设计:为故障而设计
本节摘要:冗余是用钱和复杂度换可用性的系统化学科。本节梳理 SCADA 里五类典型冗余对象(通道、网关、采集服务、网络、电源),对比主备热备、双机双网、环形网络三种主流手法,给出冗余配置的验收标准——切换时间、数据完整性、告警一致性——并提醒最容易被忽略的一课:没有演练过的冗余等于没有冗余。
先问一个反例式的问题
某项目验收材料里写着「系统采用双机热备,可用性达到 99.9%」。验收组要求当场拔掉主服务器电源演练,结果备机接管后操作员站全部掉线——画面服务配置里写死了主机的 IP。材料上的 99.9% 和现场的零分之间,差的不是设备,是切换路径没有被验证过。冗余设计的第一课:冗余是「设计 + 实现 + 演练」三件事,少一件都不算数。
一、先列冗余对象,再谈手法
不是所有部件都值得冗余。先把系统的单点列出来,按「故障概率 × 停摆代价」排序,把预算花在刀刃上。SCADA 里典型的冗余对象有五类:
通道冗余。 站端到中心的通信链路走两条物理上分离的路由:主用光纤环网,备用无线或运营商专线。设计要点是两条通道不能共享同一条沟、同一座桥、同一个光交接箱——物理同沟的「双路由」在施工挖断时是双双殉职的。
网关冗余。 站端边缘网关双机,或采用双电源双网口工业级设备。断链缓存能力是网关冗余的隐性关键:切换期间的数据要补传,不是丢掉。
采集服务冗余。 中心前置服务器双机热备,主机负责轮询与接收,备机同步状态。切换时最怕「重复遥控」——主备同时给同一台泵发启动指令。所以采集服务的冗余必须带命令互锁:同一时刻只有一台有发令权,切换时要先收权再放权。
网络冗余。 中心局域网双星结构(两台核心交换机、每台服务器双网卡各上联一台)或全环网结构(工业以太网环网协议,断一点绕行)。
电源冗余。 双路市电加 UPS,现场站配后备电池。多数「系统宕了」的现场事故,最后追到根源都是配电——电源冗余的性价比高于一切服务器冗余。
二、三种主流手法与各自代价
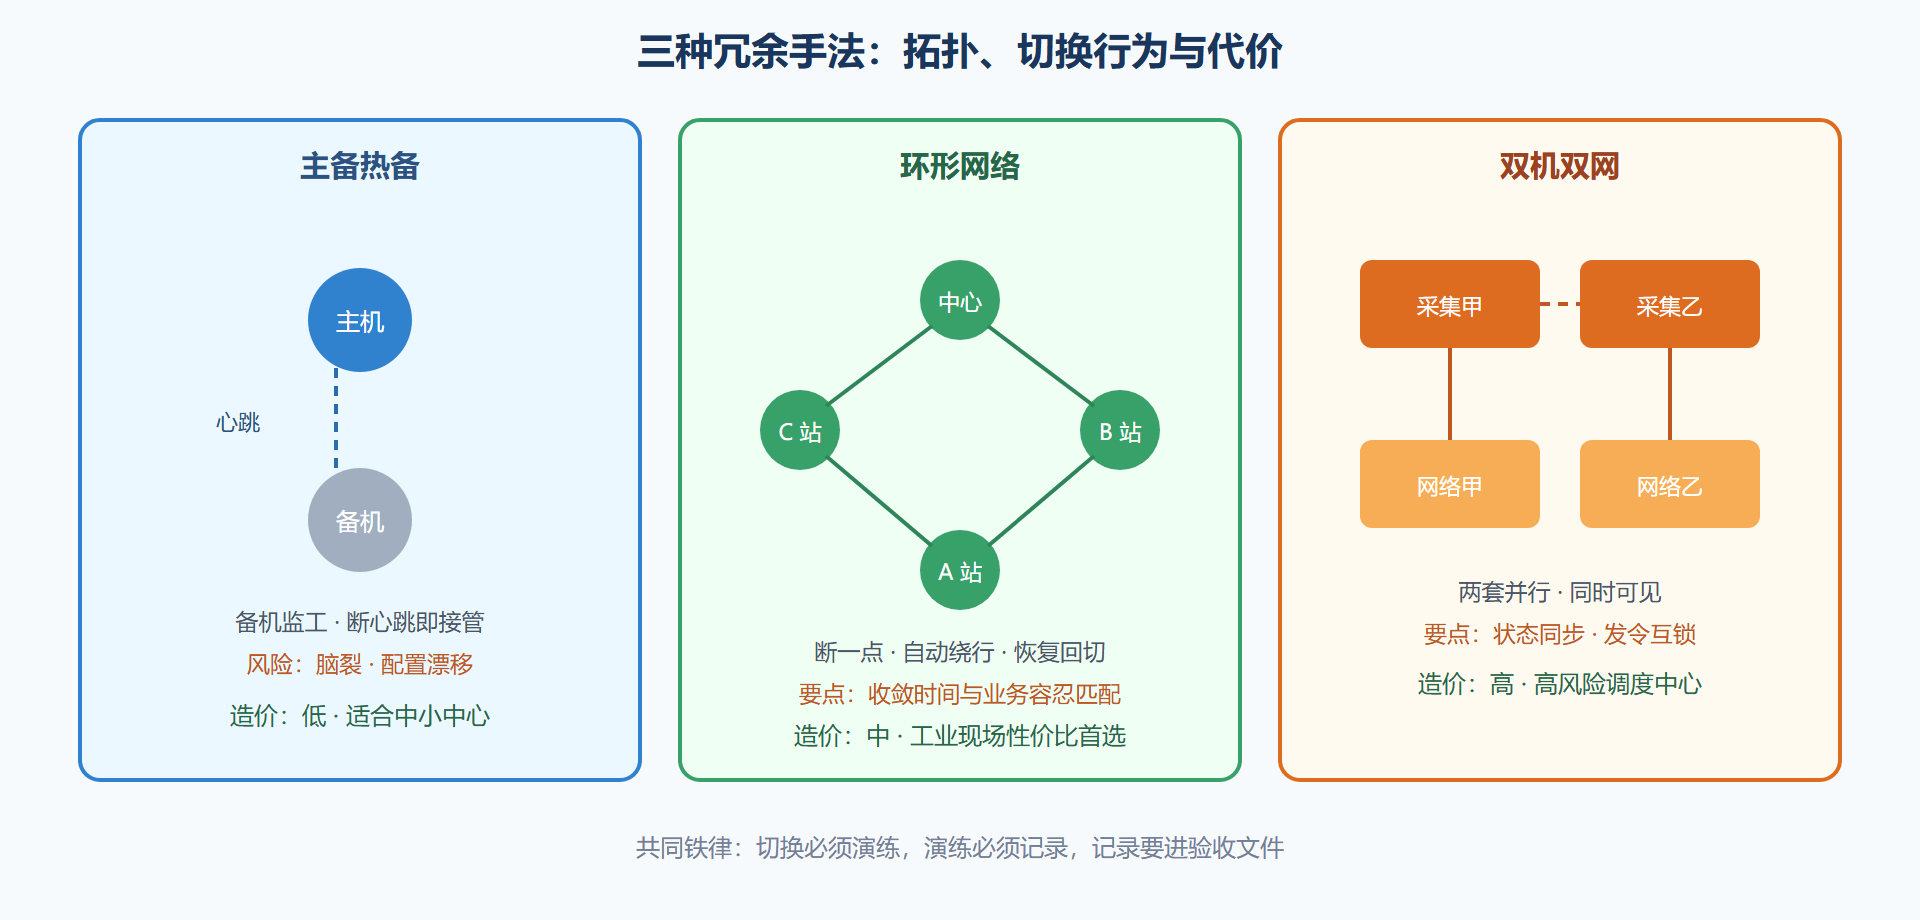
主备热备:一台工作、一台监工,心跳断了备机接管。代价是备机平时不产出;风险点是「脑裂」——两台都认为自己是主机,同时发令。工程上用独立心跳线加仲裁机制压住脑裂风险。
双机双网:两套并行的采集与网络,客户端同时连两套。可用性最高、造价也最高,适合遥控风险高、中断代价大的调度中心。风险点是数据一致性:两套系统的报警确认状态、人工置数要保持同步,否则操作员看到两个「真相」。
环形网络:所有节点串成环,断一点自动绕行,恢复后回切。造价介于两者之间,是工业现场的性价比之选。要点是环网协议的收敛时间要与业务容忍匹配:毫秒级倒换的环网协议贵,百毫秒级的便宜,泵站轮询业务用后者绰绰有余。
图 2-2 三种冗余拓扑与切换行为对比
三、切换验收:三个硬指标
冗余验收不能停留在「有备机」。三项硬指标必须实测:
切换时间。 从注入故障到业务恢复的时长。采集服务热备通常要求秒级(比如不超过十秒);环网倒换看协议,百毫秒级即可满足轮询业务。切换时间的验收方法简单粗暴:拔电源、拔光纤,掐表。
数据完整性。 切换窗口内的数据不能丢。验法是切换前在站端注入若干变化量,切换后到历史库里核对曲线是否连续、缓存数据是否补传完整。
告警与状态一致性。 切换后新主机上的报警确认状态、人工置数、遥控闭锁标志必须与切换前一致。这一项最容易漏验,也最容易在真实事故中造成「二次误判」——操作员以为已经确认过的报警又弹出来,第一反应往往是系统坏了,而不是去看工艺。
四、案例:一次演练暴露的三个问题
某调度中心的年度演练,剧本是「主机电源故障,备机接管」。演练实录值得逐条读:拔电后,备机十五秒内完成接管,切换时间达标——但,第一,两台操作员站因为写死主机 IP 掉线,靠手工改配置才恢复,暴露「冗余服务依赖单点配置」;第二,切换窗口内三号泵站一批流量数据丢失,暴露网关缓存参数配置过短;第三,恢复主供电后,原主机自动抢回主机角色,导致第二次切换,暴露「回切策略」没有定义。三个问题里没有一个与设备选型有关,全部是设计遗漏与参数疏忽——这正是演练的价值:它检验的不是设备,是设计闭环。
变式思考:如果演练剧本换成「主备同时断电再恢复」,上述三个问题之外还会暴露什么?把这个问题带进你们的下次演练,答案通常比预想的难看。
五、冗余之外的韧性手段
冗余不是提升可用性的唯一手段,另外三件武器经常被遗忘,而它们的性价比往往更高。手段一:降级运行设计。 明确写出「失去某组件后,系统保留哪些能力、放弃哪些能力」:失去中心,站端自治维持本地供水;失去一条通道,轮询周期自动放宽一档而非全军压上备用通道。降级剧本写清楚并演练,系统在故障时表现出的是「从容变少」而不是「慌乱崩塌」。手段二:快速恢复能力。 备件常备与更换 SOP(控制器、网关、电源模块整备件各留合理数量),恢复时间目标明确——一支训练有素的更换流程,能把四小时的外购等待压缩到半小时。手段三:防误操作设计。 冗余系统切换期是最容易误操作的时刻:切换按钮加确认、切换期间遥控自动闭锁、状态指示一眼可辨。这些不是可用性指标,是「不把小事故放大成大事故」的韧性设计。
三类手段与冗余的关系是互补而非替代:冗余保「不断」,降级保「失守不灾难」,快修保「断了能回」,防误保「救人时不添乱」。设计文档里建议为每类对象写一行「失效剧本」:它坏时会怎样、系统如何降级、谁来恢复、多久恢复——能写出这四问答案的架构,才算真正「为故障而设计」。
六、冗余设计的成本账
为决策者准备一笔明白账。冗余的成本不只是设备翻倍的三部分:初始投资(设备与安装,通常可见);运维复杂度(主备一致性维护、演练组织、故障切换的技能要求,常被低估);故障面变化(冗余机制自身也会坏——切换逻辑失灵、脑裂、备件版本落后,都是新增的故障模式)。收益侧同样有三笔:中断损失规避(按业务每小时损失折算)、非计划停机减少(统计口径的历史数据)、检修窗口灵活化(有冗余才能不停机检修,这笔隐性收益最常被忽略)。
水厂项目的经验口径:中控核心与广域通道做全冗余(中断影响面大、损失难估);单站网关做「设备可靠 + 缓存兜底」而非双机(单站影响面有限、双机投资与运维不划算);末端仪表不做冗余、用维护与备件保可用性。冗余决策的纪律一句话:为「断不起」的环节买冗余,为「断得起」的环节买流程。
本节要点回顾
- 先排序再花钱:按故障概率乘停摆代价给单点排序,通道、网关、采集服务、网络、电源五类对象逐一过。
- 三种手法三种代价:主备热备便宜但要防脑裂,环网性价比高要匹配收敛时间,双机双网可用性最高要管好状态同步。
- 切换验收三指标:切换时间掐表实测、数据完整性核对曲线、告警状态一致性逐项确认。
- 演练是冗余的最后一道工序:没演练过的冗余等于没有冗余。
冗余解决「坏了怎么办」,下一节解决「长了怎么办」:扩展性与开放性的设计契约。