5.3 历史数据库与报表体系
5.3 历史数据库与报表体系
本节摘要:历史库把瞬间数据沉淀为可回溯资产,报表把沉淀数据翻译成管理语言。本节讲历史存储的两个核心机制——采样策略与压缩算法,给出保留年限与容量的规划方法,再搭一套「运行报表、管理报表、对账报表」三层报表体系。水厂项目的月度水量平衡对账案例会展示报表体系的真实价值。
数据的第二次生命
一个测点的数据在实时库里只活一瞬——被新值覆盖就消失了。历史库赋予它第二次生命:三个月后追查一次水质波动,它还在;三年后评估工艺改造效果,它还在;十年后审计追溯,它还在。但第二次生命是有条件的:采样策略留住了变化的细节、压缩没有扭曲曲线的形状、保留年限覆盖了追查窗口、备份扛住了磁盘故障。本节按这四个条件展开。
一、采样策略:不是越密越好
历史采样的常用策略是「变化存储」:值变化超过死区才记录,其余时间只存周期哨兵值。它天然与 3.2 节的变化检测呼应,把存储量压到「有效变化」的量级。参数整定的原则与信号层相反——信号层死区防噪声,历史死区保形状:死区过大,曲线削峰填谷,追查波动时失真。水务场景的常用口径:参与工艺分析与对账的量(流量、液位、水质)死区从严,纯监视量从宽。
快照周期的意义常被误解:变化存储之下,快照(定时无条件记录)不是保细节的,是证伪「数据死了」的——一个点若长期既无变化记录又无快照,你无法区分「真的没变」和「采集断了」。周期哨兵值就是留痕。
二、压缩:在保形与省空间之间
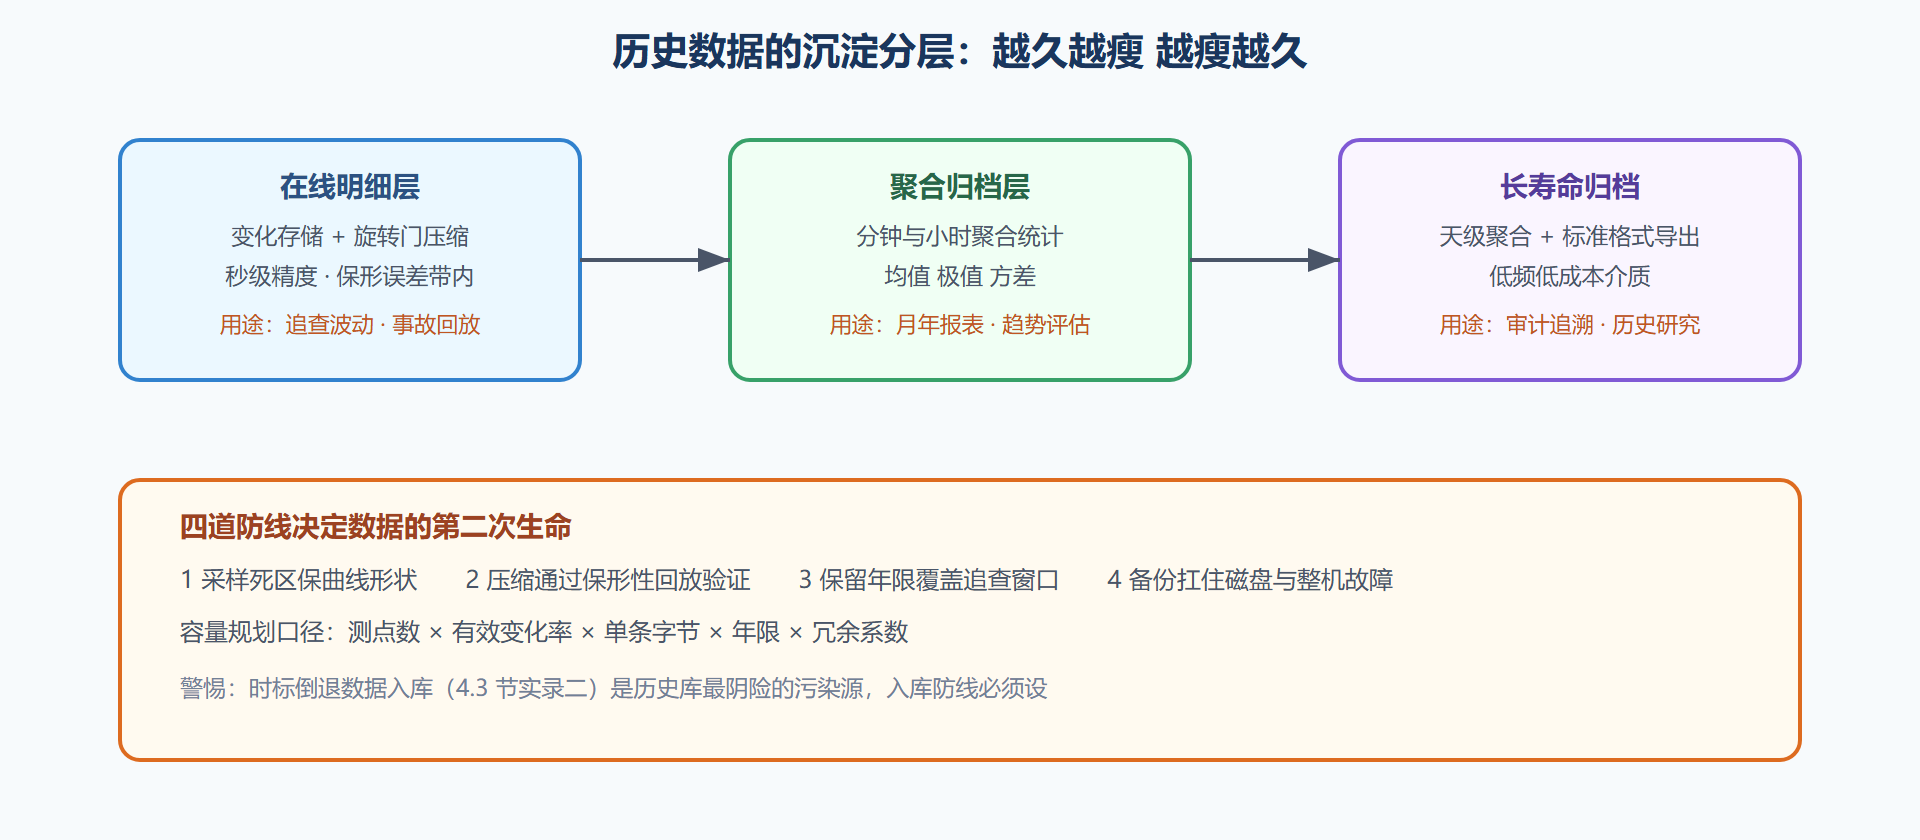
时序压缩的两类主流算法各有取向:回摆矢量压缩(典型如旋转门算法)按「下一值落在误差带内则不存」的思路丢弃可插值点,失真可控、比例高,适合长期在线历史;降采样聚合按分钟、小时、天逐级聚合存统计量(均值、最大、最小、方差),原始明细保留期短、聚合层保留期长,适合多级归档。工程实践常两者结合:在线层用旋转门保形存明细,归档层用聚合做长寿命。选型的验收标准只有一条硬的:压缩后曲线还原与原始数据的偏差不超过设定误差带——用一段已知剧变(工艺扰动实录)做样本回放比对,是验证压缩保形性的捷径。
图 5-3 历史数据的多级沉淀与用途分层
三、容量与保留:按追查窗口倒推
保留年限不是拍出来的,是按追查窗口倒推的:工艺波动追查窗口按季度计,水量平衡审计按年计,设备寿命评估按大修周期(数年)计,行业监管有要求的长项(水质、安全)按法规年限计。各窗口叠出各层的保留策略,容量按下式估算:测点数 × 有效变化率 × 单条字节 × 年限 × 冗余系数。水厂项目的示例数量级:两万测点、平均每点每天数千条有效记录、明细保留一年,原始库在 TB 量级;聚合归档五年,增量每年百 GB 级——明细与归档差一个量级,这正是分层存储的经济性来源。备份策略的底线:历史库备件的恢复演练纳入年度计划,「有备份没恢复过」等于裸奔。
四、报表体系:三层结构与对账机制
运行报表(班组级,日与班次粒度):水量电耗药耗、设备运行时长、报警统计。它服务交接班,字段固定、自动生成。管理报表(厂级与集团级,月年粒度):单耗指标、能耗对标、水质达标率。它服务考核,口径必须与运行报表一致。对账报表(跨系统,不定期的常态化机制):SCADA 水量与营业抄表水量、电业电表与自计电量的比对——它平时不显山露水,出问题时是定位「数据环节还是物理环节」的第一裁决。
对账机制值得单独强调。4.3 节实录二里「水量平衡对不上」暴露时钟污染,靠的正是水量平衡对账。把对账从「出事才查」变成「每月例行」,等于给全链路数据质量装了一台持续运转的自检仪:数据坏 anywhere,对账差 somewhere。
五、案例:一次月度对账揪出的量程漂移
某月对账报表显示:出厂水流量累计比滤后水累计高出固定比例,连续三个月偏差稳定在相近幅度。工艺上两表串联不该有差——先怀疑表计,现场校验发现滤后水电磁流量计因衬里结垢实际特性偏移,量程组态却一直按铭牌未动。整改计量后偏差归零。案例的解读:对账报表没有「报警」功能,只有「差异」语言——稳定比例的差指向系统性因素(量程、系数、口径),随机波动的差指向干扰或故障。读对账报表的手艺就在区分这两类差。变式思考:若偏差不是稳定比例而是每天早晚各跳一段,你会先查哪个环节?提示:时段相关先想工艺与泵组调度,再看计量滞后。
六、数据服务的边界:历史库也是被消费方
现代历史库早已不是「存曲线的硬盘」,它是对内对外的数据服务中枢,因此也需要服务化的边界设计。取数接口分层:明细取数(小窗口、高精度)、聚合取数(长周期、分钟以上粒度)、统计取数(日报月报口径),三类接口分开,避免分析型大查询与实时落盘抢资源——5.1 节「分析独立部署」的原则在接口层同样生效。订阅与推送:上级平台、能耗系统常要持续取数,订阅接口带过滤与限流,防止一个下游的失控轮询拖垮出口。口径集中:单耗、水量累计这类统计口径只在服务层实现一份,报表与第三方共用——口径散落在各处报表里的系统,迟早会出现「两个会议两个总水量」的尴尬场面。
七、案例延伸:报表体系怎么「倒逼」数据质量
对账报表的价值在上一节案例已经展示,这里补一个组织层面的观察:报表体系一旦例行运转,它会反向塑造整个链路的数据质量。运行班组知道水量数据每月要过平衡对账,端子松动导致的坏质量会主动上报(反正对账会暴露);维护员知道仪表漂移在月度报表上现形,校验周期从「规程要求」变成「自己要脸」。数据质量的最高境界不是考核出来的,是「谁也糊弄不了」的机制环境养成的——历史库与报表体系就是这个机制的物理载体。给项目管理者的建议:报表体系的建设优先级应高于它的表面价值,它买到的不只是几张表,是一条持续自检的数据质量流水线。
本节要点回顾
-
变化存储 + 哨兵快照:死区保形不削峰,快哨兵证明「数据活着」。
-
压缩验收看保形:用真实扰动样本回放比对误差带,不轻信压缩率数字。
-
保留按追查窗口倒推:工艺按季、对账按年、大修按周期、监管按法规;分层存储省钱省心。
-
报表三层 + 例行对账:运行、管理、对账各司其职;对账是全链路数据质量的自检仪。
监控中心三件套齐了。下一章换一个视角:站在防御者立场,为这条链路设计安全边界。