5.3 SimEvents离散事件仿真
5.3 SimEvents离散事件仿真
本节摘要:测试线上的电机是"一个个通过工位"的实体,不是连续变化的曲线——这类问题没有微分方程,时钟直接从事件跳到事件。SimEvents 用实体、队列、服务器、调度四类积木表达这种世界。本节用一条电机下线测试线做完整案例:建模、找瓶颈、评估两个改善方案。读完本节,你会认出自己工作里哪些问题属于事件流,以及何时该从连续仿真切到事件仿真。
换一个世界:没有时间步的仿真
前面四章的仿真里,时间像流水一样连续推进,求解器守着每一个时刻。测试线的世界不是这样:电机 9 点 00 分上料、9 点 17 分进入空载测试、9 点 31 分离开——有意义的只是事件时刻,两个事件之间什么都没发生。硬用连续仿真表达这种世界,就像用微积分记一笔一笔的账:能算,但完全拧巴。
SimEvents 的时间观是跳到下一个事件:时钟停在事件 A,处理完,直接跳到下一个事件时刻 B。仿真的核心对象是实体(Entity,电机下线测试里就是一台台电机)与处理它们的设施:队列排队等候、服务器占用一段服务时间、调度与路由决定谁先谁后去哪里。产出的指标天然就是管理语言:各队列长度、各工位利用率、实体逗留时间、吞吐量。
案例全程:下线测试线的节拍诊断
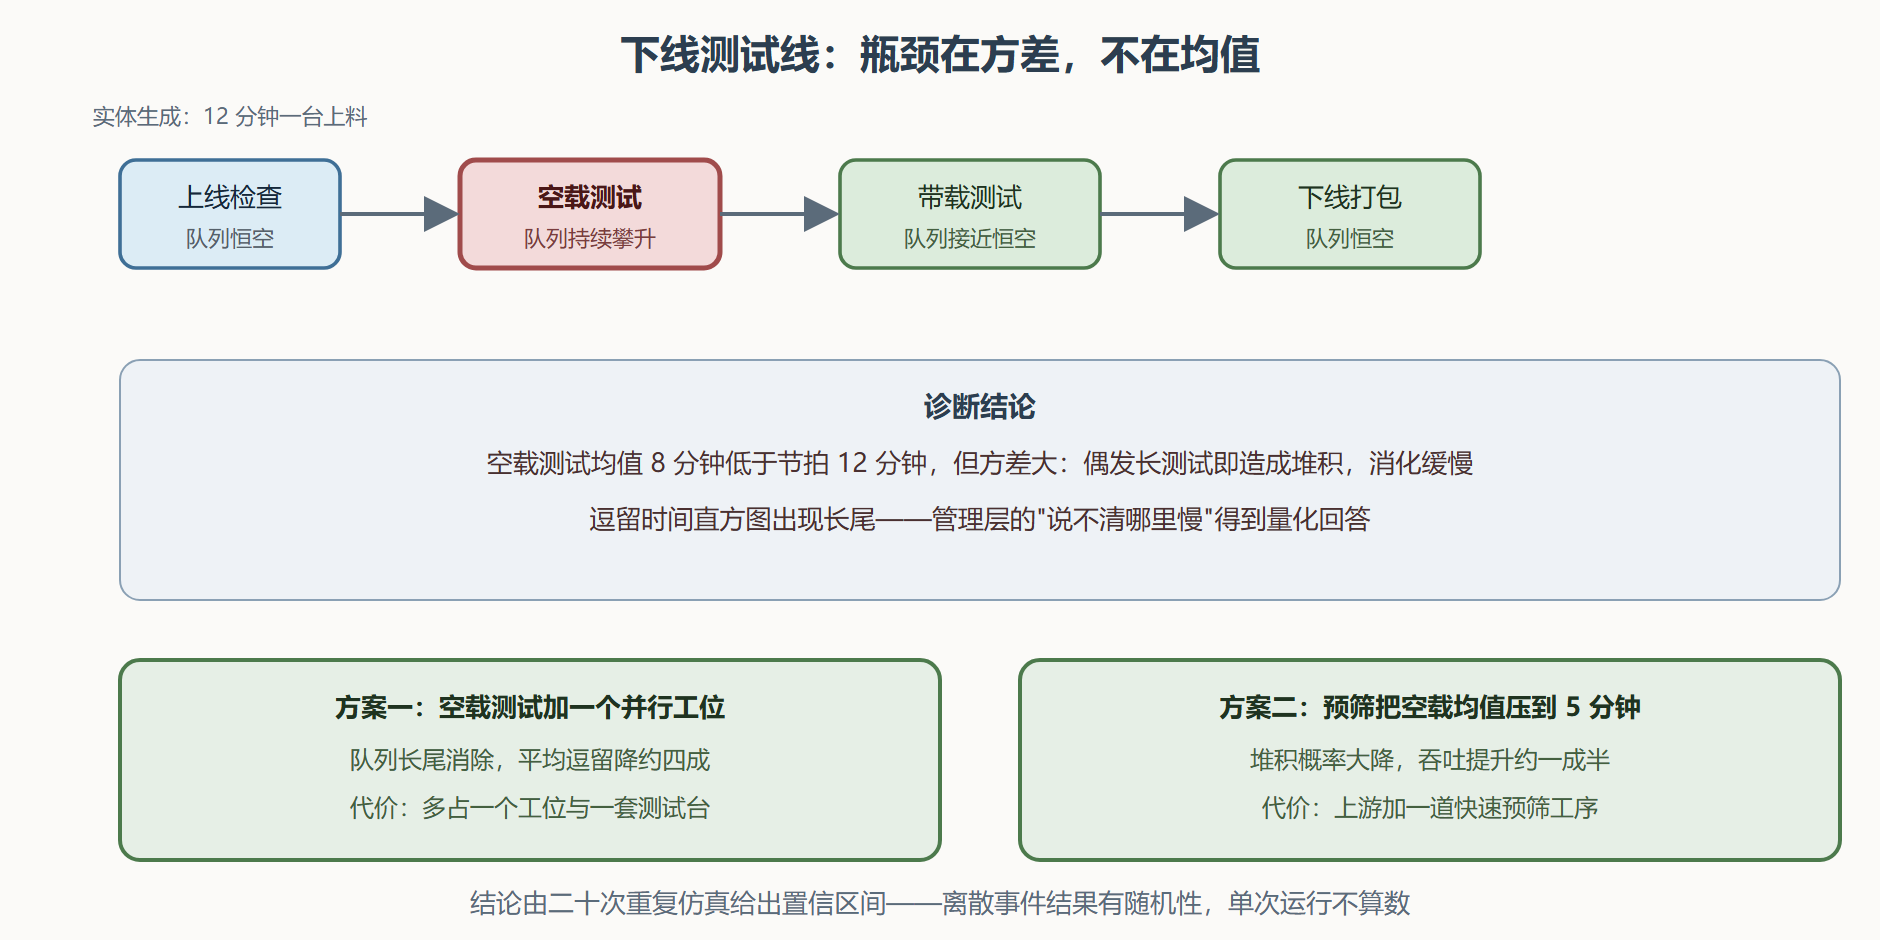
测试线四道工序:上线检查(均值 2 分钟)、空载测试(均值 8 分钟,方差大)、带载测试(均值 10 分钟)、下线打包(均值 3 分钟)。电机按 12 分钟一台上料。管理层的抱怨是"产线说不清哪里慢"。用 SimEvents 搭线:实体生成器按 12 分钟节拍发料,四个单服务器串联,每个服务器前带队列,仿真一个班次八小时,重复跑二十次取统计。
结果会说话:上线、带载、下线的队列几乎恒空,空载测试前的队列长度在班次中段稳定攀升,逗留时间的直方图出现长尾。瓶颈清晰指向空载测试——它的服务时间均值 8 分钟看似低于 12 分钟的节拍,但方差大,偶尔一次 25 分钟的长测试就让后续电机堆积,而堆积消化得很慢。这是离散事件世界的经典陷阱:看均值够用,看方差要命。
% 测试线模型的批量实验脚本 load_system('test_line_se'); scenarios = struct( ... 'name', {'现状', '方案一 双工位', '方案二 缩短并预筛'}, ... 'n_servers', {[1 1 1 1], [1 2 1 1], [1 1 1 1]}, ... 'mean_fat', {[8 10], [8 10], [5 10]}); for k = 1:numel(scenarios) apply_scenario('test_line_se', scenarios(k)); % 按场景改服务器数与均值 stats(k) = sim('test_line_se', 'StopTime', 8*3600); fprintf('%s:平均逗留 %.1f 分钟,吞吐 %.2f 台每分钟\n', ... scenarios(k).name, stats(k).avg_dwell/60, stats(k).throughput); end % 重复 20 次取置信区间:离散事件结果有随机性,单次运行不算数
图:测试线瓶颈诊断与方案对比
两个改善方案的量化
方案一给空载测试加一个并行服务器(双工位)。仿真结果:队列长尾消失,平均逗留时间下降约四成,吞吐小涨。方案二不改工位,改为在上线检查里加一道快速预筛,把空载测试的均值从 8 分钟压到 5 分钟。结果:堆积概率大幅下降,吞吐提升约一成半。两案对比还带来一个管理洞见:方案一提升的是"堆积后的消化能力",方案二削减的是"堆积的发生概率"——预筛几乎总比加工位便宜,这是排队论的日常智慧。
实验方法上有一条铁律不同于连续仿真:离散事件模型含随机源,单次运行的结果是抽样不是结论。每个场景至少重复二十次,报均值加置信区间;重复次数不够就下结论,与连续仿真里不做收敛检查同罪。
什么时候切换到事件仿真
判断标准一句话:研究对象是"流动的个体"还是"连续演化的量"。个体流动(产线、物流、维修站、网络包)用事件仿真;量连续演化(转速、温度、电压)用框图。两者也有交集:测试台上单台电机的测试过程本身是连续的,但"一台接一台"的组织层面是事件流——SimEvents 支持在实体服务过程中嵌入 Simulink 模型,事件层调度、连续层执行,两层各用各的时钟。这种嵌套用在"产线节拍受单站物理过程影响"的场合,比如带载测试时长本身取决于电机瞬态响应的统计分布。
⚠️ 常见坑:把实体属性当信号用。实体属性是"跟着个体走的行李",不是随时可读的状态量;想在连续层读"当前队列长度",要用队列的统计端口而不是翻实体属性。
常见问题
问:服务时间与到达间隔的分布怎么定?随便设个均值行吗?
分布形状与均值同等重要。定分布前先问数据:有实测记录就拟合经验分布;只有均值与方差就选个形状合理的理论分布(服务时间常用对数正态,到达间隔常用指数或爱尔兰);完全没数据,至少做敏感性分析——均值加减两成各跑一轮,结论方向不变才敢用。本节的空载测试案例已经演示了"形状比均值致命":均值一样的两个分布,方差大的那个能把产线拖垮。随便设均值等于把诊断结论建立在沙子上。
问:仿出来的指标怎么向管理层报告才有说服力?
三个要素缺一不可:点估计(平均逗留多少分钟)、区间(置信区间宽度,说明结论的稳定性)、对比基准(相对现状改善几成,而不是绝对值单打独斗)。再加一张逗留时间直方图——管理层对"长尾"的直觉理解远好于对均值的理解。所有数字标注重复次数与置信水平,让"这是统计结论不是精确预言"写在明面上。
本节要点回顾
- 时间观切换:事件世界时钟直接跳变,实体、队列、服务器、调度是四类基本积木;
- 均值够用、方差要命:瓶颈常藏在服务时间方差里,逗留长尾是它的指纹;
- 两案对比的洞见:加工位治堆积之后,预筛治堆积之前,后者通常更便宜;
- 重复二十次:随机模型必须报置信区间,单次运行不是结论;
- 切换判据:研究对象是流动个体还是连续演化量,嵌套模型处理两层并存;
- 实体属性不是信号:队列长度读统计端口,别翻行李。
三种范式扩展到此集齐。模型能表达的多了,管好它们的需求也来了——第 6 章转向数据与脚本。