9.2 自定义库与封装
9.2 自定义库与封装
本节摘要:成熟子系统反复复制粘贴的日子,应该结束在封装与库手里。封装把子系统的参数对话框改造成领域语言("带宽"而不是"增益系数"),图标与端口标签让模块自解释,参数校验在对话框层拦截错误;库则让"改一处、处处生效"取代"复制十份、改漏三份"。本节走完从子系统到受管库模块的晋级之路,并给出团队库的版本发布流程。
复制的代价:一个真实的事故模式
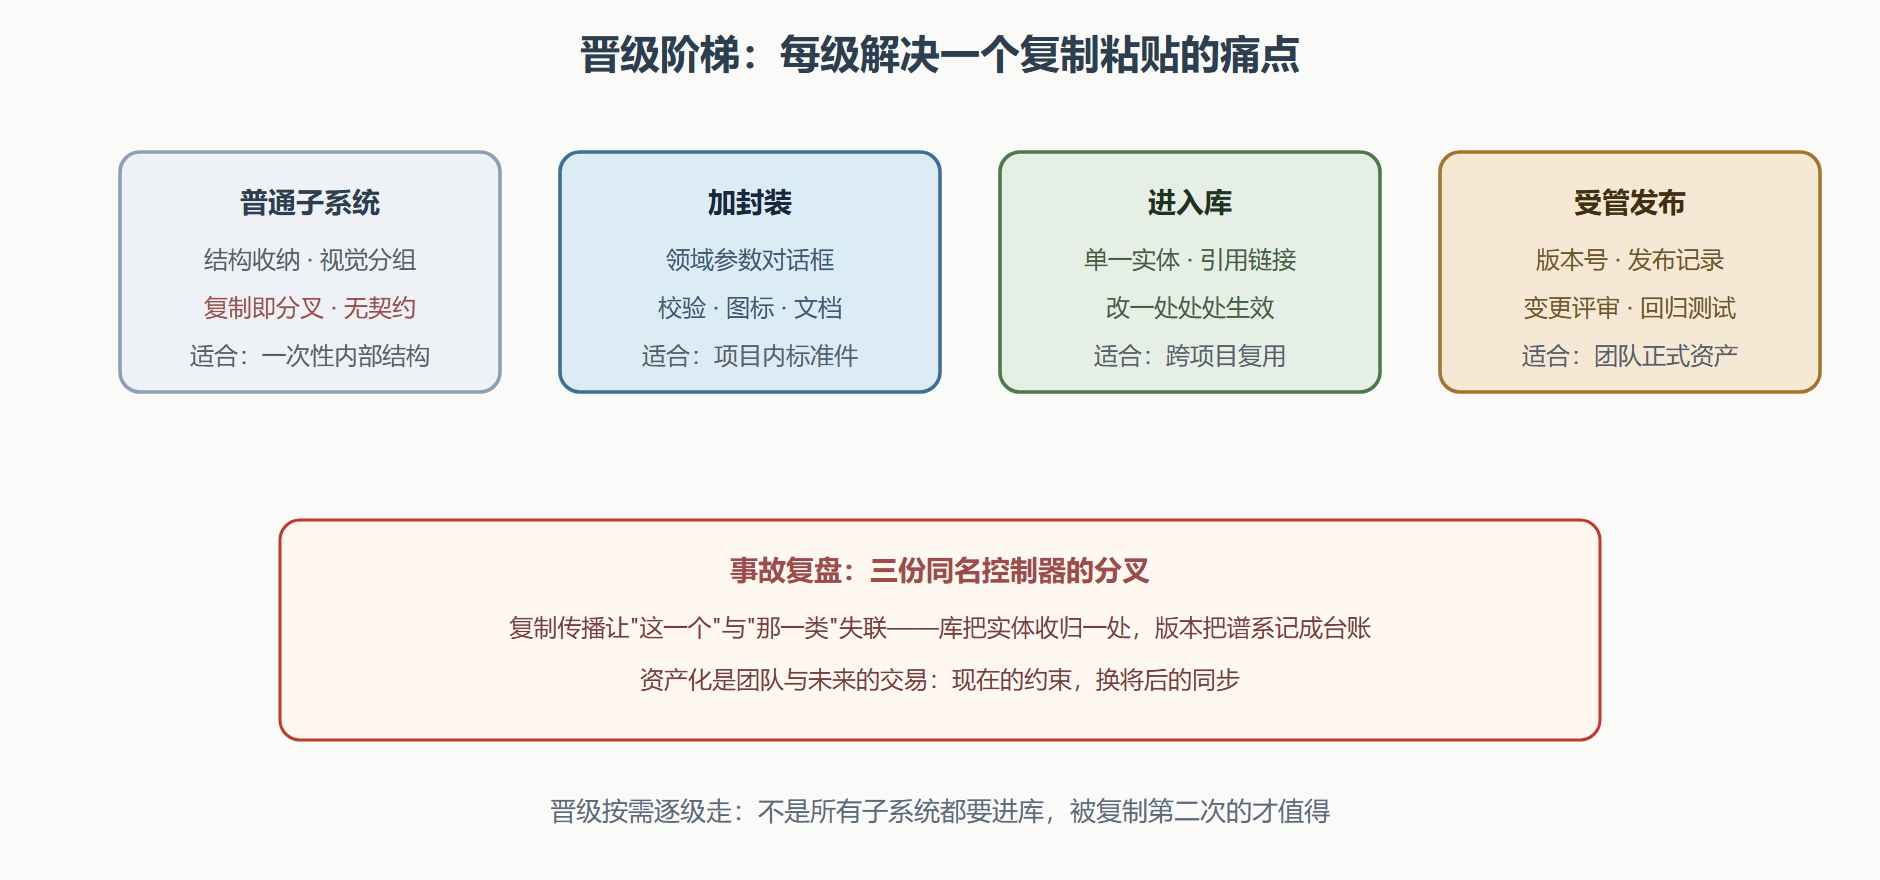
盘点一下第 4 章之后各项目的 PI 控制器使用史:项目 A 复制了子系统、项目 B 又复制了一份、C 项目复制时顺手改了抗饱和逻辑……十四个月后,质量组发现三份"同名"控制器的抗饱和行为互不相同,其中一份的偏差已经流进了交付报告。事故的根源不是谁改错了,而是复制传播让"这一个"与"那一类"失去了联系——没人能回答"全公司有几份控制器实现、各自基于哪个版本"。
库机制正面回答这两个问题:库模块在模型里只是引用(链接),实体只有一份,住在受管理的库里;库实体升级,所有引用方在下一次刷新时同步。配合版本号与发布记录,"有几份、基于哪版"变成两个可查询的事实。复制的便利是即时的,代价是滞后的;库的约束是即时的,收益同样是滞后的——资产化本质上是团队与自己的未来做交易。
封装:把模块包装成领域语言
封装(Mask)是对子系统的四层包装。参数层:把内部一堆增益与时间常数,收敛成对话框上的"带宽""阻尼比""限幅值"——使用者用控制领域的语言配置,不必理解内部结构;每个参数带校验表达式,越界值在对话框上就被弹回。图标层:用绘图指令画出传递函数示意或自制标识,端口标签标注信号名——模块在图上自解释。描述层:文档字段写清用途、假设、引用规范条款,悬停即见。初始化层:封装回调把领域参数换算成内部参数(带宽换算为离散系数),换算逻辑只写这一处。
% 封装参数校验与初始化回调(示意) % 对话框参数:bandwidth_hz(带宽)damping(阻尼比)duty_limit(限幅) % 校验回调: if bandwidth_hz <= 0 || bandwidth_hz > 200 error('带宽必须在 (0, 200] Hz 内,当前值:%g', bandwidth_hz); end if damping < 0.3 || damping > 2.0 error('阻尼比建议范围 [0.3, 2.0],当前值:%g', damping); end % 初始化回调:领域参数换算为内部参数(换算只写这一处) Kp_int = 4 * pi^2 * bandwidth_hz^2 / (Kt_motor / J_motor); Ki_int = Kp_int * 2 * pi * bandwidth_hz / 5; % 图标绘制指令:带阻尼二阶系统示意 % text: PI(v) 端口标签:ref / fb / duty
封装深度有个实用刻度:封装到"参数是领域语言、结构无需被看见"即可,不要追求把所有内部细节藏成黑盒——评审时仍需双击进入查看结构的场景是常态,封装的敌人是随意改动,不是可见性。
图:从子系统到受管库模块的晋级阶梯
库的运营:让复用发生在评审之前
库建好只是开始,没人找得到、没人敢用的库是纪念碑。三件运营小事决定库的活性。发现:库按域分区块(控制、滤波、接口、诊断),每个模块的描述字段写清"解决什么问题、何时别用";新人入职指引里放库的导览。发布:库带版本号(语义化:接口变更升大版本、行为修正升小版本),发布记录列出变更与迁移指引;引用方模型记录所用版本,升级走通知与回归——第 7 章的等效性测试在这里是标准动作。门槛:进库的模块必须自带单元测试 harness 与规范检查通过记录,"先审后收"保证库里没有未爆弹。
与 9.1 节合起来看:自定义 S-Function 也可以封装进库——解码器模块配上领域参数对话框后,就成了算法组的第二个标准件。数据资产(字典)与结构资产(库)在此时合流:模型工程的循环从"项目养资产"走向"资产反哺项目"。
💡 关键直觉:库模块的采纳率取决于"用它比重造省多少心"。参数是领域语言、文档悬停即见、版本可追溯——三个细节做齐,推广不需要行政命令。
封装参数的类型选择
封装对话框上的每个参数都有一种类型,选对类型能让校验与易用性双赢。编辑框配校验表达式,适合自由数值(增益、限幅),校验写范围与单位提示。下拉列表适合离散选项(滤波器类型、抗饱和策略),把"内部实现路径"的选择权以受控方式交给使用者,杜绝手填错别字。复选框适合开关型配置(是否启用前置滤波)。最小值与最大值成对参数(限幅上下限、频带边界)要加交叉校验——下限不得大于上限这类关系,单个参数各自校验拦不住,得在封装回调里补一条关系断言。参数描述字段里顺手写上单位与典型值,是零成本的易用性投资。
还有一个容易被忽略的维度:参数的可生成性。打算进代码生成的模块,封装参数要么标为运行时不可调(编译期定值,最省资源),要么正确配置为可调参数(进标定区)——两种选择的资源代价差一个数量级,按 8.2 节的预算来定,而不是默认一路带过。
一次库升级的完整流程
库的日常运营最容易在"升级"环节失守,给一个可照抄的流程。场景:PI 控制器库模块要修一个抗饱和的边界问题。第一步,在库的开发分支上修复,更新自带测试 harness(新增一个针对该边界的用例),全量用例绿灯。第二步,升版本号:行为修正升小版本,比如 2.3.0 到 2.4.0,发布记录写清"修复高带宽配置下抗饱和边界振荡,行为变化范围与迁移指引"。第三步,通知与 compat 评估:扫描全组织引用该库的模型清单(工程管理工具按链接路径检索),逐个评估新版本的影响面——这就是第 6 章"变更影响分析"在库资产上的形态。第四步,分批切换:引用方按项目节奏刷新链接,刷新后各自跑最小回归;主版本升级(接口变更)则保留旧版本并行发布一个过渡期。第五步,归档:旧版本进只读归档区,出问题可整体回退。
五步走完的库升级,引用方体验是"收到通知、按需刷新、回归绿灯";没有流程的库升级,引用方体验是"某天打开模型突然行为不对"。资产的可信度不是库建得多好决定的,而是每次升级的流程质量累积出来的。
本节要点回顾
- 复制是分叉的种子:同名实现的版本漂移是事故温床,库把实体收归一处;
- 封装四层:参数(领域语言加校验)、图标、描述、初始化回调,换算逻辑只写一处;
- 封装刻度:藏到"参数是领域语言"即可,评审仍可进入看结构;
- 晋级阶梯:子系统、加封装、进库、受管发布,按需逐级,被复制第二次的才进库;
- 运营三件:发现靠域分区与描述、发布靠版本与记录、门槛靠自带测试;
- 资产合流:数据字典管参数事实、库管结构事实,项目与资产互相反哺。
模型能扩展、资产能沉淀,最后一站回到每天的日常:仿真为什么慢、模型群如何不失控。第 10 章收拢全册。