2.1 计算核心子系统:簇、核与一致性
2.1 计算核心子系统:簇、核与一致性
第一章定下了 CK770 走定制 SoC 路线,本节开始往图纸里放第一件东西:计算核心。它是三大件中最"主动"的一件——存储与互连都是围绕"核要什么数据"来设计的,所以解剖从它开始。读完本节,你应当能判断一个产品该配几个核、大小核怎么分工、加速器挂在哪里,并能说清多核共用的缓存为一致性付出的代价。
一颗核不够,两颗怎么放
先立一个反直觉的判断:SoC 配多核,多数时候不是为了"算得更快",而是为了"算得更省"。单核性能靠提频和加深流水线换,两者都是功耗大户;而系统的真实负载往往是"一段重活加大量零碎"——重活交给少数大核,零碎交给小核轮班,比全体大核硬扛省电得多。这就是大小核配置的经济学:性能按峰值配,功耗按占用配,两者解耦。
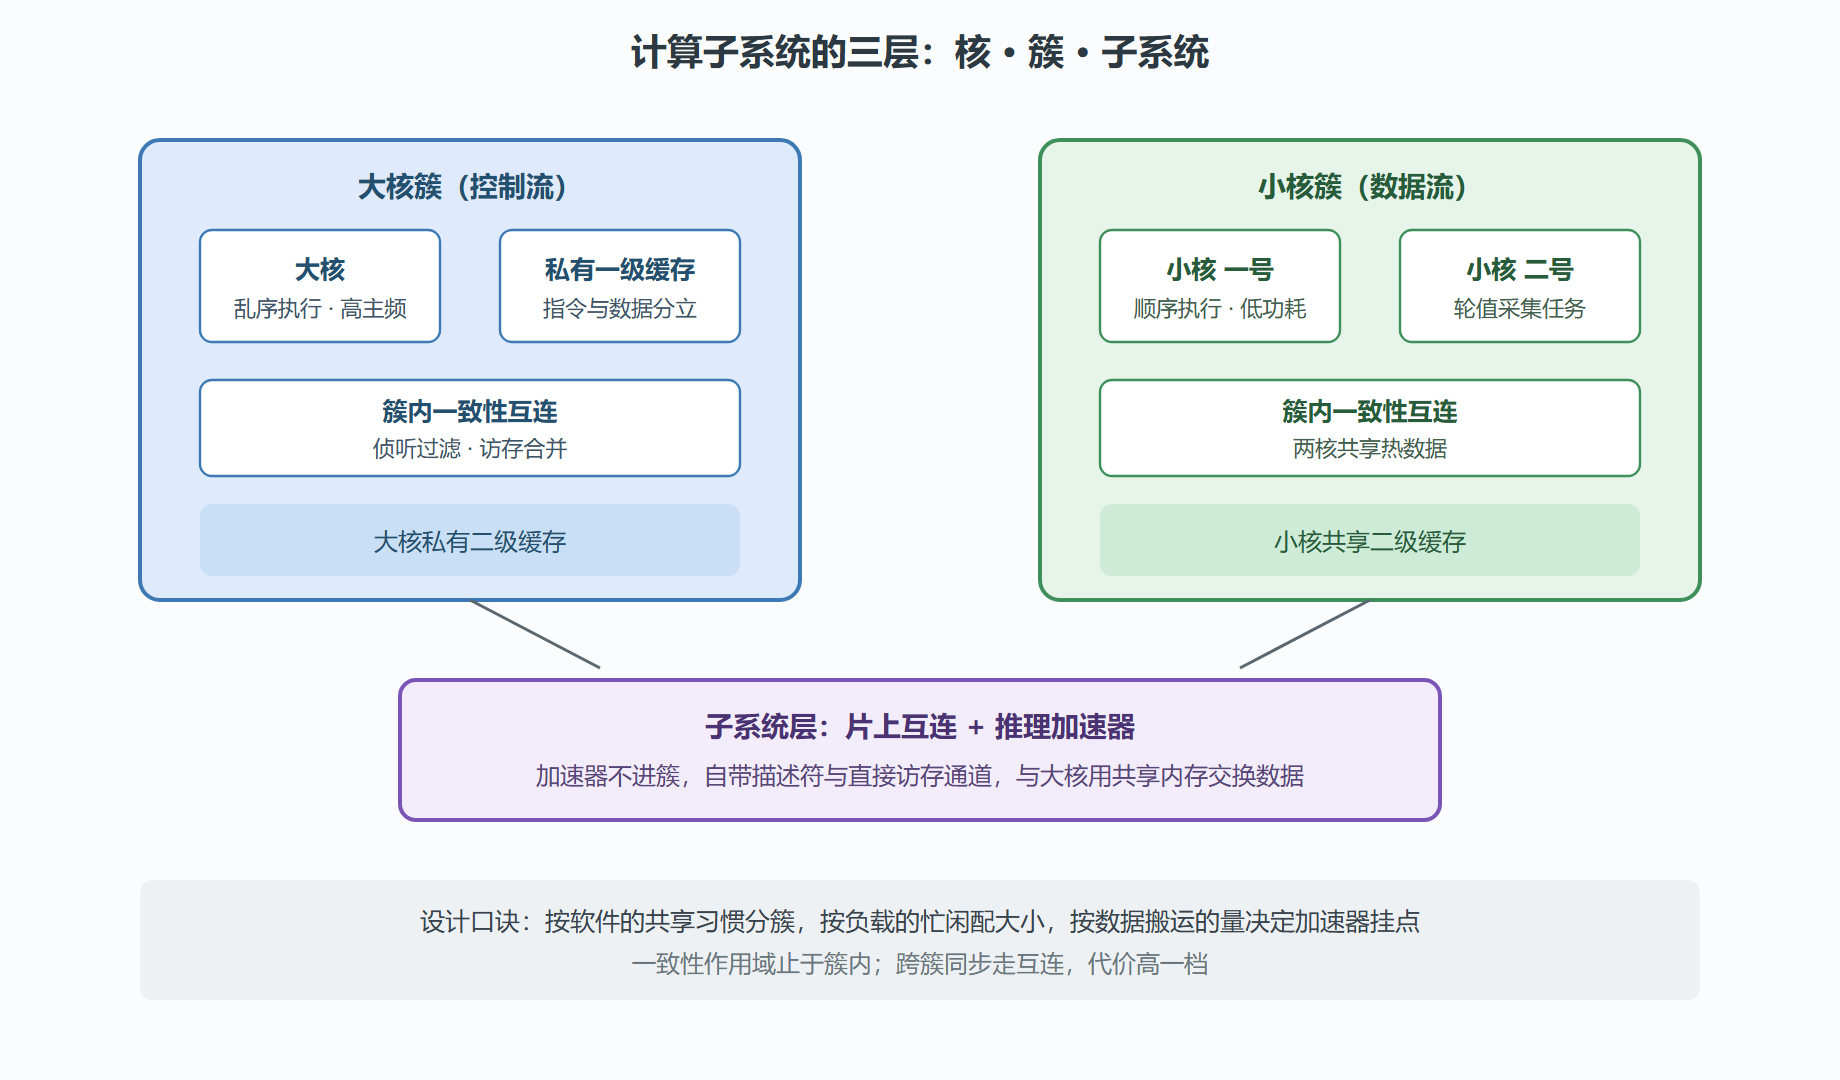
放在簇里看,核的组织有三层。最内层是单核:流水线、私有的一级缓存。中间层是簇:几颗核共享一级的缓存与一致性互连,簇内访存延迟最低。最外层是子系统:多个簇经片上互连连到共享的二级缓存或内存控制器。层与层的边界就是一致性的作用域——同簇核心的数据同步便宜,跨簇同步贵。设计配置时,"哪些核放一个簇"因此不是性能问题,而是软件会怎么共享数据的问题:经常共享工作队列的核放同簇,各干各的核宁可分簇。
CK770 的配置决策就落在这三层上:一个大核跑操作系统与协议栈这类控制流,两颗小核轮值传感器采集与数据预处理,一颗推理加速器负责矩阵计算。大核与小核不同簇——它们几乎不共享热数据,分簇后一致性流量最少;加速器不进任何簇,直接挂片上互连,理由下面展开。
图:CK770 计算子系统的三层组织
一致性:共享的代价怎么付
两颗核各自有缓存,又允许读同一份内存数据,麻烦立刻出现:一份变量在两个缓存里出现两个版本,以谁为准?一致协议就是给这个问题立规矩。主流做法可以用一句话概括——每个缓存行有身份状态,写数据前先取得独占权,别人读时把最新版递过去。规矩本身不难,贵的是执行规矩的信使:每次跨核写都要在簇内互连上跑一轮"作废或取走"的事务,这些一致性流量不搬业务数据,却实打实占带宽。
工程上的对策有三层。第一层是划分作用域:能塞进一个簇的共享就别跨簇,CK770 把大核小核分簇正是在压缩一致性流量。第二层是合并与过滤:簇内互连带侦听过滤器,一片缓存行只在确实被多核共享时才广播作废,私有数据从不打扰别人。第三层是软件纪律:把要共享的数据按缓存行对齐、把频繁写的计数器从共享数组里拆出去,避免"假共享"——两个互不相干的变量恰好挤在同一缓存行,导致两颗核为不相干的数据互相作废。假共享是软件团队最容易踩、也最容易修的一致性坑,架构评审时值得把这条写进协作约定。
加速器挂哪:一个常被放错位置的决定
推理加速器、压缩引擎、加解密单元,这类"数据搬运为主"的模块该挂在哪?错误答案是把它们当外设挂在外设总线上,让 CPU 用寄存器读写的方式喂数据。这样做的隐含假设是"CPU 搬得过来",而加速器存在的意义恰恰是数据量大到 CPU 搬不动。
正确做法是给加速器三件套:直接访存通道(不经 CPU 的数据搬运)、描述符机制(软件填一张任务卡,写明源地址、目的地址、长度,加速器自己取卡干活)、完成中断(干完通知)。三件套配齐后,CPU 的角色从搬运工变成派单员:填卡、按启动键、等中断。CK770 的加速器就按这个结构挂子系统层,与 2.3 节互连上的直接访存端口对接。顺带一提,这个"派单"模型在第四章的实验里会用代码完整实现一遍——那里你会看到描述符在内存里的真实模样。
案例复盘:CK770 核配置评审会
背景:架构评审会上,市场输入变了一版——网关要新增"本地异常检测"功能,推理频率从分钟级提到秒级。初版配置(一颗大核)的算力估算立刻破产,会议当场改议程,重算核配置。
操作。 团队把新负载拆成三类记账:操作系统与网络协议栈,指令分支密集、单线程性能敏感,记在大染名下;多路传感器采集与格式转换,负载规律、并行度高,记在小染名下;异常检测的矩阵推理,计算规则单一、数据量大,单独立项。对三类负载分别跑了基准测试的估算:大核留三成余量覆盖协议栈峰值,两颗小核按采集负载的一点五倍配置,推理引擎按算子模型反推矩阵单元规模。接着决策簇结构:大核独占一簇,小核合住一簇,理由如前——共享数据不出簇。
结果。 定案"一大两小一加速器",写进决策记录,同时记下两条风险:小核若被固件调度不当挤占,采集会抖动,要求软件团队提供轮值框架;加速器与 CPU 的共享内存交换在大批量时可能挤占互连,带宽余量移交 2.3 节的预算表核算——这条风险后来真的兑现了,成了 2.3 节那个超支案例的主角。
解读。 这场评审值得学的是用负载画像反推配置,而不是反过来拿配置硬套需求。三类负载的划分方法(控制流、数据流、批处理)可以套用到几乎任何 SoC 立项:先分桶,再对每桶选武器,最后检查桶与桶之间的数据通道。另一个细节是"当场改议程"——评审会的价值就在发现矛盾当场清算,拖到下一轮的成本是所有人的时间。
变式。 若产品没有推理需求,配置退化为"一大一小",加速器从预算表上划掉,互连压力骤减;若采集任务的实时性要求提到硬实时级别,小核簇还要补一个考虑项:能不能被高级中断打断、中断延迟多少,这就牵出第三章中断控制器与第五章排错的内容——配置决策从来不是孤立的格子,而是牵一串的线。
常见问题辨析
问:既然分簇能省一致性流量,为什么不大簇化或者干脆每核一簇?
两头都有代价。全塞进一个大簇,一致性互连的规模上去了,侦听广播的范围变大,访问延迟与面积同步上涨——省下的流量被更贵的互连吃回去。每核一簇则走向另一个极端:所有跨核共享都变成跨簇事务,走慢路,软件里哪怕最普通的锁与队列都变贵。簇规模的 sweet spot 在"经常共享工作队列的核恰好装得下"这一点上,它是负载画像的函数,不是架构师的审美。
问:为了省电全配小核行不行?
行不行看控制流负载的成色。操作系统的调度路径、协议栈的分支密集段,这类代码在顺序执行的小核上会拖出可感知的响应延迟——省下的电以系统"发闷"的形式偿还。实践中更稳的判断是把响应延迟指标(中断到首个处理指令的时间)设为硬约束反推大核档位,而不是先定核数再看性能剩多少。CK770 保留单颗大核,正是这个约束反推的结果。
问:加速器越配越多,小核会不会有一天被彻底取代?
看不到这个前景,因为两者吃的是不同性质的负载。加速器吃"规则计算"——运算模式固定、数据量大、控制流简单;而采集调度、协议处理、异常兜底这类活,控制流密集、分支不可枚举,天生属于通用核。历史上加速器每强一代,"编排加速器"的软件负担就重一分,对通用核的需求水涨船高而非消退。CK770 二代规划里加速器算力翻了三倍,小核配置不降反增,就是这个规律的一次小型重演。
本节要点回顾
- 多核的首要动机是能效而非峰值性能;大小核把性能按峰值配、功耗按占用配。
- 簇是核组织的中间层,也是一致性的作用域边界;分簇依据是软件的共享数据习惯。
- 一致性流量不搬业务数据但占带宽,靠作用域划分、侦听过滤与软件纪律三招压缩。
- 加速器要配齐直接访存、描述符、完成中断三件套,挂在离数据最近的位置。
计算单元配好了,下一个问题是它们吃的数据住在哪——这就是 2.2 节的存储层次结构。