6.1 布图规划与布局布线
6.1 布图规划与布局布线
网表带着第五章的全部验收信心进入物理实现,第一站是布图规划:给每个模块在硅片上划定地盘。随后布局布线把数十万个单元安进地盘、把百万根连线铺进金属层。本节讲清这两个环节的依据与判断标准,并以 CK770 的两轮布图迭代做实战演示。读完你应当能评审一张布图、看懂一份拥塞报告,并知道"物理实现质量"好在哪里、差在哪里。
给每个模块划地盘
布图规划是在一张空白的硅片上回答三个布局问题:模块放哪、宏块放哪、输入输出放哪。依据从来不是"看起来整齐",而是四条硬道理。
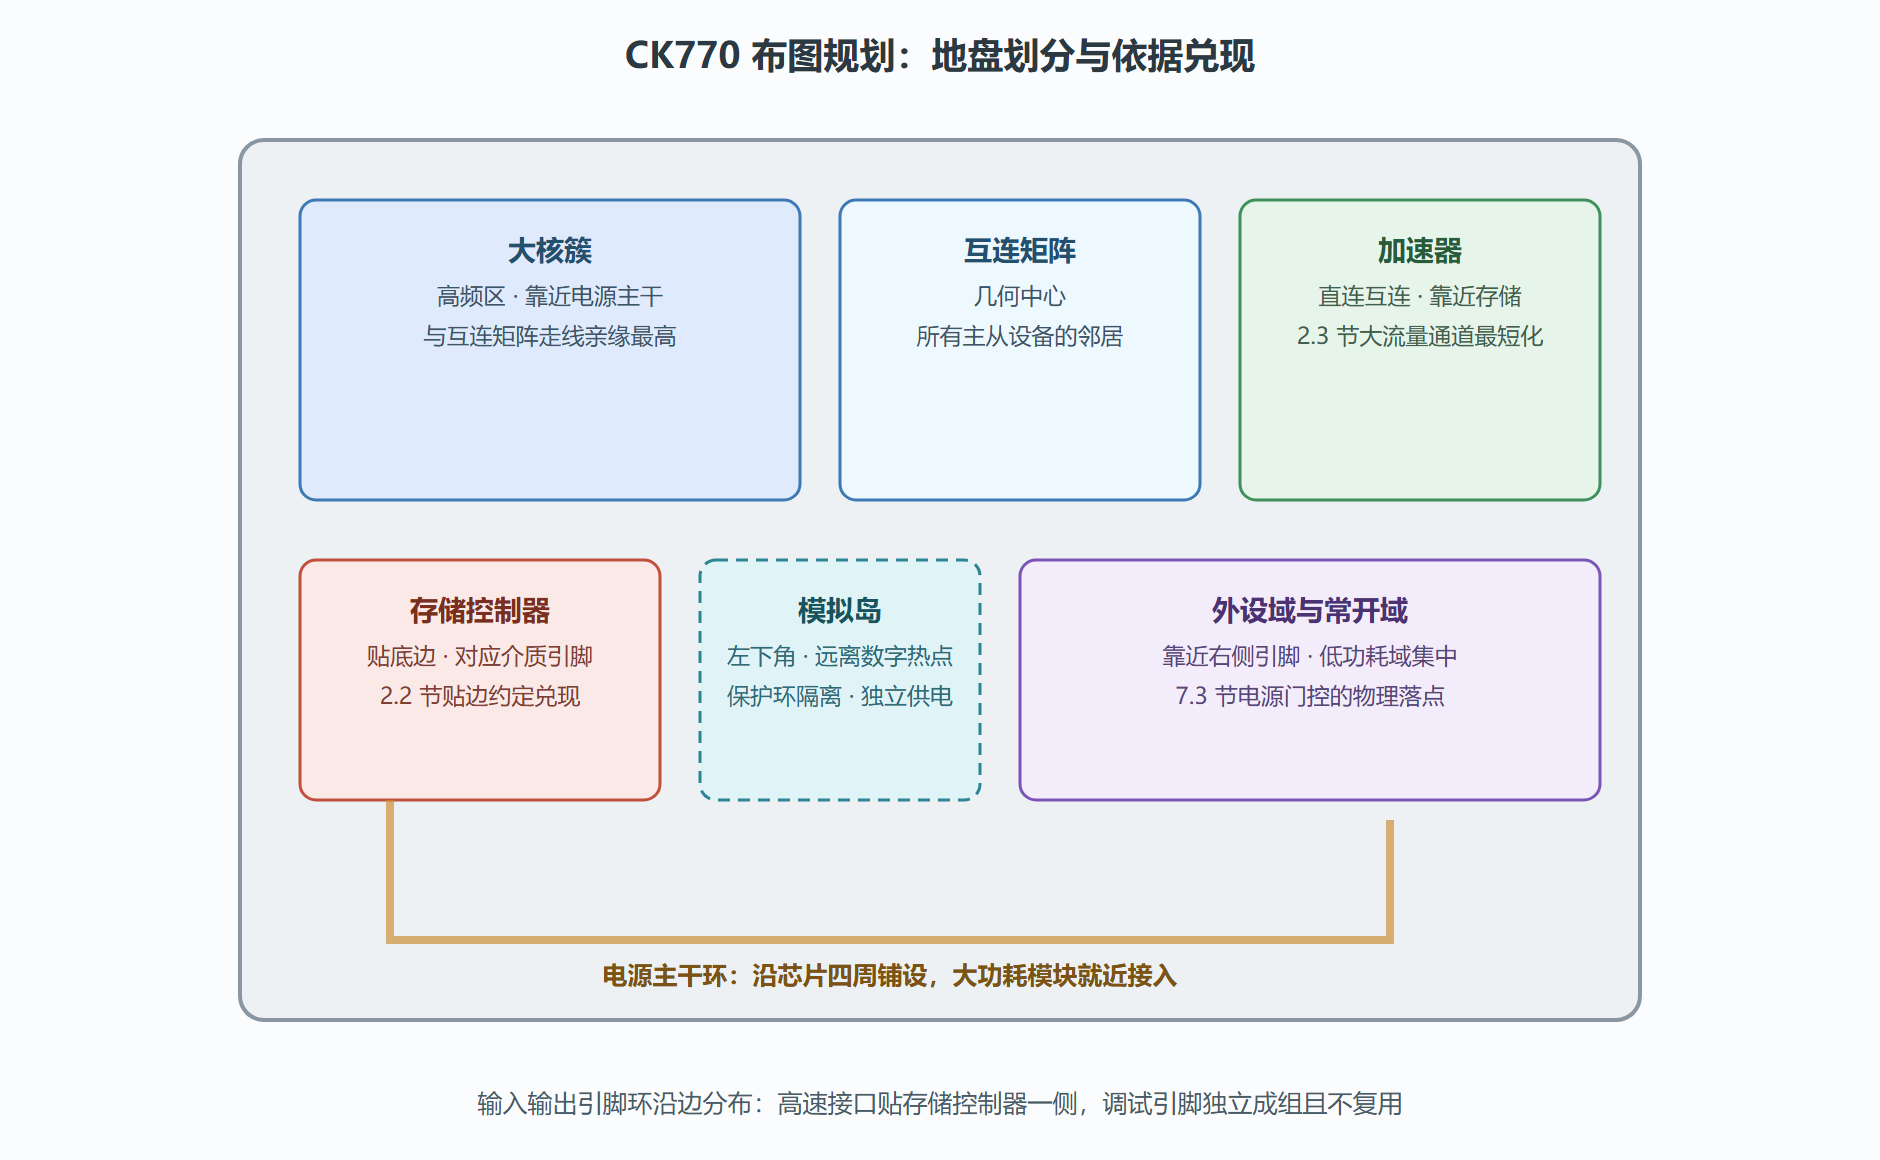
走线亲缘:数据流量大的模块要挨着放。2.3 节的互连拓扑在物理上兑现——大核簇、加速器、存储控制器围着互连矩阵摆,关键路径才能短。2.2 节那个"贴边放置存储控制器"的约定在这里兑现:它要靠近数据进出的引脚。电源结构:电源网络像城市供水,主干管先铺,大功耗模块靠近主干,7.1 节的电源树在布图上第一次落地。模拟隔离:3.1 节的模拟岛要远离数字热点,加保护环与隔离阱,噪声敏感的转换电路甚至要单独供电。引脚位置:外部接口的引脚位置由封装与电路板决定(3.2 节的走线规则要回查),接口电路必须相应贴边。
四条依据有时打架:走线亲缘想把存储控制器放中央,引脚约束要它贴边;模拟隔离要空出隔离带,面积预算又不允许。布图规划的价值就在于把这些矛盾在纸面上暴露并裁决——改布图是改几行坐标,流片后再发现模拟被数字淹没,就是一次性损失。
图:CK770 布图规划终版与四条依据的兑现
布局布线:自动化的艺术
地盘划好后,流程交给工具三步走,但每一步都要人盯着。布局:把网表里的标准单元填进各自地盘,工具按"连线最短、时序最优"摆放,人要做的是核对高功耗区的密度别超限、关键路径的单元别散落。时钟树综合:在布信号线之前,先把 3.1 节的时钟根到每个触发器的分发网络长出来——时钟线的延迟与偏斜直接决定时序基线,必须先行且单独验收。布线:在多层金属里为百万根连线找路,低层短线、高层长线,工具自动绕障;人盯的是拥塞——某片区域布线资源耗尽,工具被迫绕远路,时序就伤在这里。
拥塞的治理有层次:局部轻度拥塞,放宽该区单元密度(布局松一点)即可;中等拥塞,回到布图给该模块挪地盘或扩边界;全局性拥塞,说明架构分配的走线预算不足,要回头与 2.3 节的数据通路设计对账。治理的次序与 4.3 节收敛谈判同门——先便宜的、后结构性的。
时序检查(6.2 节)在每轮布线后运行,违例反馈给布局布线迭代修正。这个"布一版、查一轮"的循环就是物理实现的日常,循环圈数是物理质量的核心指标:圈数少,说明前端的时序余量给得足;圈数多,每多一轮都是工期与风险。
案例复盘:CK770 的两轮布图迭代
背景:首版布图评审会上,性能仿真给出的预估不乐观——加速器到存储控制器的平均走线长度超标,2.3 节那根大流量通道比预算长出三成;同时模拟岛报告了两个隐患:它与外设域的数字热点只隔一道墙,且与存储控制器共享了一段供电支路。
操作。 第一轮迭代动结构:把加速器地盘从右上角换到右侧中部,与存储控制器隔互连矩阵相望,大流量通道长度回落到预算内;模拟岛整体迁往左下角,保护区加宽,供电改为独立支路从电源主干直接引入——三个动作全部发生在布图层面,零网表改动。第二轮迭代治拥塞:布线后拥塞报告显示外设域寄存器密集区出现两处中度拥塞,处方是该区单元密度上限下调、相邻空地让渡,重布后拥塞清零。两轮迭代各用了三天,时钟树综合在第二轮布局后重长一次。
结果。 终版布图进入布线后,首轮时序分析(6.2 节)的违例路径数比预期少得多,建立余量为负的路径只有个位数,且全部集中在可局部修复的类别。物理团队的原话进了台账:"这是近几期项目里前端给得最体面的一次。"第五、六章之间顺畅的交接,被这两个团队分别归功于对方的文档。
解读。 案例的重心不在迭代本身,而在迭代为什么便宜:布图层面对象是模块与坐标,改动的验证成本近乎零;同样的矛盾若拖到布线后甚至签核期暴露,修复要动物理实现、约束乃至网表,代价按量级上升。四个布局依据(走线亲缘、电源、隔离、引脚)在 1.1 节的架构图里就画了雏形——布图评审其实是全册知识的一次总对账,前面每一章的物理承诺都在这张图上签到。
变式。 若芯片规模再大(互连矩阵从十字路口升级为片上网络),布图的自由度反而下降——网络节点的物理位置约束变硬,布图要跟着拓扑走;若产品是模拟混合信号重仓型(射频、高速转换占比高),模拟岛隔离的优先级压倒一切,数字模块要围着模拟区避让,与 CK770 这种数字为主型的取舍方向相反。布图没有模板,只有依据。
宏模块是布图里需要单独伺候的一类住客:存储编译器生成的缓存块、硬核处理器、3.2 节的串行接口物理层,它们位置由内部结构决定、不能随意旋转翻转,还自带电源与引脚的固定朝向。布图规划的一半功夫花在给这些"家具"找到彼此不冲突的安放位——宏块定下后,可自由摆放的标准单元区域才见分晓。评审布图时先看宏块:宏块的安放有没有逼得某条关键通道过窄、有没有把单元区切得七零八落,这两问比看任何统计数据都灵。
常见问题辨析
问:布图评审时,不搞物理的架构师应该盯什么?
盯三样不用懂布图就能判断的东西。一是关键数据通路在版图上的几何长度——把 2.3 节的大流量通道在图上描出来,问一句"为什么隔这么远";二是模拟与数字的隔离带是否按 3.1 节规格书的要求留足,这道题流片后无法补救;三是高功耗模块与 7.1 节电源主干的接入关系,压降问题在这里埋根。这三问都只需要架构知识加一张布图,却能拦下后端阶段最贵的那几类返工。
问:时钟树为什么必须先于信号布线完成,不能最后一起长吗?
因为时钟是全芯片的节拍基准,它的到达偏差(偏斜)直接改写每条路径的时序账本——先布信号再长时钟,等于先盖楼再定地平线。时钟树先行,后续所有时序计算才有稳定的基准;信号布线造成的延迟变化,通过增补缓冲微调即可吸收。把顺序反过来,时钟树的偏斜会被已有的信号布线挤来挤去,时序收敛变成来回拉锯,6.2 节的迭代圈数直接翻倍。
问:布图什么时候冻结最合适?冻早了怕信息不足,冻晚了怕白白返工。
冻结点是"关键承诺齐全"与"细节可后补"的交线,实操上认三条。一是模拟岛与宏块的位置必须冻结——它们受隔离与引脚的硬约束,且后挪的返工最大;二是关键数据通路的模块邻接关系必须冻结——这决定互连的物理可行性;三是面积分配只定边界不定内部——内部密度留给布局按拥塞微调。CK770 的做法是把冻结拆成两级:布图级(位置与邻接,架构评审会上冻结)与密度级(模块内部的松紧,布线首轮后允许微调)。两级分冻,既保住了"改动最贵的地方不变",又给物理团队留出了日常调度的余地。
本节要点回顾
- 布图规划的四条依据——走线亲缘、电源结构、模拟隔离、引脚约束——是前六章所有物理承诺的总对账。
- 布局布线三步走:布局、时钟树综合、布线;时钟树先行且单独验收,拥塞是布线质量的第一信号。
- 拥塞治理按代价升序:松密度、挪地盘、改架构,与综合收敛的谈判次序同门。
- "布一版查一轮"的迭代圈数是物理质量的标尺,圈数的多少由前端时序余量决定。
版图连好了,线上的信号到底快不快、稳不稳,要交给一位不讲情面的裁判——静态时序分析,下一节的主角。