3.3 剧本 Playbook 编写
3.3 剧本 Playbook 编写
本节摘要:解剖剧本的结构——play 的头部字段、任务的公共关键字、handlers 的配合、多 play 组织与 serial 滚动。目标是能独立写出一份结构清晰、可评审、可重跑的发布剧本,并为第 4 章的角色化重构打好语法底子。
先看一份完整的发布剧本
与其从零散语法点开始,不如先看一份"星尘在线"的真实发布剧本,后面的讨论都在它上面展开:
--- - name: 星尘在线 web 发布 hosts: web serial: 2 # 每批两台,滚动推进 become: true vars: app_version: "{{ app_ver | mandatory }}" pre_tasks: - name: 发布前健康检查 ansible.builtin.uri: url: "http://localhost:8080/healthz" status_code: 200 register: pre_health ignore_errors: true tasks: - name: 从负载均衡摘除本机 ansible.builtin.command: /usr/local/bin/lb-drain.sh delegate_to: "{{ lb_primary }}" notify: 恢复负载均衡 - name: 部署新版本代码包 ansible.builtin.unarchive: src: "releases/app-{{ app_version }}.tar.gz" dest: /opt/stardust owner: appuser mode: "0755" notify: 重启应用 - name: 渲染运行配置 ansible.builtin.template: src: app.conf.j2 dest: /opt/stardust/conf/app.conf notify: 重启应用 - name: 等待应用健康 ansible.builtin.wait_for: port: 8080 delay: 5 timeout: 60 post_tasks: - name: 回归验证首页 ansible.builtin.uri: url: "http://{{ inventory_hostname }}:8080/" status_code: 200 handlers: - name: 重启应用 ansible.builtin.systemd: name: stardust state: restarted - name: 恢复负载均衡 ansible.builtin.command: /usr/local/bin/lb-attach.sh delegate_to: "{{ lb_primary }}"
play 头部:这段戏的演出说明
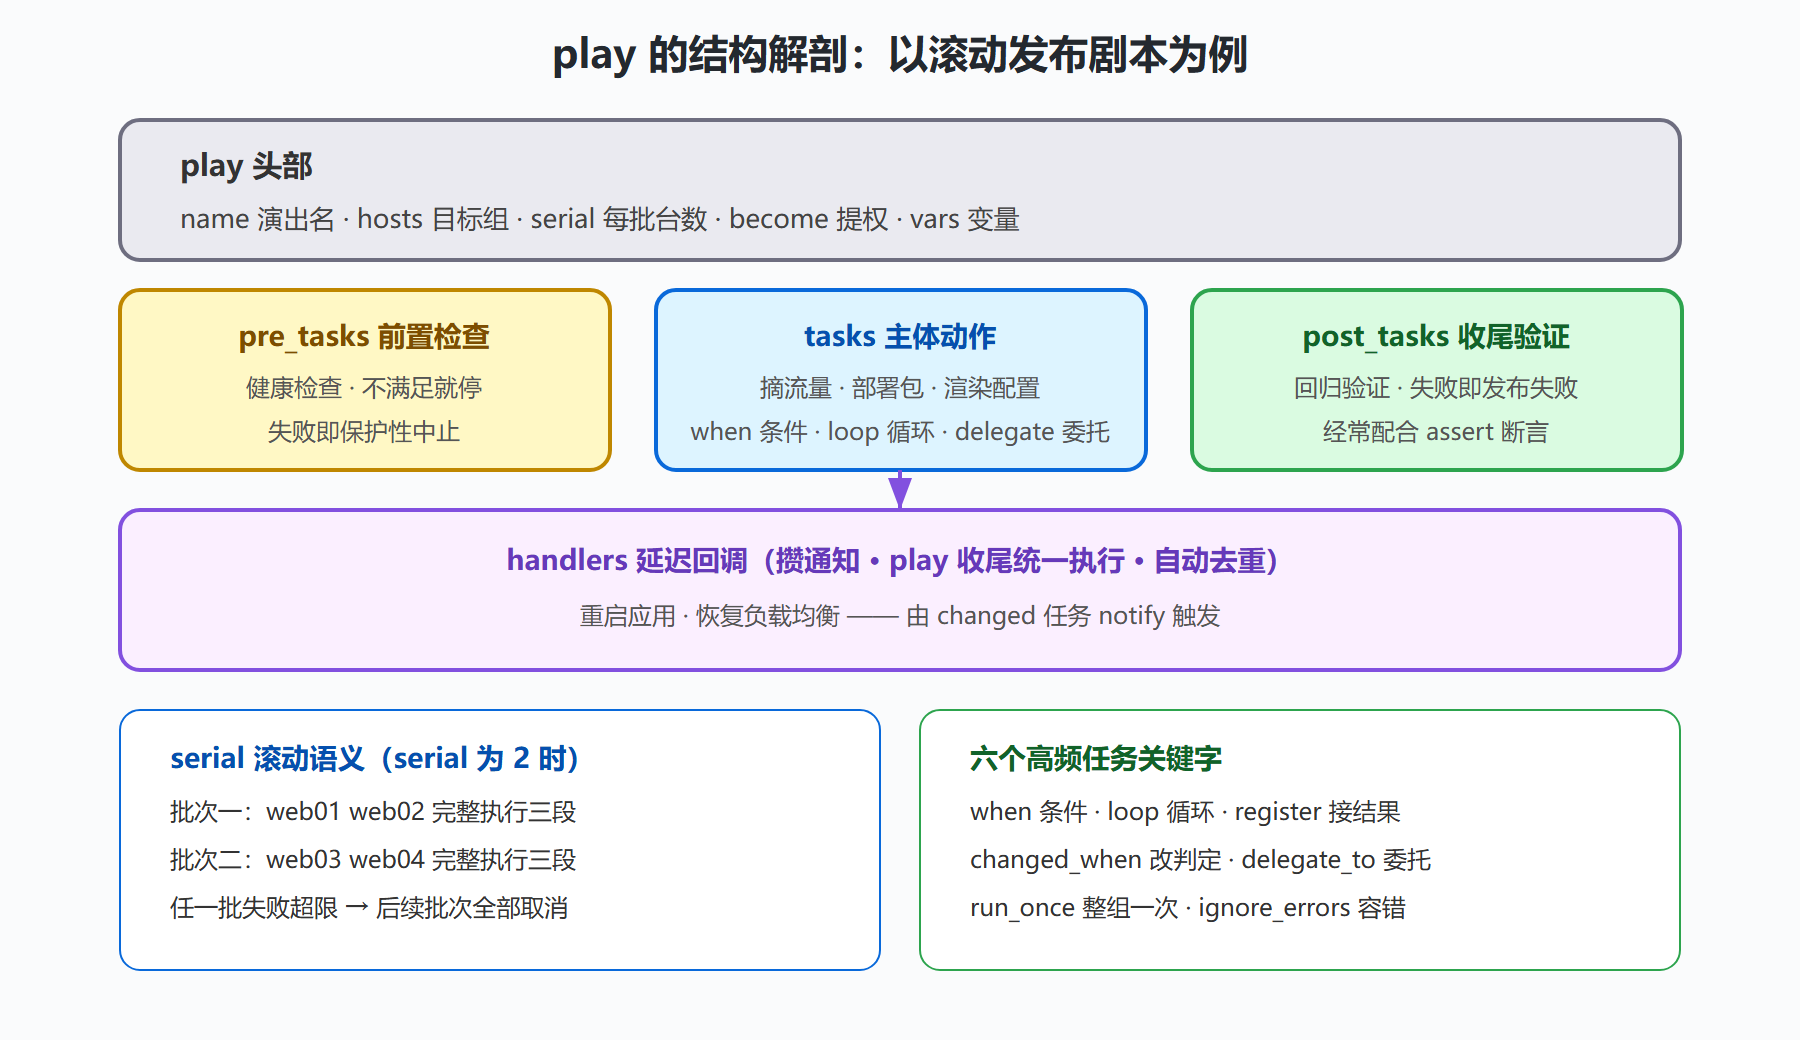
头部字段控制"对谁、以什么身份、按什么节奏演"。hosts 选定目标(可以是组、通配、冒号并集),become 决定是否提权,serial 切批次——这三者组合出滚动发布的骨架:serial: 2 时引擎对每批两台主机完整执行 tasks 与 post_tasks,本批全部成功才放行下一批,任何一批失败超限(默认全批失败即停)就终止后续批次。max_fail_percentage 可以放宽或收紧这个容忍度。
vars 段定义 play 级变量,上例里 app_version 用了 mandatory 过滤器:调用者必须用 -e app_ver=xxx 显式提供版本号,否则剧本直接拒绝运行。这是"发布剧本不接受默认版本号"的防御性写法——宁可报错也不能悄悄发布旧版本。
pre_tasks、tasks、post_tasks 三段在 handlers 触发时机的语义上完全一致,区别是执行顺序:前置检查先跑,收尾验证最后跑。把"不满足就停"的检查放进 pre_tasks 是通用模式——健康检查不过就别浪费后面的动作。
任务级关键字:每个动作的修饰符
任务名下面除了模块调用,还挂着一组公共关键字。高频的六个:
tasks: - name: 条件执行示例 ansible.builtin.debug: msg: "大内存机器才装全量监控探针" when: ansible_memtotal_mb | int > 8000 # 条件:为真才执行 - name: 循环示例 ansible.builtin.apt: name: "{{ item }}" state: present loop: # 循环:对列表逐项执行 - htop - jq - unzip - name: 失败容忍示例 ansible.builtin.command: /opt/bin/cache-warm.sh ignore_errors: true # 失败不中止(谨慎使用) register: warm changed_when: false # 声明:这个动作不算变更 - name: 本机执行示例 ansible.builtin.debug: msg: "在控制机上打印,不去目标机" delegate_to: localhost # 委托:任务在别处执行 run_once: true # 整组只执行一次
when 的表达式是 Jinja2 子集,注意它内部不需要再包一层双花括号——when 里写的是表达式本体。loop 用 item 引用当前项;配合 dict2items 过滤器可以循环字典。ignore_errors 的每一次使用都值得在评审时追问一句"失败了为什么不中止",十有八九的答案是"没想清楚",少数正当理由包括"探测类任务的失败本身就是有效信息"。delegate_to 与 run_once 的组合是编排类任务的标配:更新缓存、通知外部系统这类动作整组一次、且在指定位置执行。
handlers:延迟执行的回调
handlers 的完整语义第 2.2 节讲过,这里补写法层面的三条实践。第一,notify 的名字必须与 handler 名字逐字一致,多语言字符集下尤其容易踩(比如全角空格),lint 工具能查出。第二,一个任务可以 notify 多个 handler(列表形式),多个任务也可以 notify 同一个 handler,引擎自动去重。第三,flush_handlers 的使用场景:配置写完必须立即重启并验证,才继续后面的数据库迁移任务——这时把剧本拆成两段 play 或插入 flush,比把验证任务塞进 handler 更清晰。
剧本文件的物理组织
单文件剧本增长到数百行后,维护性断崖下跌。渐进的组织路线是:先把通用任务抽进任务文件用 import_tasks/include_tasks 拆分;再把"配置一类服务"的完整单元(任务加模板加默认变量加 handler)包装成角色(第 4 章);最后顶层只剩入口剧本——一个 play 列表,每个 play 一行 hosts 加一行 roles。入口剧本长什么样,可以先睹为快:
--- - import_playbook: site-web.yml - import_playbook: site-db.yml - import_playbook: site-cache.yml
import 与 include 的一字之差有个重要区别:import 在解析期静态展开,循环与条件作用于展开后的每个任务;include 在执行期动态加载,条件作用于加载本身。拿不准时先用 import,它的行为更接近直觉。
图 3-3:一份发布剧本的结构解剖
写法自查清单
剧本写完先过五问:版本号这类关键参数是否 mandatory 防呆?检查动作是否在 pre_tasks 且失败即停?服务重启是否全部走 handler 而不是内联 restart?每处 ignore_errors 是否有书面理由?serial 批次的失败容忍是否符合业务预期?五问全过,这份剧本拿去评审时经得起追问。下一节进入变量引擎——把 vars 段背后的完整优先级阶梯和模板语法一次讲透。