3.4 模板与变量引擎
3.4 模板与变量引擎
本节摘要:变量系统的两半:变量从哪来(十几个来源构成的优先级阶梯)与变量怎么用(Jinja2 模板表达式、过滤器、事实变量)。本节给出一张可背的精简优先级表、一套过滤器的实战用法,以及"变量不生效"类问题的系统排查法。
变量的来源地图
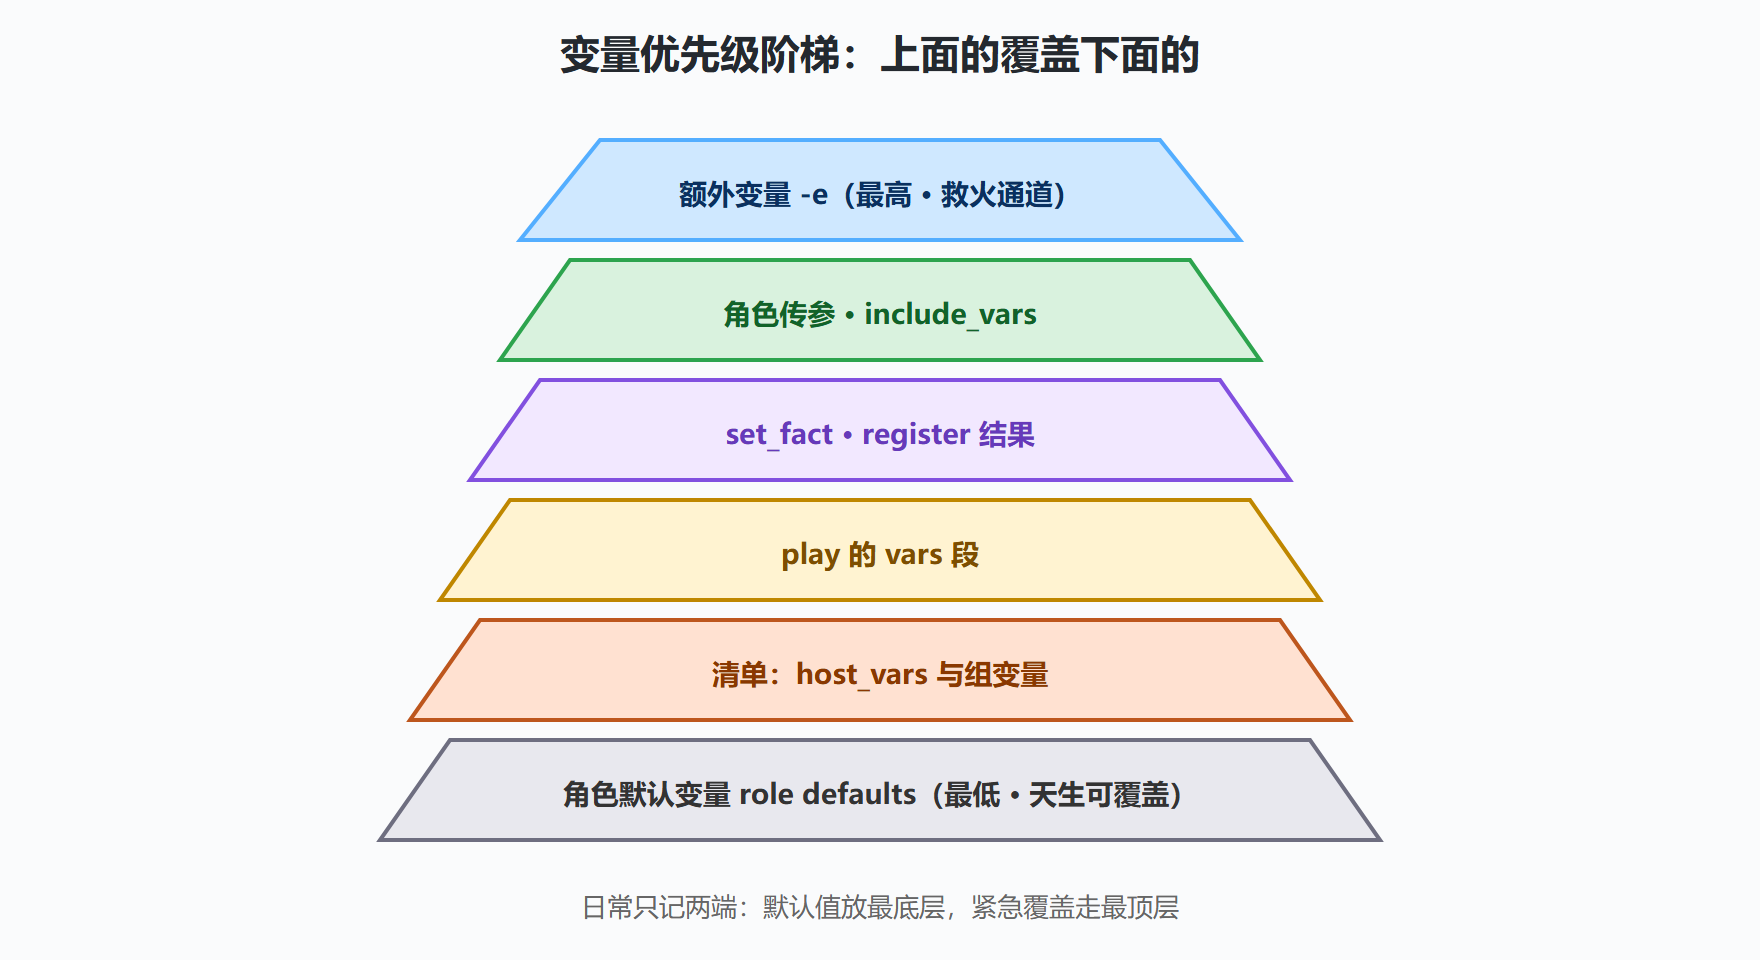
同一台主机的同一个参数,可能同时出现在剧本 vars、组变量文件、主机变量、事实变量里——引擎按固定优先级决定最终值。完整排序有二十多项,日常真正需要记住的精简版如下,按从低到高排列:
1. 角色默认变量 role defaults —— 最低,专门给"可被覆盖"的默认值用 2. 清单组变量 group_vars/all 与各组 3. 清单主机变量 host_vars 与主机行内联 4. play 的 vars 段 5. set_fact 与 register 的结果 6. 角色参数(role 传参)与 include_vars 加载 7. 额外变量 -e / --extra-vars —— 最高,压倒一切
两条使用心法。心法一,默认值放最低层:角色的 defaults 目录里写"合理但可覆盖"的值,上层环境按需覆盖,这是角色可复用的前提(第 4 章展开)。心法二,额外变量是运维人员的"紧急 override 通道":线上救火时用 -e 临时改行为而不动仓库文件,但它同时是双刃剑——绕过了代码评审,用完必须把修正落回仓库,否则下一次常规执行就把临时值冲掉。
模板引擎:Jinja2 的运维用法
template 模块把 Jinja2 模板渲染成目标文件。语法核心只有两种结构加一个概念:双花括号输出变量,块标签做逻辑控制,过滤器管道改写值。
# templates/app.conf.j2 —— 星尘在线应用配置模板 server { listen {{ http_port }}; worker_processes {{ ansible_processor_vcpus | default(2) }}; {% if env_name == 'prod' %} access_log /var/log/stardust/access.log main; {% else %} access_log off; {% endif %} upstream backend { {% for host in groups['app'] %} server {{ hostvars[host].ansible_host }}:{{ hostvars[host].app_port | default(8081) }}; {% endfor %} } }
这个模板集中了三个高频招式。default 过滤器:变量缺失时给兜底值,是模板防御性写作的第一反应——第 7.3 节的故障实录会展示不给 default 的下场。groups 与 hostvars 的组合:跨主机引用,upstream 生成、主机名单渲染都靠它;groups['app'] 是 app 组全部成员的列表,hostvars[host] 是那台主机的完整变量视图。if 与 for 的缩进控制:Jinja2 块标签本身不占行(右侧 trim 约定开启时),生成的配置文件是否整洁取决于模板写法,渲染后务必 cat 一眼成品。
过滤器:最值得投入的语法点
过滤器是模板表现力的杠杆,把十几条数据加工逻辑浓缩成管道。按使用频率排出的第一梯队:
vars: # 默认值与类型防线 workers: "{{ vcpus | default(4) }}" # 列表与集合运算 targets: "{{ (web_hosts + backup_hosts) | unique | sort }}" # 字典转列表(配合循环遍历字典) users_list: "{{ users_cfg | dict2items }}" # 条件选择 eff_timeout: "{{ (env_name == 'prod') | ternary(30, 300) }}" # 路径与哈希 token: "{{ cluster_name | hash('sha1') }}"
ternary 值得单独点名:三目运算的过滤器形式,比 if-else 块轻量得多,适合"两个值选一个"的行内决策。字典型数据(如今清单与角色参数大量使用 YAML 字典)配合 dict2items 才能进 loop。过滤器的官方列表有上百条,实际高频的就这十几条——遇到数据加工需求,先想"有没有现成过滤器",再想写判断块。
事实变量:从目标机来的一手数据
setup 模块收集的事实(Facts)是变量体系里特殊的一类:它们不来自任何文件,而来自目标机实况——操作系统、内核、CPU、内存、网卡、磁盘、环境变量。剧本里引用 ansible_processor_vcpus、ansible_default_ipv4.address 这类名字,就是在消费事实。三个实用要点:一是 facter 与 ohai 等外部事实源可插拔;二是 gather_facts: false 可以跳过收集(对纯模板渲染外的轻任务提速明显);三是自定义事实——在目标机放一个可执行脚本输出 JSON,它就会并入事实体系,适合上报业务自定义的机器属性。
图 3-4:变量优先级阶梯
"变量不生效"的系统排查法
按产生频率排序的四个病因与对应检查动作。病因一,优先级误判:你以为在写覆盖,实际写的层级更低。检查:ansible-inventory --host 主机名,看引擎最终合成的变量视图里这个参数是什么值、出自哪个清单文件。病因二,渲染时机:set_fact 的新值在同 play 后续模板里看不到(第 2.2 节机制)。检查:把引用挪到下一个 play,看是否恢复。病因三,作用域误解:facts 与 hostvars 属于"每主机"命名空间,在 delegate_to 的任务里引用的是目标机还是委托机的变量,容易搞反。检查:明确写 hostvars['机器名'] 而不是裸变量名。病因四,拼写与类型:布尔 true 写成字符串 "False"、数字与字符串比较失败。检查:用 debug 的 var: 输出加 type_debug 过滤器看实际类型。
模板的可维护性写法
模板文件会活很久,几条可维护性写法值得从一开始就守。写法一,头部注释声明用途与消费方:这个模板渲染给谁读、被哪个任务引用、修改后需要 notify 什么——三个信息写进文件头,接手的人少走一半弯路。写法二,变量默认值集中在模板头部或配套 defaults:模板中段出现裸变量是最常见的缺失来源(7.3 节实录的变量事故正是一例),头部集中后用一次 grep 就能核对完备性。写法三,复杂逻辑不进模板:当模板里的 if-else 超过两层或出现跨行运算,把计算移到剧本的 set_fact 或自定义过滤器里,模板只做"取值与排版"——模板是排版层不是逻辑层,逻辑藏进模板等于把代码藏进文档。写法四,渲染结果进评审:变更模板的提交必须附渲染后的成品对比(diff 模式的输出),评审人不需要脑内执行 Jinja2。四条写法的共同方向是把模板从"能跑的咒语"变成"可读的工件",模板的可读性直接决定配置排障的效率。