3.1 整体架构设计
3.1 整体架构设计
本节摘要:Airflow 生产形态至少拆成四块:Web 服务给人点选和 API,调度器做解析与状态推进,执行器及 Worker 跑任务代码,元数据库保存 DAG、运行、实例、连接与 XCom。日志通常另存。理解这张图,是为了在故障时把锅分对:界面 502 不一定等于任务没在跑。锅分对了,才不会拿错刀。
本节导航
阅读完本节,你应当能够:
- 说明调度器崩溃时,已经 running 的任务可能仍在 Worker 上
- 解释元数据库为何是单点中的单点,SQLite 为何不能生产
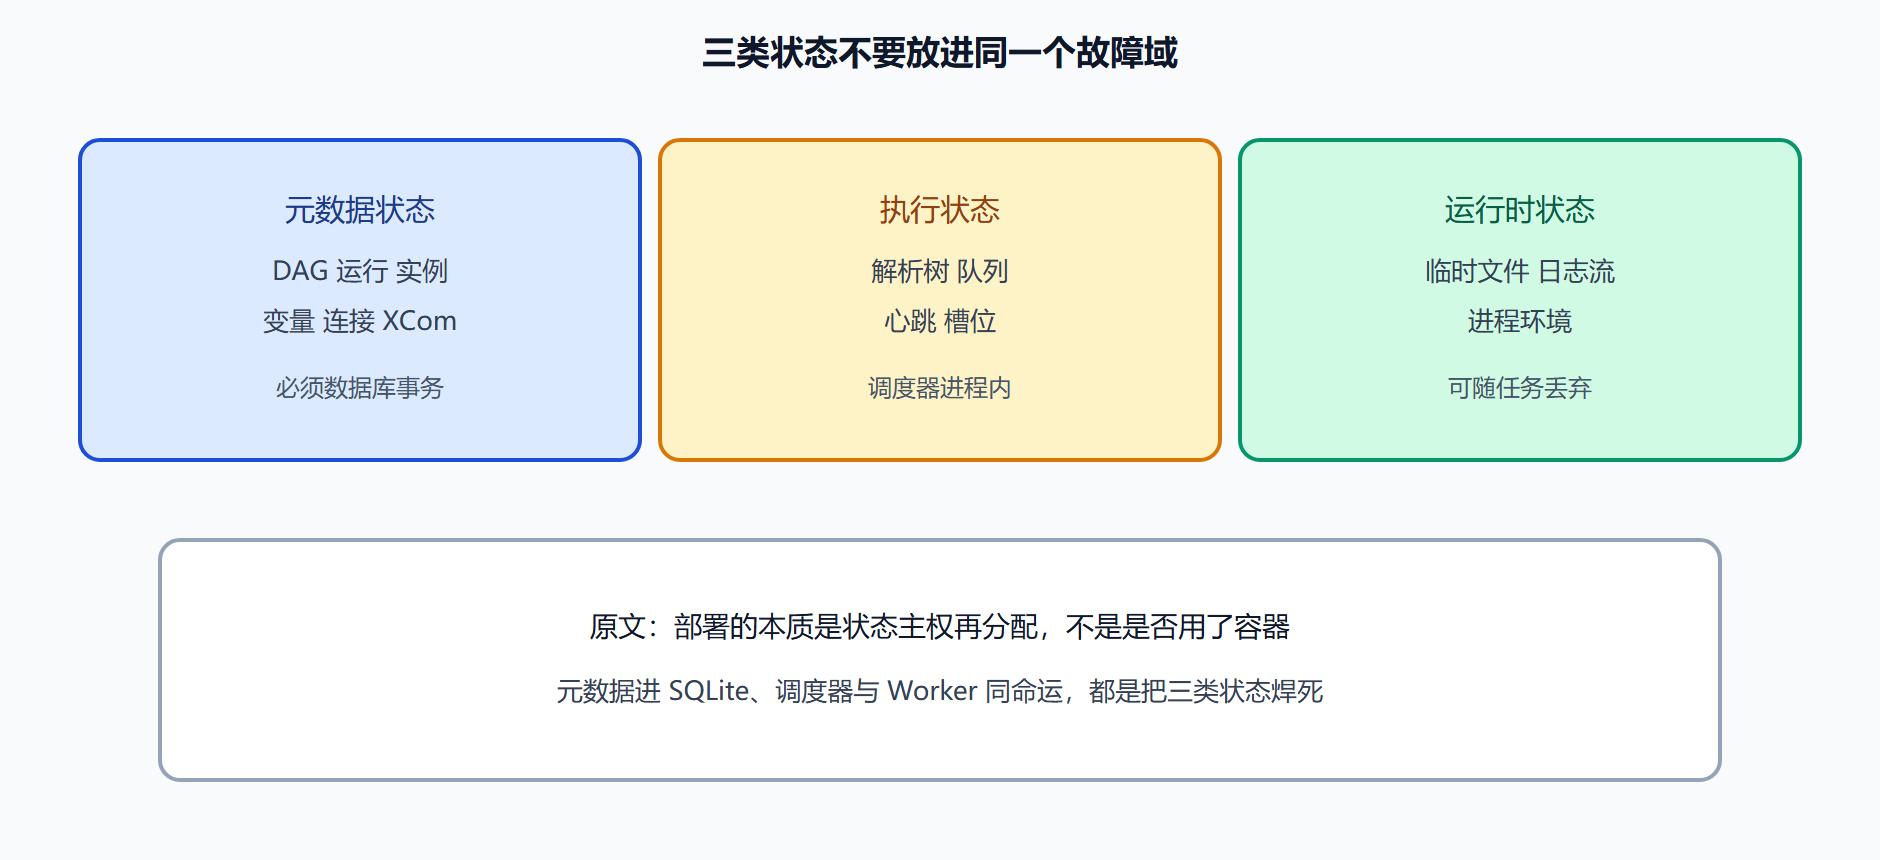
- 区分元数据状态、调度器内存中的执行状态、Worker 上的运行时垃圾
- 指出日志与 XCom 放错地方时会出现什么症状
一、四块积木,不要焊成一块
开发时 airflow standalone 把所有角色塞进一台机器,这是为了让第 1 章的最小 DAG 能亮。生产若仍焊在一起,Web 的流量尖峰会和调度循环抢进程,Worker 把内存打满会连界面一起带走。拆开之后,责任才分得清。
Web:Flask-AppBuilder 之上的 UI 与 REST。它读元数据库渲染图,能触发运行、暂停 DAG、查看日志。它不执行 python_callable。有人把 Web 副本扩到很多,以为能加快任务,那是把售票窗口当成车间。
调度器:解析 DAG、计算该建哪些 DagRun、检查依赖、把实例标 queued。高可用模式下可以有多个调度器做故障转移,但不要指望它像无状态 API 那样线性加机器就线性加快——它对元数据库的锁和查询更敏感。
执行器:调度器进程内的策略对象,真正干活的是它后面的 Local 子进程、Celery Worker 或 K8s Pod。原文强调:分布式不来自 Web,而来自执行器这一侧。
元数据库:PostgreSQL 或 MySQL。SQLite 没有足够的并发与锁语义,官方定位开发。连接池被 catchup 打满时,最先倒的是这层,所有角色一起饿死。
[ Web ] [ Scheduler+Executor ] \ / [ Metadata DB ] | [ Worker / Pod ] | [ Log store ]
图 组件与三类状态
二、账本、日志、消息通道
元数据库承担最终一致的状态。界面延迟数秒,常常是执行器 sync 尚未把 Worker 完成写回。这是设计,不是一定故障。真正的故障是长时间 running 但进程已死:心跳或同步环断了,需要执行器与僵尸回收策略。
日志默认曾落在执行机器本地,Web 靠读取那台机器。多 Worker 时必须把日志送到共享存储或远程收集,否则界面“日志找不到”而任务其实成功了。XCom 默认也在库里,体积大会直接伤害调度查询。对象存储后端是规模上来之后的选项。
Celery 执行器还依赖 Broker:RabbitMQ 或 Redis。它不是元数据库,丢了队列里尚未被领取的消息,任务会停在 queued。K8s 执行器用 API Server 当控制面,Pod 丢失要靠执行器把实例标失败或重试,而不是以为 Kubernetes 会替你改 Airflow 状态。
DAG 文件本身要出现在调度器和需要解析的进程都能读到的地方。Worker 是否需要完整 DAG 代码,取决于执行器:Local 需要,Celery Worker 通常需要能 import 到 callable,K8s 可能把代码打进镜像。架构图上常漏这一笔,导致“调度器看见 DAG、Worker 报找不到函数”。
| 组件 | 挂了会怎样 | 谁先打电话 |
|---|---|---|
| Web | 不能点选,任务可继续 | Web 负责人 |
| 调度器 | 不建新窗 | 平台值班 |
| Worker | 运行中失败或悬挂 | 执行器侧 |
| 元数据库 | 全体停 | 库负责人 |
| 日志存储 | 成功也可能看不见日志 | 平台值班 |
三、故障怎么切分
Web 挂了:不能点界面,API 停,已有任务可继续,调度器仍可写库。调度器挂了:不再产生新 Run、不再把新任务入队,已经 running 的 Worker 可能跑完但状态回写取决于执行器心跳。Worker 挂了:running 任务失败或卡死,调度器还在产生新的 queued,池会迅速堆起来。数据库挂了:全体停摆。备份与主从是第 4 章的事,架构上先承认它是心脏。
⚠️ 常见坑:把 Scheduler 和 Worker 塞进同一进程组,用同一套自动扩缩。任务峰值会先饿死调度循环,于是峰值期间连新窗口都不建。
💡 关键直觉:问“谁可以不在线而任务仍可能跑完?”答案是 Web。问“谁不在线则世界停止?”答案是元数据库。
Triggerer 进程在可延迟算子出现后成为独立角色:负责唤醒延迟中的等待。架构上它靠近调度器,但不要和 Worker 混为一谈。没有 Triggerer,可延迟传感器会无法按时恢复。
组件之间只用数据库和消息协议说话,不要让 DAG 代码去 SSH 兄弟节点。那会把架构图上的隔离全部作废。
四、把一次请求的路径走完
假设用户在 UI 点了 Trigger。Web 写一条 DagRun 请求进元数据库,并不自己执行函数。调度器下一轮看到这条 Run,检查任务依赖,把根任务标 queued。执行器 execute_async 把它交给本机进程、Celery 消息或 K8s Job。Worker 跑 callable,写日志到约定存储,sync 把 success 写回库。Web 刷新后变绿。这条路径上任何一环单独出问题,症状不同:Web 502 时路径后半仍可能完成;Worker 死了会出现 running 悬挂;库锁了则谁都走不动。排障按路径提问,不要按“Airflow 挂了”提问。
Triggerer 在可延迟任务上插入额外一跳:Worker 把等待交出去,Triggerer 盯外部事件,到期再把任务唤醒。架构图漏画 Triggerer,会把“传感器不醒”当成 Worker 不足。日志存储漏画,会把“没日志”当成任务没跑。DAG 代码分发漏画,会把“找不到 callable”当成调度器 bug。三张漏图是生产里最常见的架构文档缺陷。
原文三类状态再落到备份:元数据进数据库备份策略;执行状态可以丢,调度器重启后从库重建视图;运行时临时文件本就该可丢,唯一要留下的是日志。把临时文件放在与日志同一块盘且不轮转,会让“可丢”的东西把“该留”的东西挤掉。
SQLite 只开发,再强调一次理由:写并发、锁粒度、网络访问都不适合多进程 Scheduler + Worker + Web。能跑通最小 DAG 不构成生产证据。迁移到 PostgreSQL 要在有真实并发之前完成,而不是在第一次锁等待报警之后。
问题:Web 可以和 Scheduler 共用一个进程吗?
开发可以。生产不要。Web 的用户流量和渲染大 DAG 的 CPU,会直接打断调度循环。拆开之后还可以单独扩 Web 应付“大家一起打开界面看大促”,而不让建 Run 停摆。共命运是 standalone 的教学便利,不是架构目标。
问题:元数据库跨过一台机器是不是就算分布式 Airflow?
不算。分布式主要来自执行器这一侧能把任务放到多机。库分开只是把账本放对地方。只有一台 LocalExecutor 机器,库再强也是单机执行。架构评审要分开问“账本”和“搬箱子”,不要用“我们用了 PostgreSQL”代替“我们能水平加 Worker”。
五、给新人的十分钟走图
站在白板前只画五框:人点的 Web、做决定的 Scheduler、搬箱子的 Worker、记账的库、存日志的盘。箭头只有读写库、入队、写日志、Web 读日志。十分钟内能讲完,架构才算落地。讲不完是因为框里塞了业务系统。业务系统画在 Worker 之外,经 Connection 出去。新人最容易把数仓画进 Airflow 框里,于是数仓慢也被说成 Airflow 架构问题。走图结束问两个问题:谁可以不在线而任务仍可能跑完?谁不在线则世界停止?答案分别是 Web 与元数据库。答错则十分钟重来。Triggerer 作为第六框,等用到可延迟再贴上,避免第一天信息过载。
六、日志与 XCom 的物理位置写进架构决策
架构评审必须出现两行:日志存在哪,Web 如何读;XCom 存在哪,体积上限多少。缺这两行,组件图只是娱乐。多机后本地日志等于没有日志。库内 XCom 等于把货车开进档案室。对象存储后端可以晚一点上,但上限必须现在有。超过上限谁拒绝:任务失败还是平台告警。拒绝策略写不清,就会在某次大促把库盘写满,UI 与调度一起死,看起来像“全面宕机”,根因是一张过大的纸条。决策记录比画框重要。画框可以漂亮,决策记录能在半年后阻止同样的 PR。DAG 代码分发是第三行:解析侧与执行侧的版本如何对齐。三行齐,3.1 才算完成。不齐就进入 3.2 选执行器,等于在未知代码版本上比较延迟,数字没有意义。
七、停机影响表(可贴值班室)
停 Web:不能点、不能看,任务可继续。停 Scheduler:不建新窗、不推进新 queued,running 看执行器。停 Worker:running 失败或悬挂,queued 堆积。停库:全体停。停日志存储:任务可成功,排障失明。停 Broker:Celery 入队失败。停 API Server:K8s 执行器无法起 Pod。把表背熟,电话里就不会先重启库去治界面 502。
八、十分钟走图后的电话演练
一人扮演界面 502,另一人只能问停机影响表。正确第一通电话是 Web 负责人,不是 DBA。演练反了,重来。再演 Worker 悬挂:应问执行器与可见性超时,不是改 SQL。再演全体卡死:才是库。三次演练过,3.1 的表才进入肌肉。肌肉比印出来的纸更重要,纸会丢。丢了还能背,才算毕业。毕业前不要进 3.2 选品牌。品牌救不了打错电话。打错电话浪费闭合中的窗口。窗口不等人。人不背表就会等错人。等错人来自没演练。演练十分钟。十分钟换一次少打错的夜班。夜班贵。十分钟便宜。便宜的演练放在本节末。末了做三次。三次结束 3.1。3.1 结束积木。积木结束于会打电话。打电话结束架构空谈。空谈结束于表。表结束于演练。演练结束。
九、日志读不到时先别判任务失败
UI 打不开日志,先问共享存储或采集是否活着,再问这次 try 是否其实 success。成功而失明,是观察故障,不是业务故障。两者混为一谈会让人重跑已成功窗口,幂等若没做好就会双写。双写比失明贵。贵的操作后置。后置需要 3.1 把日志当成独立积木。积木挂了,任务仍可能跑完。跑完要在库里看状态,不要只看日志页。日志页只是眼睛。眼睛瞎了,手不要乱点触发。乱点会制造第二窗。第二窗会叠写。叠写结束于先查积木。查积木结束误判。误判结束重跑。重跑结束双写。双写结束。观察故障单独派平台,业务失败才派 owner。分派结束混谈。混谈结束。本节补上这只眼睛。眼睛结束 3.1 最后一格。格结束。状态在库里,不在屏幕上。屏幕只是库的投影。投影丢了,库还在。库还在就先读库。读库结束盲点触发。
一节小结
- Web 不执行业务函数;调度器不搬箱子;Worker 不改乐谱
- 元数据库是共享账本,SQLite 仅开发
- 三类状态分开放:库、调度器内存、Worker 临时文件
- 日志必须可被 Web 读到,多机就要远程日志
- 故障切分先问哪一类状态还活着
- DAG 代码分发是架构的一部分,不是部署附录
下一节把“搬箱子的人”展开成执行器光谱。