3.2 Executor选型
3.2 Executor 选型
本节摘要:Executor 实现入队、同步状态、心跳宣告槽位这组协议,把 queued 的 TaskInstance 变成操作系统进程或容器。Sequential 用于开发确定性,Local 用于单机并行,Celery 用于多机队列,Kubernetes 用于一任务一 Pod。选型问隔离边界、谁保证资源、故障后如何回到状态机,而不是问谁更时髦。
读前必看
阅读完本节,你应当能够:
- 用 BaseExecutor 的 execute_async 与 sync 解释界面状态为何滞后
- 对比四种常用执行器的隔离与故障域
- 设计一个“先 Local 对照延迟再上 K8s”的排障步骤
- 说明心跳槽位如何反过来限制调度吞吐
一、协议比品牌重要
原文把 Executor 写成抽象基类上的宪法:execute_async 把实例丢进后端队列,应尽量轻;sync 反向探测后端,把完成/失败写回库;heartbeat 向调度器宣告还剩多少槽。调度器按槽位决定还能放行多少任务。执行器不健康时,不是“跑得慢”,而是整座工厂的瞬时上限被自己报低。
这解释了背压:Celery 队列堆积、K8s 起不了 Pod,sync 与心跳会让调度侧少放行。你若只在 DAG 里把并发调高,而 Worker 已满,只会让 queued 更长。调 DAG 之前先看执行器槽位与池。
二、光谱:从单线程到一任务一容器
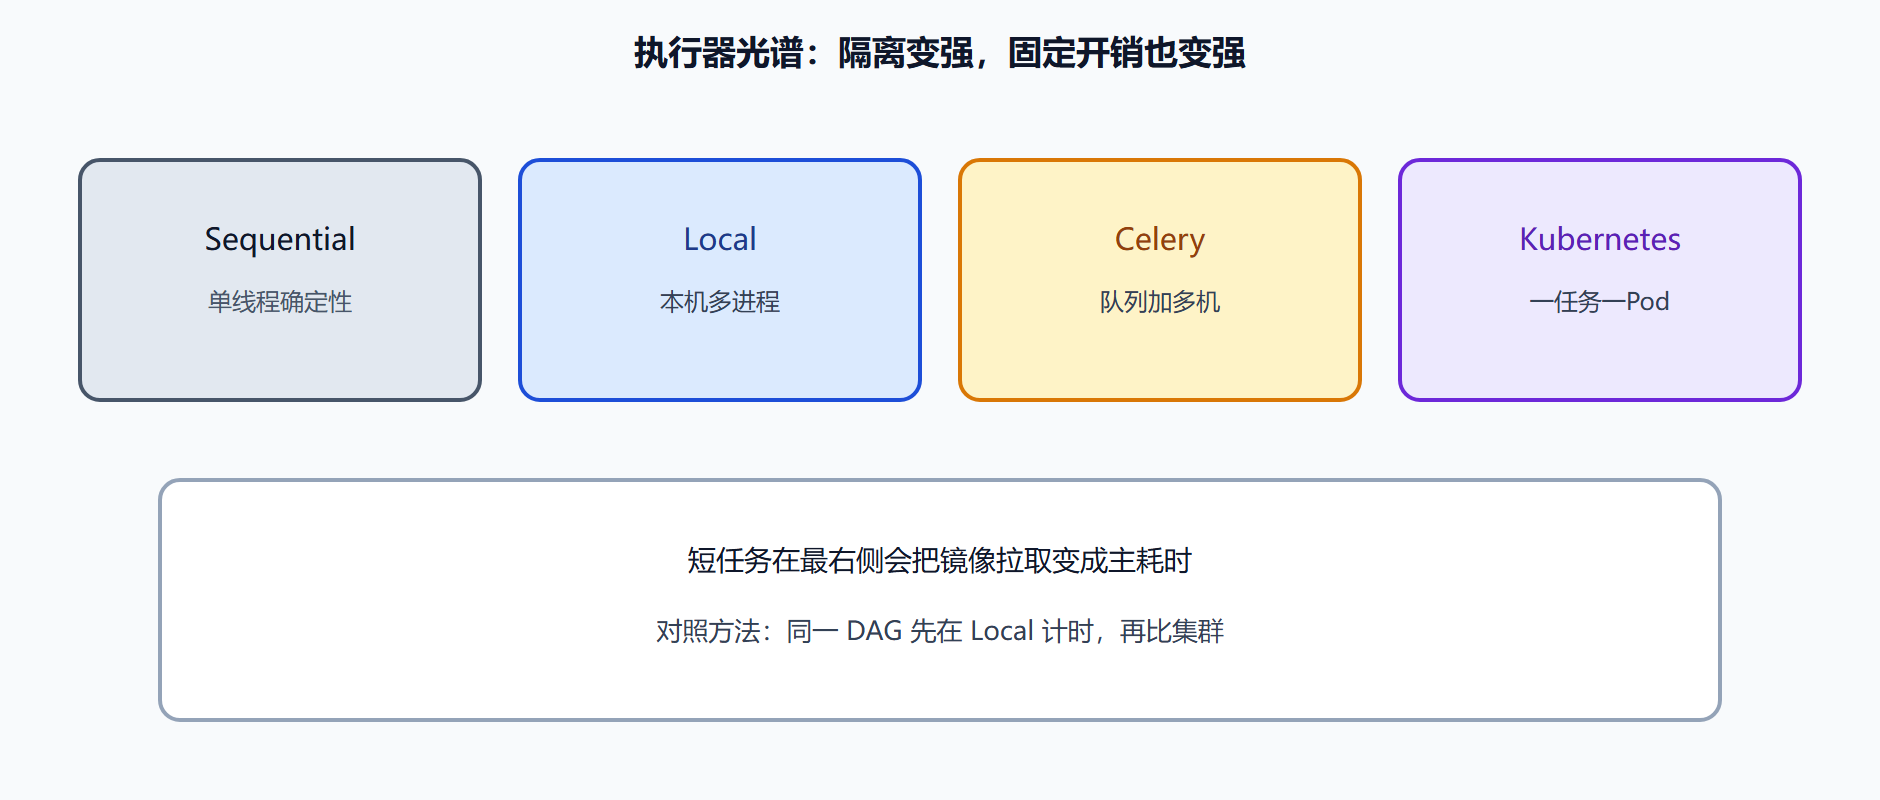
SequentialExecutor:单线程,官方用于开发。同一时刻一个任务。好处是日志顺序好懂,坏处是传感器会堵住后面所有人。
LocalExecutor:本机多进程。无外部中间件,调试时 PID 对得上界面。天花板是这台机器的 CPU 与内存;主进程崩溃,正在跑的任务一起丢上下文。GIL 对纯 Python 计算不友好,重计算应丢给外部引擎。它是对照黄金标准:同一 DAG 在 Local 200 毫秒、在 K8s 8 秒,锅在镜像拉取或集群调度。
CeleryExecutor:任务进 Broker,Worker 群消费。可水平加机器、按 queue 把 GPU 与普通任务分开。要运维 Broker 的持久化与脑裂,Worker 包版本必须一致。幽灵任务发生在 Worker 死了但状态仍 running:需要可见性超时与正确的 acking。
KubernetesExecutor:每个任务一个 Pod,隔离最好,镜像可按任务覆盖。代价是每个任务付一次调度与拉镜像的税。短任务(几秒)会把税占比拉得很难看。executor_config 传入资源请求,OOM 必须映射回 up_for_retry 而不是悬空。
Dask 等执行器在部分版本与生态中出现,适合已经有 Dask 集群的团队。不要为了清单完整强上。生产主流仍是 Celery 与 Kubernetes 两条。
| 执行器 | 隔离 | 扩展 | 我何时选 |
|---|---|---|---|
| Sequential | 无 | 无 | 单测与教学 |
| Local | 进程 | 单机 | 小团队、对照延迟 |
| Celery | 进程+机器 | Worker 水平扩展 | 稳定队列、任务时长中等 |
| Kubernetes | 容器 | 按任务扩 | 依赖差异大、要强隔离 |
| 托管运行时 | 取决于厂商 | 厂商负责调度扩缩 | 不想养 Broker 与补丁 |
图 故障域从进程扩到集群
三、怎么拍板、怎么排障
拍板三问。任务要多强隔离?依赖库冲突严重就偏 K8s。平均时长多少?小于半分钟且量大,Celery 常更划算。团队会不会运 Broker?不会就托管或 Local 撑着,不要既不会 Redis 又要自建 Celery。
排障 queued:池满、槽位满、队列没 Worker 订阅、DAG 被暂停。排障 running 过久:真的在算、还是进程已死。Local 上看进程表;Celery 看 Worker 在线;K8s 看 Pod 事件。排障成功但界面未刷新:等 sync,查数据库连接。
⚠️ 常见坑:KubernetesExecutor 下每个短 Python 任务都拉一次大镜像。把小任务合并,或用常驻 Worker 的 Celery,比继续调调度器间隔有用。
💡 关键直觉:Executor 是协议转换器。它不理解你的业务 DAG,只履行入队与回传。业务并发要靠池和 max_active_runs 一起限制。
混合并非禁区:核心用 Celery,少数脏任务用 Kubernetes 执行器或专门队列。复杂度在于两套日志与两套失败模式。先把一条执行器跑稳,再拆。
心跳丢失应视为槽位下降。大规模部署要监控执行器心跳年龄,而不是只盯任务失败率。失败率低但吞吐掉下去,经常是心跳或数据库锁,不是 DAG 写错。
四、对照实验怎么做才算数
同一 DAG、同一窗口、同一份数据,只换执行器。记三个数:入队到 running 的等待、running 到 success 的时长、失败重试一次额外多少。Local 作为基线。Celery 若入队等待明显变长,查 Broker 与 Worker 在线、队列名是否写对。K8s 若入队到 running 固定多几秒到几十秒,基本是镜像与 Pod 调度税,不要去优化 Python 里的两行字符串拼接。
幽灵任务演练:杀掉一个正在跑的 Worker 进程,看实例是否在可见性超时后回到重试。若一直 running,执行器的 sync 或心跳有洞,这比“偶发失败”更危险,因为槽位被死人占着。K8s 上删 Pod 应映射到失败或重试,而不是成功——成功必须来自任务进程的明确退出码。
队列设计:默认队列跑普通 ETL,重计算、爬虫、训练分开。GPU 机器只订阅训练队列。不要靠优先级在一个混排队列里玩花活,优先级解决不了镜像里根本没有 CUDA 的问题。池解决的是逻辑配额,队列解决的是机器能力,两者都要,不要互相替代。
原文 BaseExecutor 五个方法里,动手只需抓住入队、同步、心跳。end 是关停,trigger_tasks 是调度侧催促。自制执行器必须把同步写对。漏同步等于撒谎。这是第 5 章说“不要自制执行器”的技术理由,放在本节是为了让你知道协议哪一段最容易写错。
问题:Celery 和 Kubernetes 能同时用吗?
部分部署允许按任务选择,但心智负担高:两套日志、两套失败、两套镜像。先把一条跑到值班无怨言,再拆脏任务。混合的正当理由是“这类任务必须强隔离且时长值得付税”,不是“我们要展示两种执行器都会配”。
问题:槽位报满时该加 Worker 还是加大池?
先看池。池满是逻辑刹车,加 Worker 只是让更多进程去等同一把锁。池有余而执行器槽位满,才加 Worker。槽位与池都有余仍 queued,才查队列订阅和 DAG 是否暂停。三问顺序错,会买来一排空转机器。
五、从 Local 迁走的触发条件
出现以下任一,才认真评估 Celery 或 K8s:单机 CPU 长期打满且任务可并行;故障域不能再是一台机器;依赖库冲突到无法共处一个环境;需要按队列把 GPU 与 ETL 分开。没有这些,Local 加独立 PostgreSQL 仍可服务小团队。迁走时保留 Local 对照环境,专门测“是不是集群税”。对照环境可以很旧、很土,但它是尺子。没有尺子,K8s 上的八秒会变成对 Airflow 产品的永久偏见。偏见一旦形成,团队会改去别的编排器,而真正的税还在镜像里。选型是可逆的,偏见难逆。所以触发条件要写进平台决策记录,防止因新鲜感迁移。
六、心跳与幽灵的值班口令
心跳年龄超过阈值:先看执行器进程,再看数据库是否让心跳写不进去。不要先重启 Web。幽灵 running:对照执行侧是否还有进程或 Pod。没有则应在可见性超时后失败重试;没有发生,就是 sync 洞,升为平台事故而不是单个 DAG 失败。口令的目的是防止值班把执行器问题派给 DAG 作者改 SQL。作者改 SQL 解决不了幽灵。选型时问供应商或自建方案:可见性超时怎么配、OOM 如何映射状态。答不出,不要上。上了以后用口令活。Local 对照仍然是口令的一部分:同一窗 Local 正常、集群幽灵,锅在集群协议。反过来 Local 也悬挂,锅在任务把进程卡死,例如死循环或未超时的请求。口令把锅分对,选型才不会被单次事故推翻。推翻选型的成本,高于修好一次 sync。
七、选型决策记录怎么写
写清当前形态、触发迁出的条件是否已满足、对照基线秒数、目标执行器、预期税、回退条件。未满足触发条件却迁移,记录里必须出现风险接受人。没有接受人的迁移视为兴趣项目,不准进生产。兴趣项目可以在预发玩。预发玩坏了,对照环境还在。对照环境是 Local。Local 继续当尺子。尺子丢了,决策记录里的秒数无法复测。无法复测的选型会变成信仰。信仰不能值班。值班需要回退条件:例如镜像税超过执行时长百分之四十就回到 Celery。条件要可测。可测才能执行。执行才叫决策。决策不是会议纪要里的“倾向云原生”。倾向没有阈值。阈值在记录里。记录在本节产出。产出比会画光谱图重要。光谱图已经有了。缺的是带数字的记录。数字来自 3.2 的对照实验。实验格式在 6.2。本节先要求有记录。有记录才允许改配置。改配置会动所有任务的入队路径。路径一动,幽灵与心跳的口令要重练。重练写进同一张记录。记录是选型的合同。合同变更要有人签字。签字的人半夜接幽灵电话。电话会教育兴趣。兴趣会收敛。收敛后的执行器才能进 4.1 的形态表。形态表引用记录。记录引用秒数。秒数引用 Local。Local 不丢人。丢人的是无记录迁移。无记录迁移会在第一次税过高时互相指责。指责解决不了 Pod 拉镜像。拉镜像要时间。时间在记录里早就该看见。看见还迁,是接受。接受要有人。人在记录第一行。第一行空着,不准迁。不准迁是 3.2 的牙齿。牙齿保护调度器,也保护睡眠。睡眠是运维资源。资源比时髦贵。时髦写不进 SLA。SLA 写进合同。合同从 DAG 到执行器是一条。一条上每一环都要有记录。执行器这一环常被口头决定。口头决定在本节终止。终止于写下来。写下来才算选过。选过才能部署。部署在下一章。下一章不问品牌。问记录。记录在你笔记本里。笔记本比幻灯片可靠。幻灯片会美化税。笔记本有秒数。秒数不美化。不美化才能选型。选型结束。
八、回退条件必须可测
决策记录里写“税过高则回退”不算。要写:入队到 running 超过 Local 基线多少秒,或税占比超过百分之多少。数字才能在一周后执行回退而不开会。开会是兴趣项目的复活仪式。仪式用数字打断。打断写进记录。记录没有数字,迁移视为未完成。未完成不准改生产执行器配置。配置一改,口令要重练。重练成本应写进同一张纸。纸上有秒数、阈值、接受人。三人三项,缺一否决。否决保护睡眠。睡眠比时髦贵。时髦写不进 SLA。SLA 写进合同。合同延伸到执行器这一环。这一环用数字收口。收口结束 3.2。3.2 结束光谱。光谱结束于记录。记录结束于阈值。阈值结束兴趣。兴趣结束。选型结束。
核心回顾
- execute_async 只保证入队,sync 才写回终态,所以 UI 可滞后
- heartbeat 申报槽位,决定调度还能放行多少
- Local 是延迟对照黄金标准
- Celery 要运维 Broker 与幽灵任务
- K8s 换隔离,付镜像与调度税
- 短任务不要默认一任务一 Pod
下一节看指挥按什么时间模型发令,以及解析为何必须放进子进程。