5.2 Table API与SQL:声明式的驾驶舱
5.2 Table API与SQL:声明式的驾驶舱
本节摘要:SQL 是今天实时数仓的主战场:你声明"要什么",引擎规划"怎么算"——包括状态结构、序列化与清理策略。本节讲清流式 SQL 的动态表心智模型、窗口聚合与普通聚合的状态差异、各类 join 的状态代价,以及"看执行计划核对状态成本"的工作流。读完你应能写出引擎友好、状态不失控的流式 SQL。
从手写算子到报菜名
上一节的进程函数让人见识了控制权,也见识了样板代码。现在把同一个需求——"统计每个商户最近一分钟的成交额"——交给 SQL:
-- 窗口表值函数版:语义清晰,状态由窗口函数托管 SELECT shop_id, window_start, SUM(amount) AS gmv FROM TABLE( TUMBLE(TABLE payments, DESCRIPTOR(pay_time), INTERVAL '1' MINUTE)) GROUP BY shop_id, window_start, window_end; -- 补一个每商户的实时成交排行(topN),大屏右侧的"实时热卖榜"就是它 SELECT shop_id, gmv, rank FROM ( SELECT *, ROW_NUMBER() OVER (PARTITION BY window_start ORDER BY gmv DESC) AS rank FROM shop_gmv_per_minute) WHERE rank <= 10;
两段代码,零状态管理代码、零定时器注册。这不是省事那么简单——省掉的是一整类错误:状态清理策略、序列化布局、聚合缓冲的大小,全部交给引擎的优化器,它的经验比你我的直觉可靠。这就是 SQL 成为实时数仓默认起手式的原因。
动态表:流上跑 SQL 的心智模型
关系代数天生面向"静止的表",流是"永不静止的表",两者靠动态表概念缝合。流被想象成一张持续被 INSERT 的表:每来一条数据,表多一行;SQL 查询在这张表上持续求值,结果表的变化再被编码回流(追加流或更新流)。这个模型解释了流式 SQL 最反直觉的一点——一条普通的 GROUP BY 会源源不断吐出更新:每笔新支付进来,商户的累计 gmv 变了,结果表对应行要撤回重发(收回旧值、发出新值)。下游若是支持更新的存储(比如 OLAP 引擎的表模型)就照单全收;若是纯追加的日志,就要靠窗口聚合把更新"封口"成一次性结果。
由此推出流式 SQL 的第一实践原则:能窗口聚合的别裸聚合。裸 GROUP BY 的状态与更新流永远膨胀;窗口聚合把结果按窗口封存,状态随窗口销毁而清理,下游也只需处理追加。
状态成本逐项盘点
流式 SQL 的每一类算子都拖着一份状态账单,评估 SQL 时逐项过:
窗口聚合:状态 = 活跃窗口数 × 活跃键数 × 聚合缓冲。窗口结束由水位线触发销毁,是账单最清爽的一类。
普通聚合:状态 = 全部活跃键 × 聚合缓冲,永不自动清理,靠配置的空闲状态保留时间兜底——设太短会误删活跃键(数据重算),设太长状态虚胖,必须按业务节奏校准。
双流 join:状态 = 两条流各自窗口期内的全量缓存,interval join 按时间界清理,普通 join 靠空闲保留兜底。join 是流式 SQL 状态成本的头部来源,能加时间条件的一定加。
topN:状态 = 排名窗口内的全部候选行,ROW_NUMBER 的分区键里带上时间片(如上例的 window_start),让状态随时间片滚动清理——漏了这一刀,热卖榜的状态会无声地长到天荒地老。
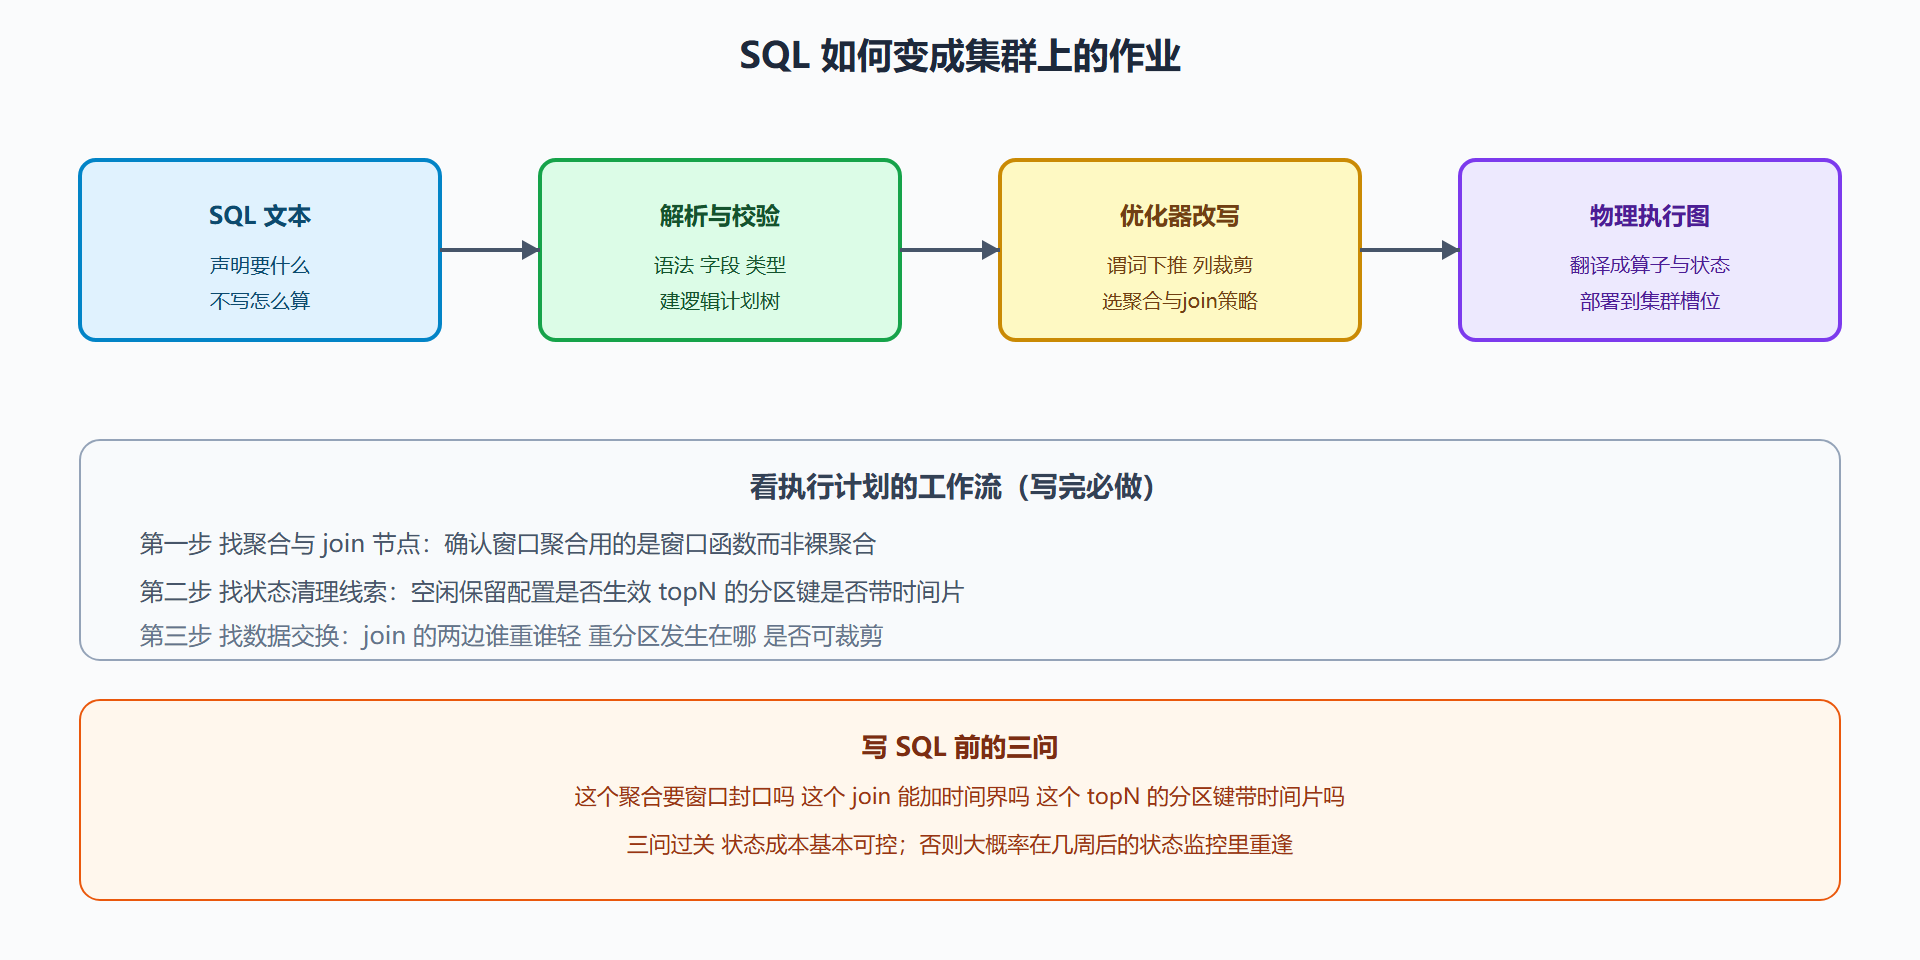
图 5-2 一条 SQL 的落地之路:从声明到执行图
空闲状态保留:救命但也伤人的旋钮
流式 SQL 有个必须认识的配置:空闲状态保留时间(state retention)。它对"一段时间没被更新的状态"做清理,是裸聚合与 join 的默认兜底。它的双刃剑属性要刻进肌肉记忆:设短了,"活跃但暂时没数据的键"被误删,键再次出现时引擎当新键从头算——业务表现是"数据突然翻倍或统计口径漂移";设长了,状态虚胖拖慢快照。校准依据是键的天然活跃周期:用户维度按会话间隔算,商户维度按营业时段算,设备维度按上报周期算。第 8 章调优现场会再遇到它。
💡 关键直觉:SQL 的省心是有边界的——边界就在"优化器看不见的业务语义"。它能优化执行路径,但它不知道"你的商户凌晨三点不营业"这种领域知识;状态保留这类参数,终究要人按业务节奏拍板。
一条慢 SQL 的优化实录
按"写完必看执行计划"的纪律,拿一条真实慢 SQL 演练完整流程。原 SQL:按商户聚合当天累计成交并取每城市的排行。症状:运行两天后状态涨到令心跳变慢,topN 部分是重灾区。执行计划三步走查到的病灶:其一,当天累计是裸聚合(没有窗口封口),状态键数等于全量活跃商户数且永不清理;其二,排行的分区键是城市 ID——每个城市维护一个全量商户的排名结构,热门城市的状态单键巨大;其三,空闲保留配置未生效(裸聚合根本不适用该参数的默认行为)。三处病灶对应三张处方:累计口径改成"按小时切片加下游再累计"(窗口封口);排行分区键改为"城市加小时片"(状态随切片滚动);跨切片的当日汇总交给 OLAP 端做(分层聚合,把"永不消失的今天"拆成有限个切片)。优化后状态规模降一个量级,心跳恢复正常。
这条实录里的分层思想值得单独记一笔:流引擎擅长"有限窗口内的快速结算",把无界累计拆给"窗口切片加下游汇总",是流式 SQL 里最常用的减负手法——它把一个数学上无界的状态需求,翻译成了引擎负担得起的样子。
收尾补一句版本协作的建议:SQL 作业的迭代节奏通常比 DataStream 快(改一行比改一个函数快得多),这让"变更纪律"更重要——再小的 SQL 改动也要走 4.3 节的快照通道,因为 SQL 的执行计划可能在版本间重排,算子 UID 的稳定性要靠显式声明来保。
本节要点
- 动态表模型让流上跑 SQL 成立,代价是裸聚合的持续更新流——能窗口封口的别裸聚合。
- 状态账单四巨头:窗口聚合最清爽,裸聚合靠保留时间兜底,双流 join 记得加时间界,topN 分区键必须带时间片。
- SQL 写完必看执行计划,三步走:找聚合与 join、找状态清理线索、找重分区位置。
- 空闲保留时间是双刃剑,按键的天然活跃周期校准,不按感觉。
聚合之外,还有一类需求在等着:识别事件的"序列模式"。下一站的 CEP,专门治"连续三次失败"这种聚合写不出来的病。