- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
Apache Flink 实战教程
「反压」是流计算圈的一句行话,说的是下游处理不过来时,压力沿着数据链路一路顶回上游的现象。第一次在值班室里听懂这个词的人,往往刚被一个 Flink 作业折腾了整晚:checkpoint 反复失败、告警群里消息刷屏、大屏上的指标停在了半小时前。这本教程想带你抵达的,正是那种时刻——不是在幻灯片上理解流计算,而是在真实的作业、真实的故障、真实的上线节奏里,把 Apache Flink 这套引擎变成你手上趁手的工具。
这本教程讲什么
Apache Flink 是一个分布式流批一体计算引擎。它最核心的本事,是把"持续到达的数据"当作一等公民来处理:数据一边流入,计算一边进行,状态一边更新,结果一边产出,延迟可以压到毫秒级。与"攒一批再算"的传统批处理相比,它更接近自来水而不是水车——你不用等水库蓄满,拧开龙头就有水。
但掌握 Flink 的难点从来不在"跑起一个词频统计 demo",而在三件真正考验工程功力的事上:
- 时间。现实世界的事件总是乱序到达的:用户手机断网后重连,日志采集管道抖动,上游补发历史数据。如何给"迟到的事件"一个公道的说法,是流计算的第一个哲学问题。Flink 用事件时间、水位线、窗口这组概念回答了它。
- 状态。流式计算几乎都带状态:去重要记住见过的用户,聚合要累计中间结果,风控要维护滑动特征。状态放在内存还是磁盘、快照怎么打、故障后怎么恢复,决定了作业的成败。Flink 把状态管理做成了引擎的内置能力。
- 一致性。"这条数据到底算没算过"在分布式系统里不是一句废话。Flink 以 checkpoint 机制给出端到端精确一次的答案,让"故障恢复后结果依然正确"成为可以写进 SLA 的承诺。
围绕这三件事,再往外延伸出架构、部署、运维、生态与调优,就构成了全册的骨架。
全册知识地图
整册按"值班工程师的成长路径"组织:先认识引擎,再拆开引擎,然后依次攻克时间、状态、API 三座山头,最后进入运维与实战。章节之间的依赖关系如下图——虚线以下是必修地基,实线以上可以按需深入,但建议按顺序通读,因为后面的排错案例会反复调用前面的概念。
图 0-1 全册知识地图:章节依赖与学习路径
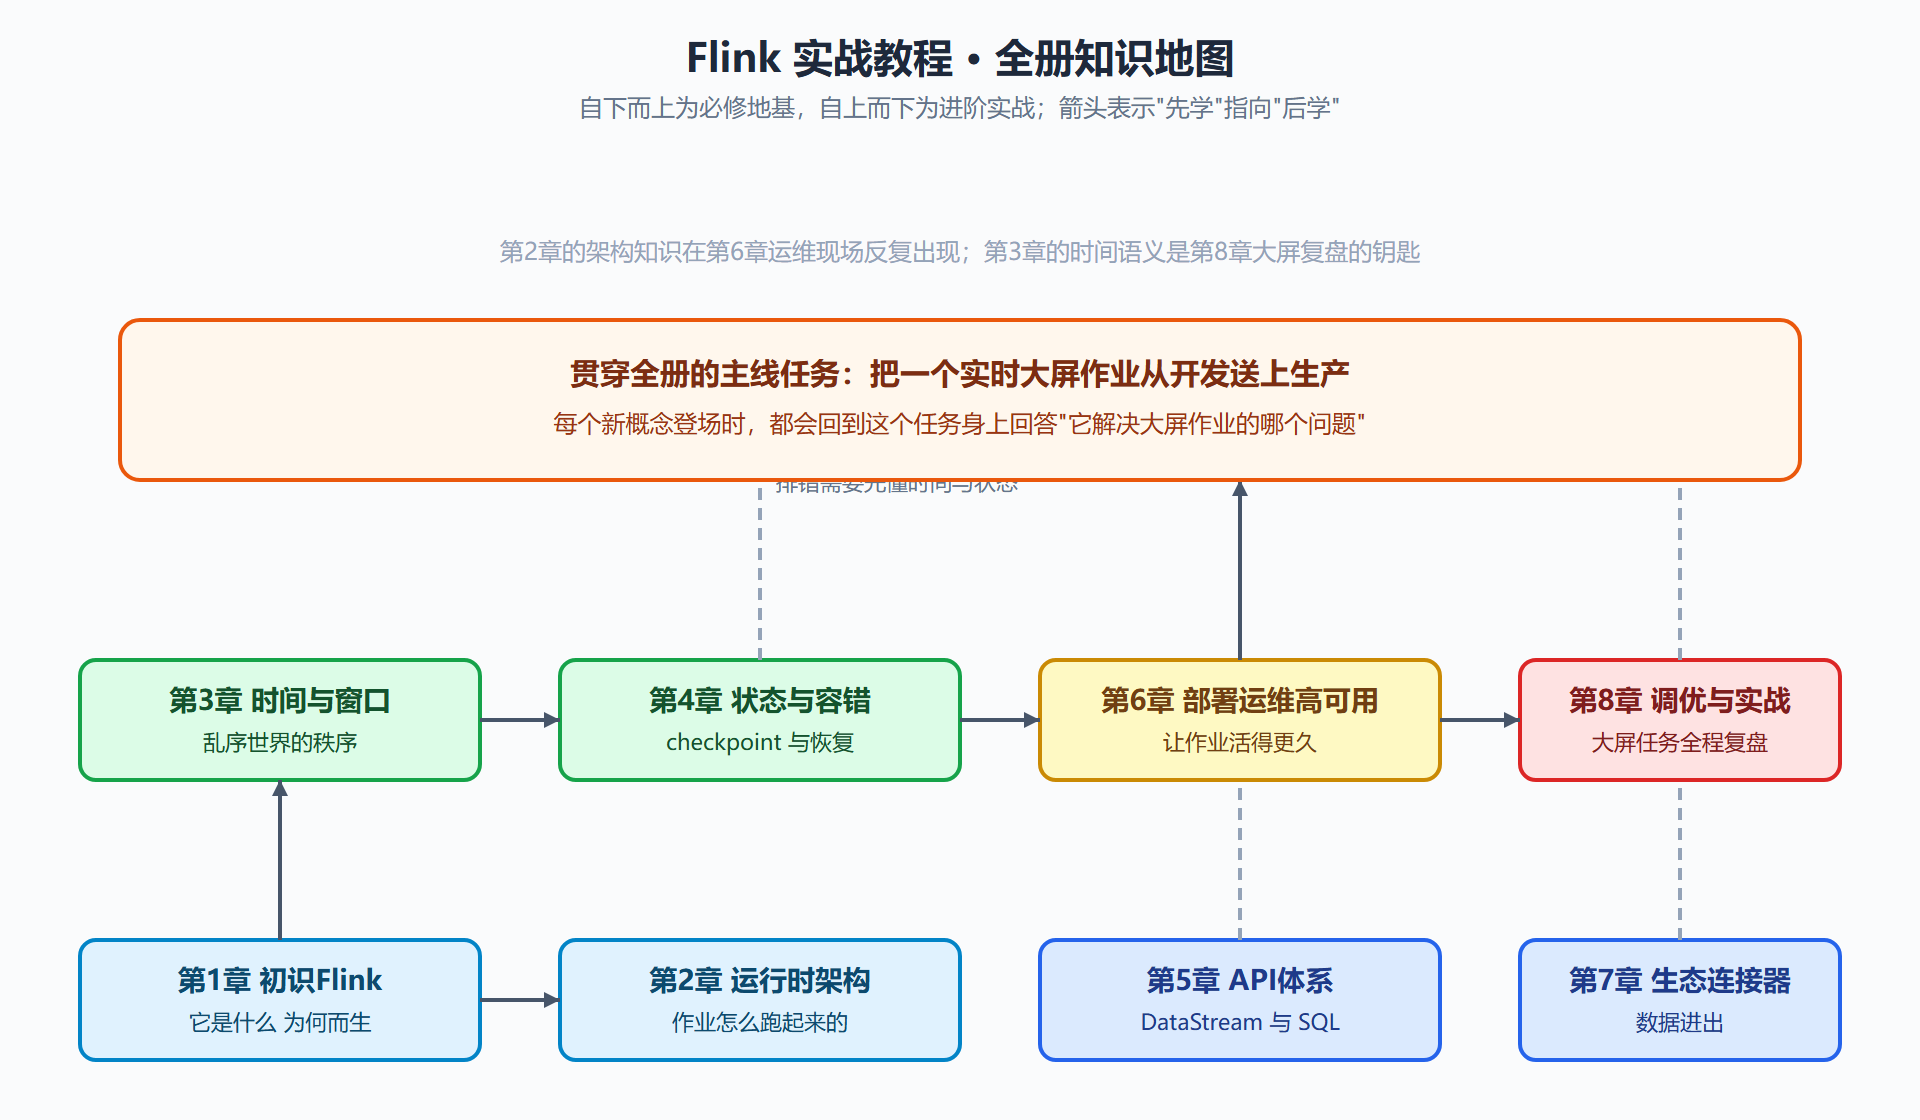
读这张图的正确姿势:如果你赶时间,第 1、2、3、4 章是一条不可跳过的主干;如果你已经生产在跑 Flink、只是被故障追着走,可以直接从第 6 章的运维现场和第 8 章的调优实战切入,缺哪块概念再回头补。
为什么值得花时间学它
流计算早已不是小众需求。风控要在用户输密码的时候就拦下盗号,推荐要在用户滑动的瞬间更新画像,大屏要看到这一分钟而不是昨天的世界。凡是有"现在就要答案"的地方,就有流计算的岗位,而 Flink 是这个领域事实上的标准答案——阿里双十一的实时计算、Netflix 的流式管道、众多银行的实时风控,背后都有它的身影。招聘市场上,"懂 Flink"常常就是"懂实时数仓"的同义词。
更长远看,Flink 教给你的不只是某个框架的用法,而是一整套关于时间、状态与一致性的思维方式。这套思维可以迁移:你换到任何流式系统(Kafka Streams、Pulsar Functions,甚至自研引擎),面对的仍然是水位线怎么定、状态怎么存、故障恢复后数据对不对这些同一批问题。
怎么用这本教程
每一章都按同样的节奏推进:先把概念放进一个真实的值班场景,再拆机理,然后给可运行的代码或配置,最后用一个排错或复盘案例收尾。书里的案例都围绕一条主线展开——一个电商实时大屏任务从需求评审、开发联调、上线值守到性能攻坚的全过程。这条主线在第 8 章会完整合龙,前面各章的概念都是它的一块拼图。
动手上,建议你准备一个能跑 Flink 的环境(单机 Standalone 集群或 Docker 均可,第 6 章会讲部署),跟着各章的代码亲手敲一遍。流计算的很多直觉——比如水位线为什么要在"及时性"和"完整性"之间妥协——只有亲眼看到窗口延迟触发、迟到数据被丢进侧输出流的那一刻,才会真正长进脑子里。
准备好了就从第 1 章开始。值班室的灯亮着,我们从一个最朴素的问题谈起:既然有了批处理,为什么世界还需要一个专门做流的引擎。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...