6.1 部署模式:作业住在哪
6.1 部署模式:作业住在哪
本节摘要:部署决策有两个维度:住哪种房子(Standalone、YARN、Kubernetes)与怎么分房间(会话型共享集群、单作业型独立集群)。本节拆解两个维度的组合与取舍,重点讲清会话型与 Application 模式在资源隔离、故障爆炸半径、提交体验上的差异,并给出新集群的选型决策卡。
两个维度别搅在一起
聊部署最容易犯的错是把两个正交的维度搅成一锅粥:资源层(谁提供容器与进程托管)与作业组织方式(多个作业共享一个集群还是各住各的)。资源层是房子——自建平房(Standalone)、租在老旧小区(YARN)、拎包入住新公寓(Kubernetes);组织方式是户型——合租(会话型)还是整租(单作业型)。本节按"先户型、后房子"的顺序展开,因为户型对日常运维的影响更直接。
户型:会租还是整租
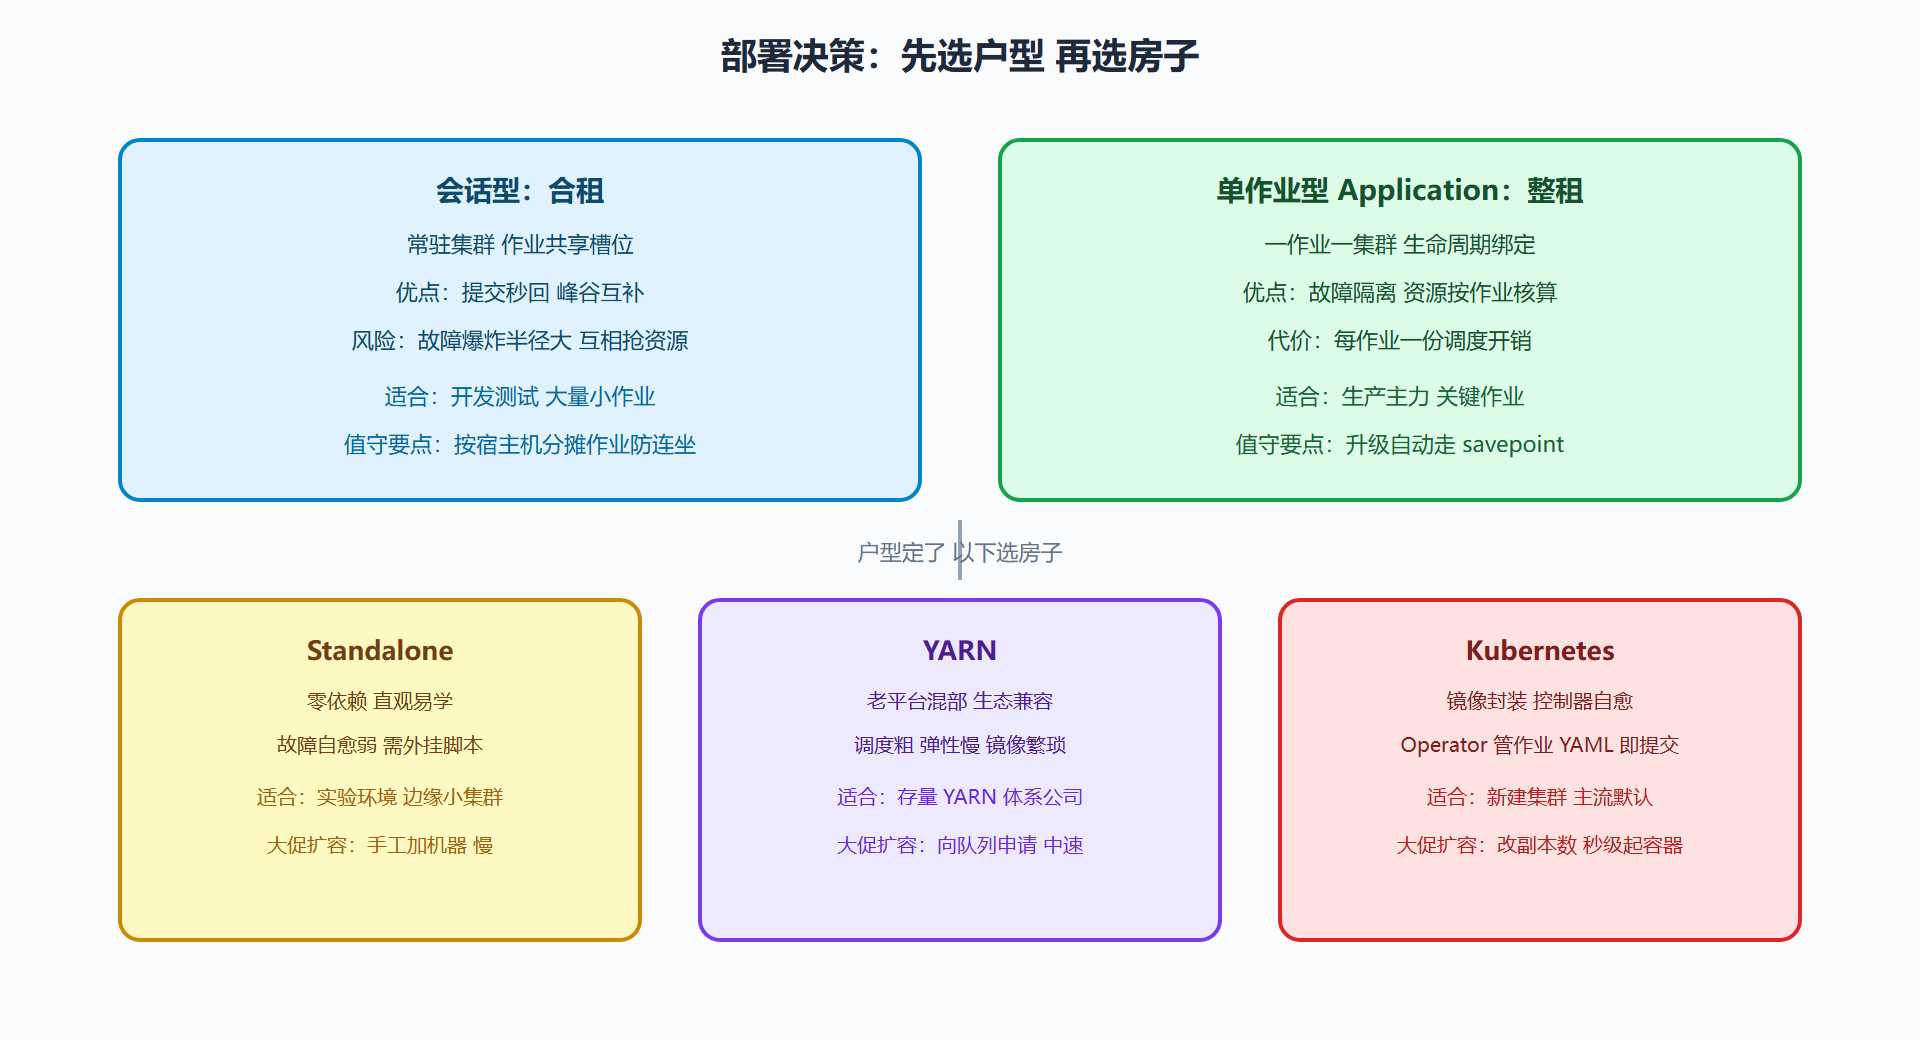
会话型(Session Cluster):先起一个常驻集群,之后作业挨个提交进来,共享全部 TaskManager 槽位。好处是提交秒回、资源池化、多个小作业的峰谷互补;坏处是故障爆炸半径大——一个作业把某台 TaskManager 的内存打爆,同宿主上其他作业跟着遭殃;作业之间还会抢托管内存与网络缓冲,互相制造反压。它适合开发测试环境与大批量的小作业。
单作业型(Application Mode):每个作业一个独立集群,main 方法直接在集群里执行,作业生命周期与集群生命周期绑定。作业结束集群即撤,资源账目清晰到作业粒度。代价是每作业一份 JobManager 与调度开销,作业数量大时集群碎片化。它是当前生产环境的主流推荐,理由有三:故障隔离(作业挂了只影响自己)、升级独立(配合第 4 章的 savepoint 逐作业搬家)、资源核算清晰(按作业拉账单)。
顺带回应第 2.4 节埋的伏笔:Application 模式把"生成作业图 + 传输 JAR"的开销挪进了集群内部,提交端只发一份轻量描述——JAR 几百兆时,提交速度差异立竿见影。
房子:三种资源层
Standalone:Flink 自带的进程管理,脚本起 TaskManager 常驻。优点是零依赖、直观,适合本地实验与小规模生产;缺点是故障自愈弱——TaskManager 进程死了,依赖它自身或外部脚本拉起,宿主机级别的故障要靠人。作为生产主体如今已不多见,但作为理解架构的教具永远不过时。
YARN:老一代大数据平台的常驻租户。资源由 YARN 统一调度,与 Hive、Spark 生态共居一个集群,混部老平台时代的主流选择。代价是调度粒度粗、镜像与依赖管理繁琐、弹性伸缩的响应偏慢。新建集群已很少选它,除非公司数据平台整体仍在 YARN 体系内。
Kubernetes:当下的默认答案。容器镜像封装一切依赖,控制器负责故障拉起与滚动升级,弹性伸缩接 HPA 或自定义指标,Flink Kubernetes Operator 把作业声明为 CRD 资源——提交一个作业变成提交一份 YAML,第 2.4 节的提交流水线被编排层全面接管。代价是团队需要具备 K8s 运维能力,调试链路比裸进程长一截。
# Flink Kubernetes Operator 的作业声明(节选):一份 YAML 就是一次提交 apiVersion: flink.apache.org/v1beta1 kind: FlinkDeployment metadata: name: dashboard-job spec: image: registry.internal/flink-dashboard:1.19-2.3 flinkVersion: v1_19 serviceAccount: flink jobManager: resource: { memory: "2048m", cpu: 1 } replicas: 1 # 高可用时配合 HA 配置调整 taskManager: resource: { memory: "4096m", cpu: 2 } replicas: 6 job: jarURI: local:///opt/flink/usrlib/dashboard.jar entryClass: com.demo.DashboardJob parallelism: 24 upgradeMode: savepoint # 升级时自动走 savepoint 通道,呼应第 4 章
图 6-1 部署决策卡:户型与房子的组合
值守视角的三条提醒
第一,扩容演练要真刀真枪。Kubernetes 上"改个副本数"听起来轻巧,但大促前必须演练一次完整链路:副本扩上去、作业稳定、缩回来不丢状态。有些团队临阵扩容才发现镜像仓库限流、节点池余量不足,白白错过黄金处置期。
第二,作业与宿主的对账。会话型集群要刻意让关键作业分摊在不同宿主机上(K8s 的反亲和性或 YARN 的标签调度),否则"一台宿主机挂掉,同宿主的三个关键作业同时失效"就是值班室里最狼狈的连坐事故。
第三,提交通道也要备份。Operator 或 CI 通道故障时,值班工程师要能退回命令行提交(带 savepoint 恢复)。通道的通道,是预案里最容易被忽略的一页。
从会话型迁到单作业型:一次真实的集群改造
存量集群怎么演进?用一次真实的改造收尾本节。某团队三年前建的集群是会话型 Standalone,四十多个作业挤在十台机器上,问题清单逐年变长:一个作业的内存溢出常常连坐邻居、作业升级要排队协调"谁和谁共享宿主"、资源核算靠人肉记账。改造分三步走。第一步:新作业先立规矩——新建作业一律单作业型部署在 Kubernetes 上,存量不动,避免一刀切的风险。第二步:按痛点排序迁移——把"连坐重灾区"(与故障作业共享宿主的作业)和"资源大户"先迁,每迁一个走一遍 4.3 的 savepoint 流程;迁移顺序的本质是按痛感排优先级。第三步:会话集群只留测试——生产作业清空后,老集群降级为开发测试用途,硬件逐步回收。整个改造历时一个季度,期间生产零事故,靠的正是"新规矩只管增量、存量按痛感渐进"的迁移哲学。
这次改造还有一个容易被忽略的收获:单作业型落地后,"作业级"的运维动作(重启、扩容、升级、对账)全都变成了原子操作,值班手册从厚厚一叠简化成一页决策树。部署形态决定的不仅是资源隔离,还有运维动作的粒度——这是户型选择的深层红利。
本节要点
- 部署决策两维度:资源层(Standalone、YARN、Kubernetes)与户型(会话型、单作业型),分开想再组合。
- 生产主力默认单作业型:故障隔离、独立升级、资源核算三红利;会话型留给开发测试与海量小作业。
- Kubernetes 加 Operator 是新建集群的默认答案,核心红利是故障自愈与弹性伸缩。
- 大促前必做三演练:扩缩容链路、宿主机反亲和、命令行提交备份通道。
房子选好了,还差最后一道保险:大脑挂掉怎么办。下一节给 JobManager 配上替身。