8.2 SIMD与NEON向量化
8.2 SIMD 与 NEON 向量化
本节摘要:NEON 是 ARM 的 SIMD 扩展:三十二个
v寄存器、每个 128 位,一条指令同时对多个数据通道做同一运算。本节用"数组加法"标量版与向量版对照开题,讲清 NEON 的寄存器视图、加载指令家族与典型指令模式,并核算收益边界——哪些循环能拿数倍加速,哪些白忙一场。
流水线解决的是"指令流水的效率",NEON 解决的是"单条指令的宽度"。两者正交且叠加。向量化是汇编工程师最常被期待拿出的一手,也是 compiler 自动化程度最高的一块——所以本节的讲法与常见教程相反:先做一次"编译器自动向量化"实验看清上限,再讲人写 NEON 的语法与场景,最后诚实地算一算哪些情况人下场是负资产。
从一段循环的两种身材说起
实验对象是最经典的逐元素加法。先看编译器自动向量化能做到什么——-O3 加循环次数明确(让编译器确信安全),一条 C 循环直接产出 NEON:
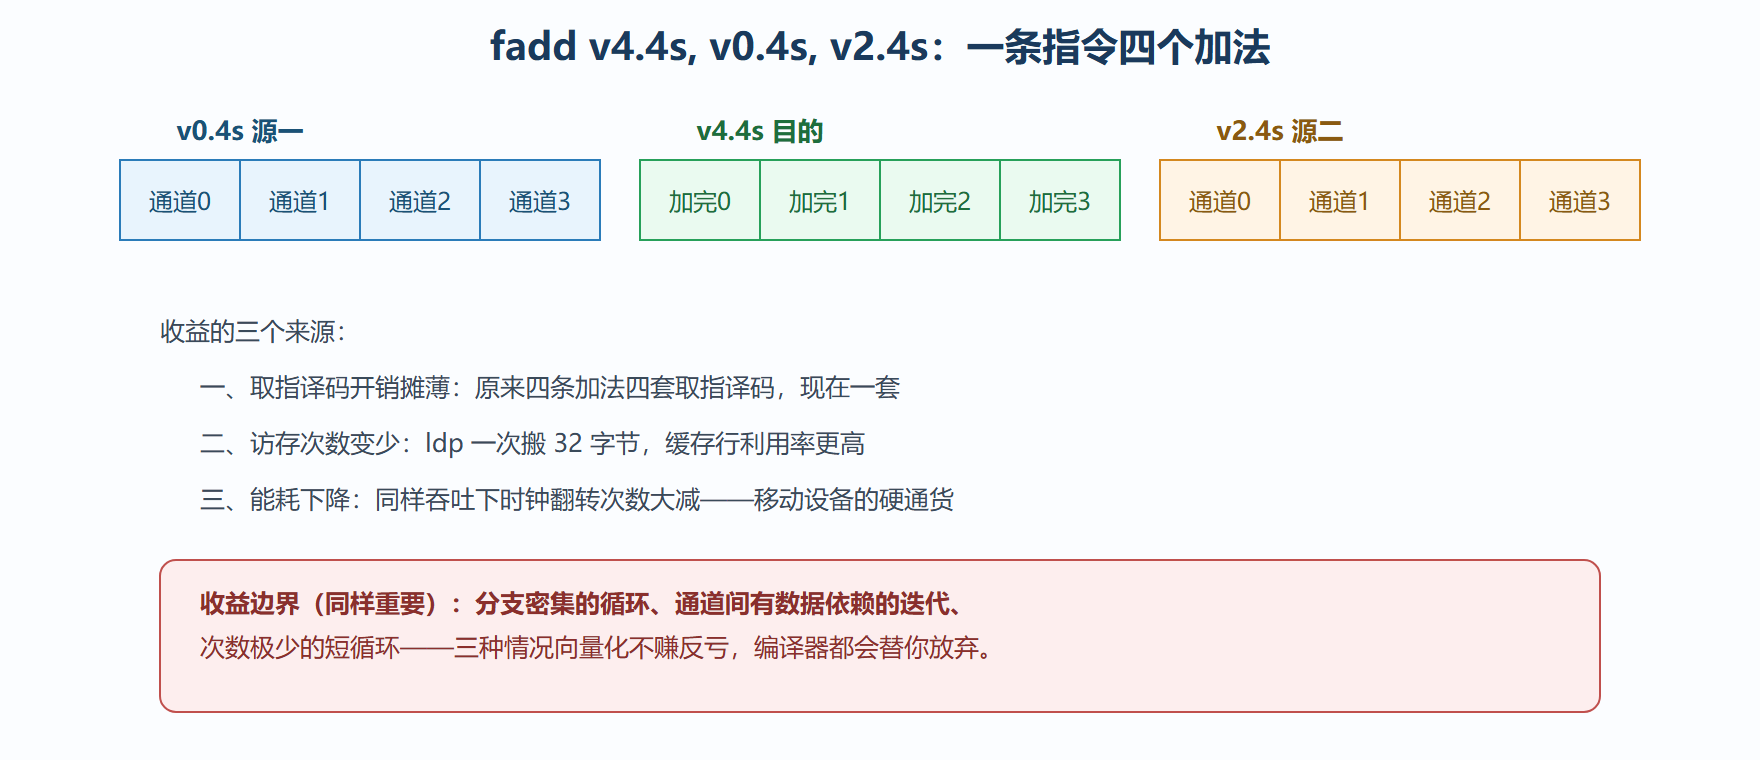
float a[N], b[N], c[N] 的 c[i] = a[i] + b[i],-O3 自动向量化后: .Lloop: ldp q0, q1, [x0] // 一次取 8 个 float:q 寄存器 128 位装 4 个,取两份 ldp q2, q3, [x1] fadd v4.4s, v0.4s, v2.4s // 4 通道浮点加:一条指令干四个加法 fadd v5.4s, v1.4s, v3.4s stp q4, q5, [x2] add x0, x0, #32 // 指针一次前进 32 字节 ...
v 前缀寄存器就是 NEON 视图:同一个 128 位寄存器文件,按 v0.4s 看是 4 个 32 位浮点、按 v0.8h 看是 8 个 16 位整数、按 v0.16b 看是 16 个字节——数据类型由指令后缀声明,寄存器本身没有类型。fadd v4.4s, v0.4s, v2.4s 的语义:两个源寄存器各出 4 个 float 通道对位相加,结果 4 个通道写目的。所谓向量化,本质就是"把循环计数器变成通道编号"。
人写 NEON 的三个高频模式
自动向量化失败的场景,才轮到人下场。三个模式覆盖大多数手写需求。模式一,显式控制循环次数与对齐:编译器在循环次数不明时既做向量版又做尾部标量版,你若在汇编里自己保证次数与 16 字节对齐,就能只留向量主干。模式二,跨通道操作:编译器对"数组元素两两交换""奇偶位分离"这类跨通道模式经常放弃自动向量化,NEON 的 uzp1(解交错编织)、zip1(交错编织)、tbl(查表重排)家族直接表达。模式三,饱和与定点运算:图像处理里的 sqadd(饱和加法,超出范围就钉在边界)在 C 里要靠内建函数绕弯,NEON 一条到位。各来一例:
// 模式二示例:把 v0 里的 8 个 16 位奇偶位分离 uzp1 v1.8h, v0.8h, v2.8h // 取偶位通道 uzp2 v3.8h, v0.8h, v2.8h // 取奇位通道 // 模式三示例:图像亮度叠加,饱和防溢出 ld1 {v0.16b}, [x0], #16 // NEON 专用加载:16 字节进 v0 ld1 {v1.16b}, [x1], #16 sqadd v2.16b, v0.16b, v1.16b // 饱和加:亮部不会被溢出翻转成暗部 st1 {v2.16b}, [x2], #16
ld1 与 st1 是 NEON 的专用访存——注意它们与 ldr 家族不通用:ld1 的操作数是"寄存器列表加通道布局",还能一次加载多个寄存器到结构体阵列布局。混用两类访存指令是新手常见的编码混乱源头:ldr 往 v 寄存器搬在语法上可行,但布局语义与优化器沟通都更绕,保持"向量数据走 ld1 家族"的纪律最省心。
图 8-3:一条 128 位指令的通道解剖与收益来源
收益核算实验
按全书纪律,向量化的收益必须量出来。实验设计:浮点数组加法,规模与迭代次数固定,三种实现各跑同样轮次——纯标量 C(-O0)、自动向量化 C(-O3)、手写 NEON 汇编。参考数字(模拟器上,实机比例相近):标量版为基准 1,自动向量化约 3 到 4 倍,手写 NEON 与自动版持平或略慢。解读这个结果比任何语法知识都重要:自动向量化已经把"规整循环"这类最大众的场景吃干净了,人下场只在编译器放弃的场景(跨通道、饱和语义、精巧布局)有正收益。所以手写 NEON 的正确姿势不是"比编译器写得更好",而是**"写编译器表达不了的东西"**——与 5.3 节内联汇编的结论完全同构。变式实验:把 float 换成 short 试试 8 通道(v.8h),收益比例进一步上升——通道越窄,向量化摊薄越狠,这是图像与音频处理重度依赖 NEON 的算术原因。
深挖:SVE——通道宽度交给硬件的下一步
NEON 把通道宽度钉死在 128 位,代码移植到更宽的机器并不能自动变宽。ARMv9 的可伸缩向量扩展(SVE)换了思路:向量寄存器宽度由实现自选(128 位到 2048 位),指令按"谓词寄存器控制的活动通道"工作,同一份代码在窄机器与宽机器上都能跑满——循环控制自带"还剩几个有效通道"的表达式,尾部处理天然融化在指令语义里。对汇编层的意味:为超算与数据中心写的 SVE 内核,与为手机写的 NEON 内核,是两套并存的方言;选型的分界是目标平台——SVE 目前活在服务器与 HPC 侧,手机侧仍是 NEON 的天下。
回填一个 8.2 正文承诺的细节:ld1 的多寄存器形态能一次加载"结构体阵列"——ld1 {v0.4s, v1.4s, v2.4s, v3.4s}, [x0] 从内存读四个 4 通道组并按字段解交错到四个寄存器,对应的 st1 再交织回去。处理"数组结构体到结构体数组"的转置类需求(图像平面分离、音频多声道拆分)时,它一条顶四条,配合 uzp 家族的纯重排指令,构成 NEON 数据整理的全部工具箱。手写向量化之前先问一句"数据要不要先重排"——重排的成本常常决定整个方案值不值。
常见问答
问:怎么确认编译器真的自动向量化了? 答:看反汇编找 v 寄存器与 .4s 类后缀,或让编译器输出优化报告(GCC 的报告开关会逐循环声明向量化成败及原因)。报告里"原因:循环次数未知"与"原因:可能存在别名依赖"是两大高频失败项——分别对应"补循环次数信息"与"加限定符声明不重叠"两个修法。
本节要点回顾
- 128 位与视图:
v寄存器无类型,通道布局由指令后缀声明,4s是 4 个 32 位。 - 专用访存:向量数据走
ld1与st1家族,与ldr保持纪律分界。 - 自动向量化的地盘:规整循环已被编译器吃干净,人写只在它放弃处有正收益。
- 三个手写模式:显式对齐与次数、跨通道重排、饱和定点。
- 收益三来源:摊薄取指译码、减少访存、降低能耗——移动场景第三条最值钱。
重型武器看过了。下一节回到方法论:一条从测量出发的完整优化纪律。