8.1 流水线与hazard
8.1 流水线与 hazard
本节摘要:处理器像组装线一样把指令分成取指、译码、执行等多站重叠推进,正常情况每周期完工一条;但三种冒险——数据还没就绪的数据冒险、跳转让流水线白装的 control 冒险、两指令抢同一部件的结构冒险——会让线停下来。本节用可见的指令序列展示三种冒险,并给出汇编层能做的事与做不了的事。
优化要有模型。本章第一个模型是流水线:它是"为什么这段汇编快、那段慢"的第一层解释,也是所有指令级优化技巧的共同源头。我们的目标不是造处理器,而是看懂指令序列在流水线眼里的形状——看完这节,你读汇编会多一种"时间维度"的直觉。
流水线的直觉与三种堵车
先立模型。经典五级流水线把每条指令的旅程切成五站:取指、译码、执行、访存、写回。流水线让五站同时开工——第 1 条在写回时,第 5 条正在取指——理想情况每周期有一条指令完工,吞吐直接翻五倍。代价是指令之间开始"互相看不见":后一条开工时,前一条还没完工。三种"堵车"由此而来。数据冒险:后一条要用前一条的结果,结果还没写回。控制冒险:分支跳转还没判定去向,流水线已经预取了后面的指令——跳了,预取全白装。结构冒险:两条指令要抢同一个硬件部件。一张表把三者收拢:
| 冒险类型 | 触发序列 | 硬件的化解 | 汇编层能做的 |
|---|---|---|---|
| 数据冒险 | 写后立即读同一寄存器 | 前递通路直送结果 | 多数自动化解;避免紧邻依赖链可帮调度器 |
| 控制冒险 | 条件分支 | 分支预测器猜方向 | 让分支模式规律;减少分支数量(8.3 节) |
| 结构冒险 | 多发射下抢端口 | 增加硬件副本 | 编译器已安排,手写时避免极端密集同类指令 |
数据冒险有个常见误解要先扫掉:以为"读到没写回的寄存器"会出错。不会——前递通路会把执行结果直接从上一站递给下一站,正确性永远有保证,冒险影响的只是"要不要等一拍"的速度。另一类历史名词值得交代:老教材里的"延迟槽"(分支后必执行的指令位)在早期 MIPS 与早期 ARM 上存在,现代 ARM 已完全移除,读古董代码时别把它带进现代判断。
实验:冒险在反汇编里的长相
冒险本身看不见,但它的"解药"看得见。让编译器优化一段依赖链很重的代码,对比 -O0 与 -O2 的循环体:
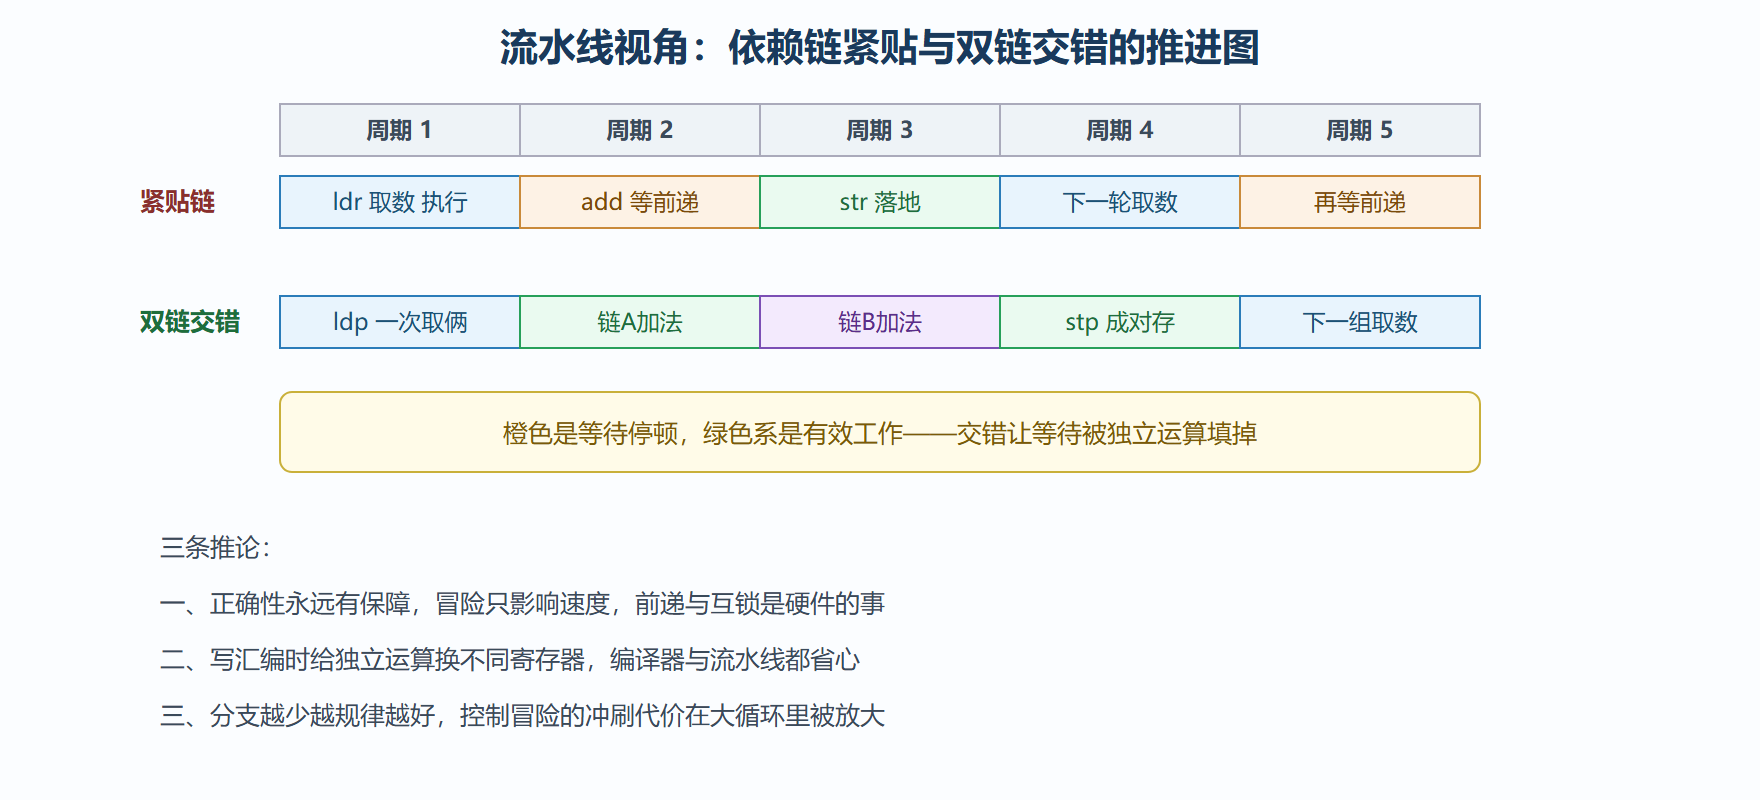
-O0 版(朴素直译,依赖链紧贴): ldr w2, [x0] // 取数 add w2, w2, w1 // 紧贴使用:数据冒险,等前递 str w2, [x0] ldr w2, [x0, #4] // 下一个元素 add w2, w2, w1 str w2, [x0, #4] -O2 版(循环展开加调度,两条独立链交错): ldp w2, w3, [x0] // 一次取两个元素 add w2, w2, w1 // 链 A add w4, w3, w1 // 链 B:与链 A 独立,流水线错峰 stp w2, w4, [x0]
解读:-O2 版的两个加法用了不同目的寄存器、来源互不依赖——两条链在流水线里错峰推进,数据冒险的等待被并行度填掉;ldp 与 stp 还顺手把两次访存并成一次。这就是 8.3 节"指令级并行"的雏形:把互相独立的运算交织起来,让流水线一直有活干。控制冒险侧做一个对照实验:同一个循环,一次用规律的条件(每次都进循环体),一次在循环体里加一个数据依赖的早退分支——后者在分支预测错误时的冲刷代价可以用性能计数器量出来(第 7 章 7.2 节的方法),规律版与数据依赖版的每周期指令数差距会给出直观数字。
图 8-2:流水线五站与两种循环形态的推进对比
汇编层的边界:能做与不必做
诚实划界很重要。汇编层能做的三件事:交织独立运算(换寄存器、展开小循环)、减少分支数量(条件选择替代短分支,5.1 节的 csel 正好复用)、让访存模式规律(配合 8.3 节的数据布局)。汇编层不必做的也至少三件:指令重排调度(现代乱序处理器自己会调度,静态排布收益趋近于零)、手工展开长循环(编译器的展开器更懂成本模型,还会照顾代码密度)、为特定微架构硬编码调度(换一代芯片就白干,这类工作交给编译器的调度模型)。一句话:汇编层优化聚焦在"给硬件喂什么样的序列",而不是"替硬件决定哪条先跑"——这条边界划清,8.3 节的优化清单就顺理成章了。
深挖:分支预测的三十年与一个经典实验
控制冒险的化解史值得一讲,因为它解释了现代处理器的"赌性"。最原始的策略是"分支必不跳,顺序预取";随后是静态预测(向后跳的循环分支默认跳,向前跳的默认不跳);再往后是动态预测——用历史表记住每个分支的脾气,两位饱和计数器让"连续跳了两次"的分支获得高置信度;现代预测器更进一步,间接跳转(目标来自寄存器的)也有专门的目标缓存追着猜。三十年军备竞赛的战绩是:规律代码的分支几乎不再有可测代价,预测失败的冲刷代价(十几级流水线全倒)成了唯一剩下的痛点。
有个经典实验能亲手验证"预测器的脾气":对一个大数组按 if (a[i] >= 128) sum += a[i] 累加,一次乱序数据、一次排序后数据。同样的代码、同样的数据量,排序版快得多——排序让分支模式变得规律(前面全不跳、后面全跳),预测器几乎弹无虚发;乱序数据让分支像掷硬币,预测失败率近半,冲刷代价吃掉大半吞吐。这个实验同时也是 8.3 节数据布局层的最佳注脚:数据的形状决定分支的形状,分支的形状决定流水线的效率——优化常常不在指令里,而在数据的排法里。
常见问答
问:乱序处理器既然会自己调度,汇编层的交织还有意义吗? 答:乱序窗口是有限的,依赖链太长时窗口填不满;交织提高的是"进入窗口的指令质量"。收益确实比单核顺序时代小了,但它免费且不冲突——这也是正文边界感那句话的出处:喂好序列仍是人的责任,只是别指望靠静态重排复刻乱序调度。
本节要点回顾
- 五站模型:取指、译码、执行、访存、写回,重叠推进换取吞吐。
- 三种冒险:数据靠前递自动化解、控制靠预测器赌、结构靠硬件副本,各管一摊。
- 交织是王道:独立运算换寄存器错峰推进,停顿被并行度填掉。
- 延迟槽是历史:现代 ARM 无延迟槽,读老代码别迁移旧直觉。
- 边界感:喂好序列是人的事,运行时调度是硬件的事,两头别越界。
机器模型立住了。下一章第二件武器:NEON 向量化——流水线再快,也得有人一次喂多条数据。