第1章 · 概述与 CAP
第1章 · 概述与 CAP
章节摘要:从 Facebook Inbox 写入瓶颈出发,理解 Cassandra 为何选择 AP、如何用可调一致性(CL)与 W+R≥N 在业务层重建「足够准」。读完能对照 MongoDB/HBase 说明何时该选无主宽列。
阅读收获
阅读完本章,你应当能够:
- 复述 Cassandra 2008 开源与 2011 CQL 成为默认接口的里程碑
- 用 CAP 坐标系定位 Cassandra,并解释
QUORUM与LOCAL_QUORUM差异 - 列举去中心化、线性扩展、多 DC 三大特性及各自运维代价
- 在选型讨论中指出 Cassandra 不适合 JOIN/强事务的场景
核心概念速览
Cassandra 的名字来自希腊神话中「预言无人信」的女祭司——分区时它放弃瞬时仲裁,承诺愈合后收敛。
子章节导航
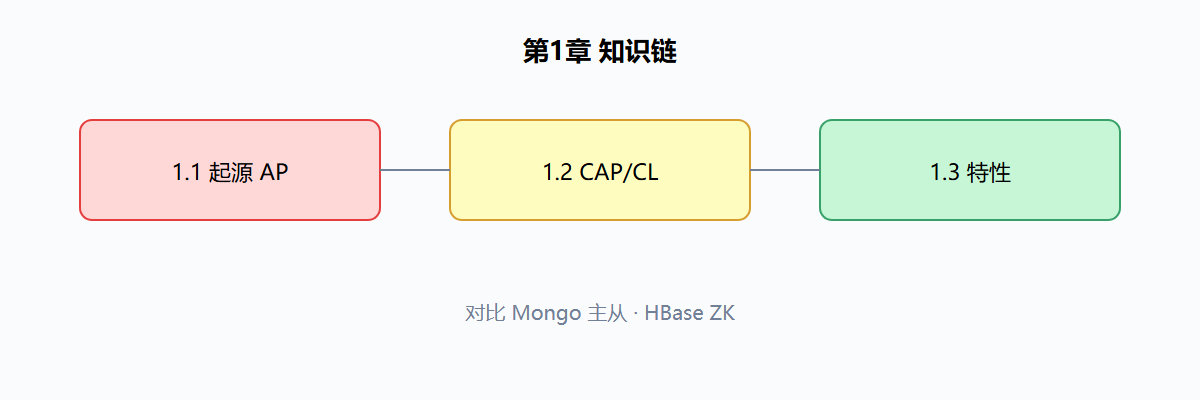
1.1 起源与发展
Facebook 2006 收件箱搜索、2008 开源、2010 进 ASF、CQL 1.2 范式迁移。
1.2 核心定位与 CAP
CAP 是坐标系而非判决书;W+R≥N 与读修复、Hinted Handoff、反熵 repair。
1.3 关键特性概览
去中心化、线性扩展、多数据中心;与 Mongo 副本集、HBase Region 对照。
子章节之间的逻辑关系
起源(为何 AP) → CAP(如何权衡) → 特性(工程后果) │ │ │ Inbox 双写 CL/RF 公式 多 DC / vnode
前置知识与后续延伸
- 前置:分布式系统入门、NoSQL 四分法
- 延伸:第2章 Gossip 与 LSM;第3章 查询驱动建模;第5章 竞品选型表
本章术语速查
| 术语 | 一句话定义 | 关键出处 |
|---|---|---|
| AP | Availability + Partition tolerance,Cassandra 默认锚点 | 1.2 |
| CL(Consistency Level) | 每次操作声明的应答副本数 | 1.2 |
| RF(Replication Factor) | 每个分区保存的副本总数 | 1.2 |
| W+R≥N | 读写法定人数相交的充分条件 | 1.2 |
| Read Repair | 读时比对副本并异步修复 | 1.2 |
| Hinted Handoff | 目标离线时由协调者代存写 | 1.2 |
| Anti-Entropy | 周期性 Merkle Tree 反熵修复 | 1.2 |
| vnode | 每节点 256 段虚拟 token | 1.3 |
| NTS | NetworkTopologyStrategy 跨 rack/DC 复制 | 1.3 |
常见疑问答疑
为什么 Cassandra 默认偏 AP 而不是 CP? 因为它的起源场景(Inbox Search)要求分区时仍能写入。CP 系统(如多数 ZooKeeper 方案)在分区时选择拒绝写或等待仲裁,可用性让位;Cassandra 把一致性交给客户端用 CL 按需购买。两者没有对错,只有契约差异。
CL=QUORUM 是不是就等于强一致? 不等于。QUORUM 只保证「前一次 QUORUM 写,后一次 QUORUM 读必能看到」这一有界语义;并发写冲突仍按 LWW(最大时间戳)收敛,分布式事务仍需 LWT。它比 ONE 严,比 ALL 轻。
R=3 时 QUORUM 是几? 是 ⌊3/2⌋+1 = 2。若需要容忍 1 个节点永久故障仍能 QUORUM 读写,RF 应设为 5(QUORUM=3),这样 3 副本存活即满足法定人数。
为什么本章反复与 MongoDB、HBase 对照? 三者都处理「大数据」,但协调模型不同:Mongo 副本集有主节点选举窗口,HBase 依赖 ZooKeeper 与 Master,Cassandra 无主 P2P。选型时这些差异比「谁支持 SQL」更重要。
前置知识与后续延伸
- 前置:建议先理解 CAP 的三种取舍,不必纠结形式化证明
- 延伸:第2章会把「CL 降级」落到 Gossip 与复制协议;第3章讨论 PRIMARY KEY 如何决定分区
章节收尾自测
-- 用一段会话验证你对本章 CL 的理解 CONSISTENCY LOCAL_QUORUM; -- 本地 DC 法定人数:多 DC 低延迟默认 SELECT * FROM app_status WHERE region = 'east' AND ts >= '2024-08-01';
能答出以下三问,即可进入第2章:其一,LOCAL_QUORUM 与 QUORUM 在延迟上的本质区别是什么;其二,vnode 解决了经典一致性哈希的哪个痛点;其三,Read Repair 与 Anti-Entropy Repair 的触发时机有何不同。