2.2 数据复制与一致性级别
2.2 数据复制与一致性级别
本节摘要:NetworkTopologyStrategy 把副本散到 Rack/DC;CL 在每次操作上声明法定人数。异步复制 + Read Repair / Hinted Handoff / Anti-Entropy 构成纵深收敛。对照 HBase 同步 WAL 复制与 Mongo
writeConcern: majority。
核心问题
阅读完本节,你应当能够:
- 写出 NTS keyspace 的 CQL 与
cassandra-rackdc.properties配套 - 计算 R=5 时 QUORUM 所需 ACK 数
- 描述 Read Repair 的影子请求与 timestamp 比对
- 解释
nodetool repair与 Merkle Tree 反熵
一、问题与直觉
「副本数 = 3」不等于「跨机房容灾」。三台 VM 在同一机架,一次断电全灭。复制策略回答「数据该落在哪些故障域」;CL 回答「这次读写要等几个副本点头」。MongoDB 的 replicaSet 跨 region 需手动 tag;HBase 的 Replication 异步且非 CQL 语义——Cassandra 把二者合成 keyspace 级声明。
二、核心原理
SimpleStrategy:单 DC 顺时针取下一个节点——快,但无视 rack(SOURCE 2.2 称「无鞘的刀」)。
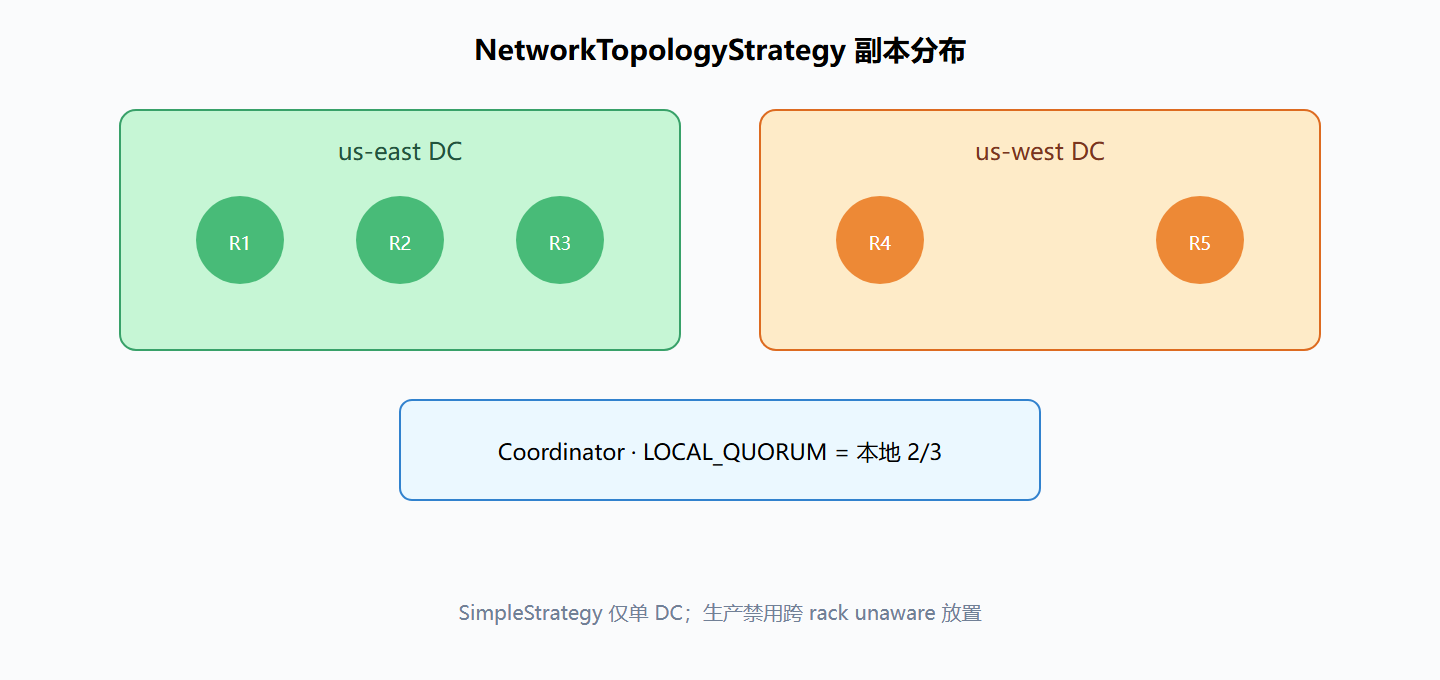
NetworkTopologyStrategy:
# cassandra.yaml endpoint_snitch: GossipingPropertyFileSnitch
# cassandra-rackdc.properties dc=us-east rack=rack1
CREATE KEYSPACE banking WITH replication = { 'class': 'NetworkTopologyStrategy', 'us-east': 3, 'us-west': 2 };
复制是异步 log-based:Coordinator 写本地 CommitLog + MemTable 后即向副本发 Mutation,不必等全部落盘——吞吐高,靠 repair 收敛。
| 机制 | 触发时机 | 作用 |
|---|---|---|
| Read Repair | 读时副本版本不一 | 毫秒级 surgical 修复 |
| Hinted Handoff | 目标节点短暂 down | 缓冲写,恢复后 replay |
| Anti-Entropy | nodetool repair |
Merkle 树比对,小时~天级 |
CL 速查(R=3):ONE=1,QUORUM=2,ALL=3。LOCAL_QUORUM 只在本地 DC 计数——跨 DC 延迟从 RTT 方程里拿掉。
三、工程实践要点
repair 纪律:4.x Incremental Repair 可 weekly 跑;忽略 repair 则 Merkle 差异累积,最终读修复风暴。HBase 依赖 hbck;Mongo 靠 oplog 滚动。
Hint 堆积:max_hints_delivery_threads 与磁盘;长期 down 节点应 removenode 而非无限堆 hint。
WriteTimeout:CL=QUORUM 只收到 1 ACK——数据可能已在 1 副本;客户端重试必须幂等。
⚠️ 常见坑:跨 DC 用
QUORUM而非LOCAL_QUORUM——每次写等远洋副本,P99 爆炸。
💡 关键直觉:复制策略定「数据能在哪」;CL 定「这次操作认哪里算数」——两层旋钮正交。
要点串联
- NTS 是生产默认;SimpleStrategy 仅实验
- 异步复制 换吞吐,收敛靠三层 repair
- LOCAL_QUORUM 是多 DC OLTP 标配
- W+R≥N 仍是 QUORUM 读新鲜度的数学基础
- Mongo majority / HBase 同步 在一致性谱上更靠 C 端
下一节进入 LSM:CommitLog、MemTable、SSTable 与 Compaction 如何承载上述复制语义。
推演:QUORUM 在不同复制因子下的表现
| RF | QUORUM 需 ACK | 容忍故障数 | 读必见写的条件 |
|---|---|---|---|
| 3 | 2 | 1 | W=R=QUORUM 成立 |
| 5 | 3 | 2 | 同上 |
| 1 | 1 | 0 | 单副本无容错 |
| 2 | 2(ceil(2/2)+1=2) | 0 | W=2,R=2 满足 4>2 |
-- 用一致性探针验证:写入后立即读,观察返回版本 CONSISTENCY QUORUM; INSERT INTO cfg (k, v) VALUES ('schema_v', '2024-08-14') IF NOT EXISTS; CONSISTENCY QUORUM; SELECT v FROM cfg WHERE k = 'schema_v';
注意 RF=2 时 QUORUM 需 2 个 ACK,等于 ALL——任何单副本抖动都阻塞写,所以生产很少用 RF=2 配 QUORUM,要么 RF=3,要么写 ONE。
演练:Read Repair 的观测
-- 开启追踪,观察单次读触发了几次副本请求 TRACING ON; SELECT * FROM user_profile WHERE user_id = 'u-7788';
# 跟踪会话结束后,查看 repair 相关的 event # 如果出现 "Repairing inconsistent partitions",说明触发读修复
Read Repair 是「读时即修复」:协调者比对各副本返回的版本,向落后副本异步补写最新值。它只修复被读到的分区,覆盖面有限;配合 Hinted Handoff 处理短窗口、Anti-Entropy 兜底长周期不一致,三层机制各管一段。
一致性故障场景:删除复活
-- tombstone 生命周期与 repair 窗口绑定 DELETE FROM user_profile WHERE user_id = 'u-7788'; -- 若 10 天(gc_grace_seconds 默认 864000s)内没有完成全环 repair, -- tombstone 被清除后,旧副本的残留值会在下次 repair 时"复活"
这就是为什么章节摘要强调「忽略 repair 则 Merkle 差异累积」。生产约定俗成:gc_grace_seconds 必须大于 repair 周期,通常配合 Reaper 每周增量 repair 覆盖所有 token range。
复制策略迁移:从 SimpleStrategy 到 NTS
-- 单 DC 起步后扩展为多 DC,必须迁移复制策略 ALTER KEYSPACE shop WITH replication = { 'class': 'NetworkTopologyStrategy', 'dc-east': 3, 'dc-west': 2 }; -- 迁移后旧 DC 的副本布局立即失效,需重建数据分布
# 迁移完成后逐节点执行 cleanup,清除不再负责的旧副本 nodetool cleanup # 检查每个节点的副本是否按新策略分布 nodetool status
迁移步骤有先后:先改 keyspace 复制策略 → 等待新副本 streaming 完成 → 再对旧节点 cleanup。顺序颠倒会导致临时双份数据或副本缺失。这也是「复制策略是拓扑声明」这句话的运维含义——变更后必须手工触发数据重分布,没有自动魔法。
Hinted Handoff 的容量与清理
# 查看 hint 积压量(正常情况下应为 0 或接近 0) nodetool getendpoints shop orders ord-8842 # 无关,用这个看副本 nodetool tpstats | grep -i hint # Hints 队列持续上涨 = 有节点长期离线,或写路径过载
# cassandra.yaml:控制 hint 生命周期 max_hint_window_in_ms: 10800000 # 3 小时,超过即放弃新 hint hinted_handoff_enabled: true hinted_handoff_throttle_in_kb: 1024
hint 是协调者在副本短暂离线时代存的「欠条」:目标节点恢复后按原 CL 语义回放。它只能覆盖短窗口——超过 max_hint_window 后不再生成新 hint,此时必须走 repair 或接受数据缺口。长期宕机的节点应走 nodetool removenode 移出环,而不是让 hint 无限堆积拖垮协调者的内存与磁盘。
一致性级别与驱动配置
// Java 驱动 4.x:把 CL 写在语句级,而不是全局 SimpleStatement stmt = SimpleStatement.builder( "SELECT * FROM accounts WHERE id = ?") .setConsistencyLevel(DefaultConsistencyLevel.LOCAL_QUORUM) .build();
# Python 驱动同样支持语句级 CL from cassandra.query import SimpleStatement from cassandra import ConsistencyLevel stmt = SimpleStatement("SELECT * FROM accounts WHERE id = %s", consistency_level=ConsistencyLevel.LOCAL_QUORUM)
CL 的最佳实践是随语句声明而非全局固定:核心账务写 LOCAL_QUORUM,旁路审计日志写 ONE,同一连接并存互不干扰。驱动层还支持 speculative retry——首请求慢时提前向另一副本发起探测读,用「多副本抢答」压低 P99,代价是额外负载,需监控触发率。