2.3 存储引擎 Internals
2.3 存储引擎 Internals
本节摘要:Cassandra 存储引擎是 LSM-Tree:CommitLog 保崩溃恢复,MemTable 吸收写,flush 成不可变 SSTable,Compaction 控制读放大。Bloom Filter 过滤无关 SSTable。本节对照 LevelDB/RocksDB 与 HBase HFile,说明 STCS/LCS/TWCS 取舍。
本节地图
阅读完本节,你应当能够:
- 按顺序描述一次 INSERT 的 CommitLog → MemTable → flush 路径
- 解释读路径上 MemTable + 多 SSTable 的 timestamp 归并
- 对比 STCS、LCS、TWCS 的写放大与读放大
- 说明 tombstone 如何影响 Compaction 与
gc_grace_seconds
一、问题与直觉
B+ 树数据库(PostgreSQL 默认)随机写触发页分裂,HDD 时代 IOPS 是瓶颈。Facebook 邮件、IoT 心跳都是写多读少、追加型。LSM 把写变成顺序 append,把读变成「多文件归并 + Bloom 过滤」——Cassandra 与 HBase、RocksDB 同源。MongoDB WiredTiger 也可配 LSM,但默认更偏 B-tree;Cassandra 只有 LSM 一条路,读放大是设计内成本。
二、核心原理
写路径(SOURCE 2.3):
- CommitLog 顺序 append(微秒级 ACK 基础)
- MemTable(ConcurrentSkipListMap,默认 flush 阈值约 128MB)
- Flush → 新 SSTable(
Data.db+Index.db+Statistics.db+ Bloom Filter)
读路径:
- Key Cache(可选)→ Bloom Filter → Index 定位 → MemTable + 候选 SSTable 按 timestamp 降序归并
- 遇 tombstone 则逻辑删除,更早版本忽略
- 协调节点对副本结果再合并,可能触发 Read Repair
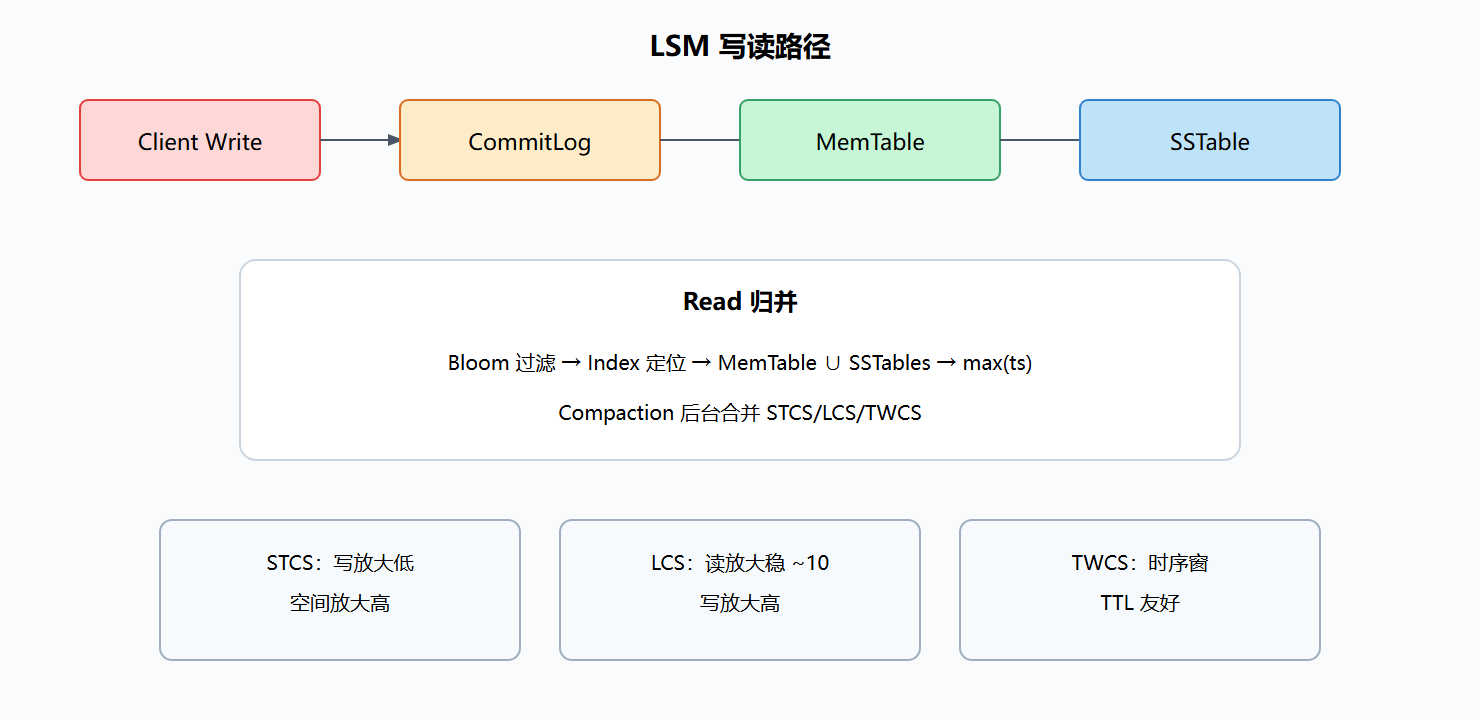
| 策略 | 适用 | 风险 |
|---|---|---|
| STCS(默认) | 写密集 | 读放大波动、磁盘膨胀 |
| LCS | 读延迟敏感 | I/O 重写多 |
| TWCS | 时序 + TTL | 非时间序数据勿用 |
与 HBase:HFile 同为 LSM;Major Compaction 类似 STCS。Cassandra 把策略表级可配,HBase 更依赖 Region 级 major compact 窗口。
三、工程实践要点
tombstone:DELETE 写 tombstone;Compaction 前 tombstone 不可物理删。gc_grace_seconds(默认 864000s)内必须完成 repair,否则删除可能「复活」。
sstableloader / nodetool compact:手动 compact 救急;长期靠策略 + 磁盘预算。
Tracing:cqlsh 里 TRACING ON 可看单次读穿越几层 SSTable——读放大可视化。
⚠️ 常见坑:LCS 配在写-heavy 表上——Compaction 跟不上,L0 文件堆积,读延迟雪崩。
💡 关键直觉:LSM 是「用读与空间换写」——Cassandra 把这一 trade-off 写进每个表的 Compaction 策略。
温故知新
- CommitLog + MemTable + SSTable 是写优化铁三角
- Bloom Filter 挡掉绝大多数无效 SSTable IO
- 读 = 多源 timestamp 归并,点查优于宽范围扫
- STCS/LCS/TWCS 无银弹,看读写比与时序形态
- tombstone + gc_grace 与 repair 强绑定
- HBase HFile / RocksDB 共享 LSM 基因,协调层不同
第3章讨论如何在 CQL 层用 PRIMARY KEY 匹配 LSM 的物理布局。
演练:一次写入的完整生命周期
# 打开系统日志与 trace,跟踪一次 INSERT 的物理过程 cqlsh -e "TRACING ON; INSERT INTO ks.t (id, v) VALUES ('a1', 1)"
预期事件链: 1. WriteStage 接收请求,校验 CL 2. CommitLog 顺序 append(提供崩溃恢复) 3. Mutation 写入 MemTable(ConcurrentSkipListMap 有序结构) 4. 满足 flush 条件后生成 SSTable(Data.db/Index.db/Bloom) 5. 若触发行级修复(hinted handoff / read repair),额外写副本
写放大/读放大/空间放大三者在此交汇:SSTable 越多,读时要归并的文件越多(读放大↑),但 flush 越频繁写放大越大。Compaction 策略就是在三者间选平衡点。
读路径性能分析工具
# 看每次读穿过几个 SSTable nodetool tablestats ks.t # 关键指标:SSTable count、Space used、Live cells # 压缩前先评估收益 nodetool compactionstats
-- 定位「读放大过大」的大表(SSTable 数量过大) SELECT keyspace_name, table_name, sstable_count FROM system.size_estimates WHERE table_name = 't';
若单表 SSTable 上百个且读延迟升高,优先考虑 LCS(读稳定)而非简单增大堆。Bloom Filter 能挡掉大多数无关文件,但过滤本身也消耗 CPU,指标应看「实际读盘次数」而非仅看延迟。
Compaction 策略选择决策树
写吞吐高且读不敏感 ──> STCS(默认,写放大最小) 读延迟敏感、范围读多 ──> LCS(分层,读稳定) 时序数据 + 全表 TTL ──> TWCS(按时间窗口分桶) 无法判断 ──> 先用 STCS,监控读 P99 再迁移
-- 表级迁移 Compaction 策略 ALTER TABLE sensor_events WITH compaction = { 'class': 'TimeWindowCompactionStrategy', 'compaction_window_unit': 'DAYS', 'compaction_window_size': 1 };
迁移策略是热操作,但大表切换后会有一次重写。经验法则是:任何一次策略变更前先做全量 repair 与快照,防止旧文件混入新归档窗口。
故障场景:CommitLog 与 SSTable 的一致性边界
# 极端场景:节点写入后、flush 前崩溃 # 重启时 Cassandra 从 CommitLog 重放,补回内存中丢失的写入 systemctl restart cassandra # 日志中应出现 replaying commitlog 的迹象 grep -i "replay" /var/log/cassandra/system.log
CommitLog 是「写路径的保险丝」:写入先进 CommitLog 再进 MemTable,保证 MemTable 未 flush 的数据在崩溃后不丢。代价是双写磁盘;所以生产强烈建议 CommitLog 与数据分盘,避免相互争抢 I/O。这正是 4.1 部署章节反复强调分盘的原因。
# cassandra.yaml:CommitLog 独立盘 + 同步策略 commitlog_directory: /mnt/cl-log commitlog_sync: periodic commitlog_sync_period_in_ms: 10000
对比 HBase 的 WAL 与 MongoDB 的 oplog/journal,三者的本质一致:先记日志再改结构,用顺序写换取崩溃恢复能力。差异在轮转与清理策略——Cassandra 的 CommitLog 段在对应 MemTable flush 后即可回收,而 oplog 按容量滚动。
Tombstone 实操与陷阱
-- 观察 tombstone 的副作用:查询被大量墓碑拖慢 TRACING ON; SELECT * FROM events WHERE device_id = 'd-1' AND ts > '2024-08-01'; -- trace 中若出现大量 "tombstone" 字样,说明删除历史未清理
# 诊断墓碑问题 nodetool tablestats ks.events | grep -i tombstone # 处理手段:等 gc_grace 到期 + 触发 major compaction nodetool compact ks events
tombstone 是 LSM 的「逻辑删除」:DELETE 不物理删数据,而是写一个带时间戳的墓碑,覆盖旧值。墓碑保留 gc_grace_seconds(默认 10 天),期间 Compaction 必须跳过它,以防其他副本的旧值复活。高频增删的表(如队列、会话)容易堆墓碑,导致读路径扫描大量无效行——经验法则是:频繁 DELETE 的表要监控墓碑数,必要时用 TTL 自动过期替代显式删除。