1.4 适用与不适用的场景
1.4 适用与不适用的场景
本节摘要:ClickHouse 不是万能数据库,把它用对地方能省掉大量自研,用错地方则是灾难。本节用四象限和对比表说清它擅长什么、不擅长什么,给你一个选型判断框架。
阅读收获
阅读完本节,你应当能够:
- 用四象限判断一个场景该不该上 ClickHouse
- 列出 ClickHouse 的三类典型适用场景
- 列出三类典型不适用场景并解释原因
- 在选型时给出明确的"用/不用"理由
一、选型的两个轴
判断一个数据库适不适合某场景,最朴素的方法是看两个维度:写入模式(批量还是高频单行)和查询模式(大范围扫描聚合还是点查)。ClickHouse 的甜区是"批量写 + 大扫描聚合",离这个甜区越远,越不该用它。
图 1-4 ClickHouse 适用场景四象限
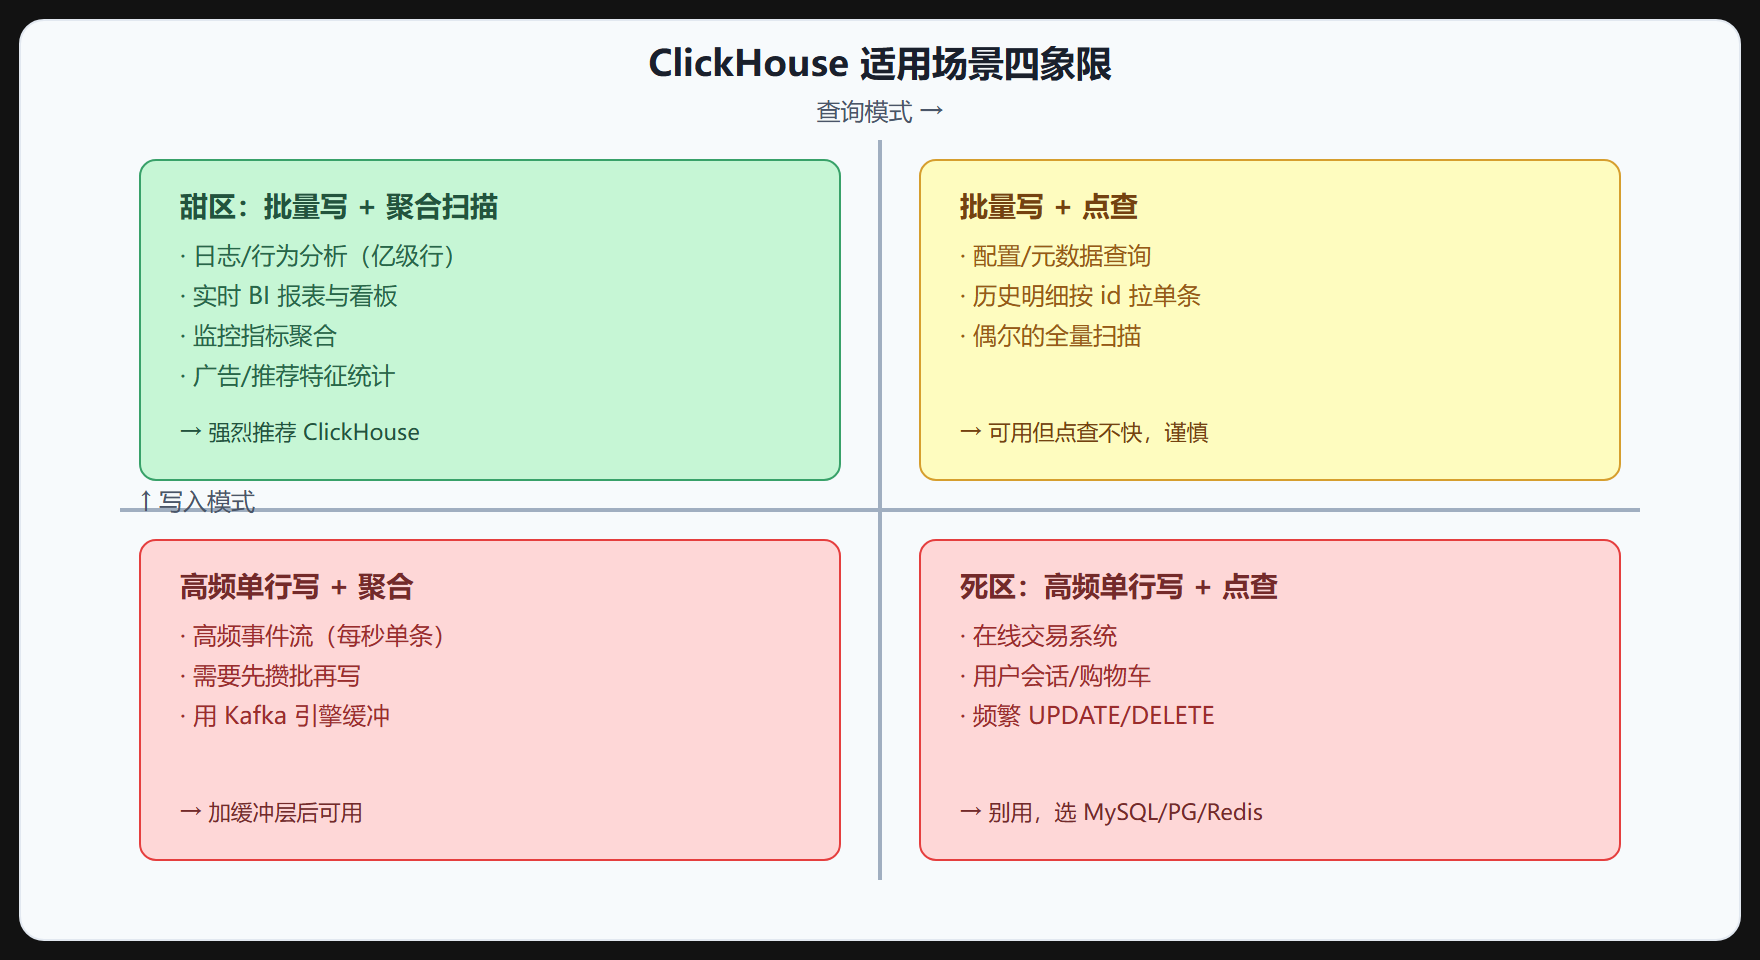
这张图的核心是左上角那个绿框——ClickHouse 的甜区。其他三个象限要么需要加缓冲层改造、要么干脆别用。
二、三类典型适用场景
场景一:日志与行为分析
这是 ClickHouse 最经典的用法。互联网产品的点击流、应用日志、服务器监控指标,每天动辄几十亿行。这些数据写入是批量的(日志收集器攒一批再写),查询是聚合的(按时间、地域、事件类型统计),完全落在甜区。Uber 用它追踪司机轨迹、Cloudflare 用它分析威胁日志,都是这类。
场景二:实时 BI 报表与看板
业务方要看"过去一小时各渠道转化率",这种即席聚合查询在 ClickHouse 上能亚秒级返回。配合 Grafana/Superset 做可视化,就构成了一个实时 BI 系统。相比传统"ETL 到数仓再查"的链路,ClickHouse 把时滞从小时级压到秒级。
场景三:监控指标聚合
Prometheus 这类时序库擅长采集和短期告警,但长期聚合查询成本高。把监控指标从 Prometheus 远程写到 ClickHouse,既省存储(列存压缩),又能做长期趋势分析。很多公司用 ClickHouse 做监控指标的长期存储后端。
三、三类典型不适用场景
不适用一:在线交易系统(OLTP)
交易系统要求强事务、高频单行读写、点查快。ClickHouse 这几项全不沾边:事务弱、单行写慢、点查不如 KV 快。把订单系统塞给它,结果一定是性能和正确性双输。这类场景老老实实用 MySQL/PostgreSQL。
不适用二:频繁 UPDATE/DELETE 的业务
ClickHouse 的 UPDATE/DELETE 本质是异步重写整个 part(叫 mutation),重且慢。一个需要频繁改单行状态的业务(比如订单状态机、用户资料修改)不该用 ClickHouse 存主数据。如果非要存,把"可变状态"放 MySQL、把"不可变明细"放 ClickHouse,是个常见分工。
不适用三:复杂多表 JOIN 的星型模型
ClickHouse 偏爱宽表预聚合,对星型模型那种"事实表 JOIN 多维表"的支持虽然在改进,但性能不如专门的 MPP 引擎(如 Greenplum、Doris 在某些场景)。如果你的分析高度依赖多表关联,要么在入湖时就把维度冗余进事实表(宽表化),要么评估别的引擎。
四、选型对比速查
| 维度 | ClickHouse | MySQL/PG | Doris | Elasticsearch |
|---|---|---|---|---|
| 列存聚合 | 极强 | 弱 | 强 | 中 |
| 写入吞吐 | 批量极高 | 中 | 高 | 中 |
| 点查 | 中 | 强 | 中 | 强 |
| 事务 | 弱 | 强 | 弱 | 弱 |
| 全文检索 | 弱 | 弱 | 中 | 极强 |
| 运维复杂度 | 中高 | 低 | 中 | 中高 |
⚠️ 常见坑:很多人被"ClickHouse 快"吸引,把本该用 Elasticsearch 的全文检索场景、本该用 MySQL 的事务场景都塞给它,结果两边都不讨好。选型时先问自己:我的写入是批量还是单行?我的查询是聚合还是点查?落在甜区才上。
💡 关键直觉:ClickHouse 是"专精"型选手,不是"全能"型。它的价值在于把"海量数据 + 实时聚合"这一件事做到极致,代价是放弃了很多别的能力。选型时认清自己的核心需求,别让一个工具扛所有活。
重点提炼
- 选型两轴:写入模式(批量/单行)× 查询模式(聚合/点查),甜区是"批量写 + 聚合扫描"。
- 三类适用:日志行为分析、实时 BI 看板、监控指标长期聚合。
- 三类不适用:OLTP 交易、频繁单行更新删除、复杂多表 JOIN 星型模型。
- 可改造区:高频单行写可加 Kafka 缓冲层后用 ClickHouse。
- 选型先问"我的写入和查询落在哪个象限",落在甜区才上。
第 1 章到这里结束。你已经把 ClickHouse 跑通、知道它为什么快、看清它的能力边界和适用场景。下一章我们钻进它的内部:进程模型、列存结构、后台合并,看它肚子里到底怎么转的。
用几个命令快速验证场景适配度
选型之前,与其拍脑袋,不如先用数据说话。判断一个场景适不适合 ClickHouse,可以先问三个问题:数据量多大、写入是批量还是单行、查询是聚合还是点查。
如果你的数据是"批量写 + 聚合查",可以先做一次小规模验证。拉一个临时表,灌入一周的真实数据子集,跑业务最重的那句聚合,看耗时和内存:
-- 创建临时验证表 CREATE TABLE probe_table ( event_time DateTime, user_id UInt64, city String, amount Float64 ) ENGINE = MergeTree PARTITION BY toYYYYMMDD(event_time) ORDER BY (event_time, user_id); -- 灌入采样数据后,跑业务里最重的聚合 SELECT city, uniq(user_id) AS uv, sum(amount) AS amt FROM probe_table WHERE event_time >= '2024-06-01' GROUP BY city; -- 查看这条验证查询的耗时与资源占用 SELECT query_duration_ms, read_rows, memory_usage FROM system.query_log ORDER BY event_time DESC LIMIT 1;
system.query_log 会告诉你这句查询扫了多少行、耗时多少毫秒、占了多少内存。把这几个数字和业务 SLA 对比——如果亚秒级返回、内存占用可接受,这个场景就值得投入;如果扫描行数巨大且无法用分区、索引收窄,就要重新评估了。
另一个实用的验证方向是写入侧。如果写入源是 Kafka 这类消息中间件,天然是批量消费,ClickHouse 几乎总是合适的选择;如果是应用直连高频小批量写,就需要在前面加一层缓冲(Kafka 或 Buffer 表)。判断清楚这两点,选型就不会翻车。