1.3 核心技术特性全景
1.3 核心技术特性全景
本节摘要:本节把 ClickHouse 的核心能力摆成一张全景图,从存储、执行、索引、分布式、SQL 支持到生态集成,让你对它"能做什么"有个整体印象,也为后面各章埋下入口。
你能学到什么
阅读完本节,你应当能够:
- 列出 ClickHouse 的六大类核心特性
- 说清每个特性解决什么问题、对应哪一章
- 区分"它原生支持的"和"靠生态补足的"
- 在选型时知道哪些能力是 ClickHouse 的强项
一、为什么需要一张全景
上一节讲了它为什么快,但"快"只是 ClickHouse 的一部分。一个能在生产里跑的 OLAP 系统,还得有压缩、索引、分布式、SQL、安全、生态这一整套。如果只盯着"查询快"就上 ClickHouse,多半会在运维和集成阶段踩坑。本节把能力分类摆开,让你心里有张地图,知道每个能力对应后面哪一章。
二、六大类核心特性
图 1-3 ClickHouse 核心特性矩阵
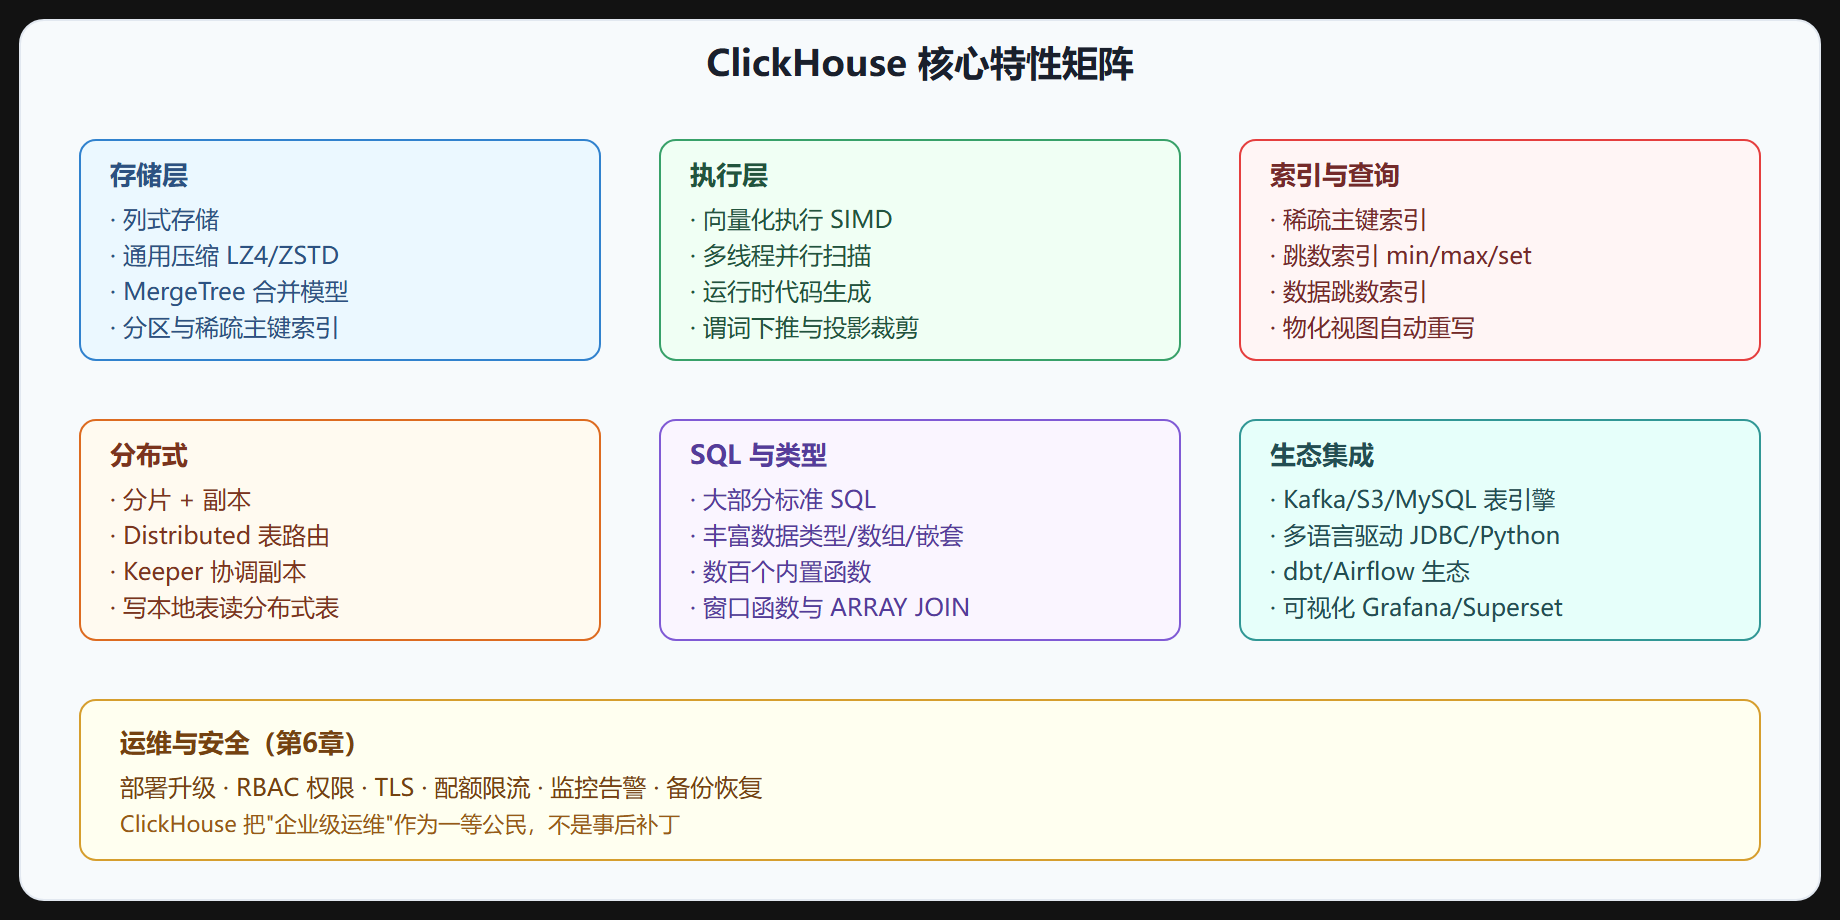
下面逐类展开,每类对应后面一章。
存储层(第 2、3 章)
列式存储 + 通用压缩是 ClickHouse 的地基。它支持 LZ4(快)和 ZSTD(压得狠)两种压缩,列存让压缩比天然就高。MergeTree 合并模型把"写入追加、后台合并"这套机制做成了引擎家族,衍生出 ReplacingMergeTree、SummingMergeTree 等针对不同语义的变体。分区让数据按时间或业务维度切块,稀疏主键索引让查询能跳过无关块。
执行层(第 4 章)
向量化执行是 ClickHouse 性能的核心。它把算子改成"一次处理一批同类型数据",配合 CPU 的 SIMD 指令把吞吐拉满。查询是多线程并行的,一个查询能吃满多核。运行时代码生成会把部分查询编译成机器码,减少解释开销。优化器会做谓词下推(把过滤推到扫描层)、投影裁剪(只读用到的列)。
索引与查询(第 3、4 章)
稀疏主键索引是默认的,按 ORDER BY 排序后每 8192 行一条索引项。除此之外还有跳数索引(skip index),针对非主键列做二级过滤,比如 minmax、set、bloom_filter 几种类型。物化视图是 ClickHouse 的一个亮点:它能自动把对源表的查询重写到物化视图上,让分析既灵活又快。
分布式(第 5 章)
ClickHouse 的分布式是"分片 + 副本"模型。分片把数据水平切分到多个节点,副本给每个分片做冗余。Distributed 表是一个路由层,查询它会把请求下发到各分片的本地表再合并结果。副本一致性靠 ZooKeeper 或 ClickHouse Keeper(官方自研的替代品)协调。这套模型偏"松散耦合",不追求跨节点强事务,而是各分片自治。
SQL 与类型(第 3、4 章)
ClickHouse 支持大部分标准 SQL,但有些方言和 MySQL/PostgreSQL 不同(比如 count() 而非 COUNT(*) 的写法都行,但 join 语义有差异)。它的数据类型很丰富:除了常规类型,还有 Array、Tuple、Nested、Map、LowCardinality、UUID、各种日期类型。内置函数有数百个,从字符串处理到地理编码都有。窗口函数和 ARRAY JOIN 让它能做复杂事件处理。
生态集成(第 7 章)
ClickHouse 不孤立。它有 Kafka 表引擎直接消费消息流、S3 表引擎读冷数据、MySQL/PostgreSQL 表函数做联邦查询。驱动覆盖主流语言。可视化能接 Grafana、Superset。dbt 也有 ClickHouse 插件,能做转换编排。
三、特性对照速查
| 你想做的事 | 用 ClickHouse 的什么 | 详见 |
|---|---|---|
| 按天存日志、按天裁剪查询 | 分区 PARTITION BY toYYYYMMDD |
第 3 章 |
| 同主键只留最新版本 | ReplacingMergeTree | 第 3 章 |
| 按维度自动求和 | SummingMergeTree | 第 3 章 |
| 跳过非主键列的无关数据 | 跳数索引 skip index | 第 3 章 |
| 让聚合查询自动走预聚合 | 物化视图 | 第 4 章 |
| 水平扩容 | 分片 + Distributed 表 | 第 5 章 |
| 副本高可用 | ReplicatedMergeTree + Keeper | 第 5 章 |
| 消费 Kafka | Kafka 表引擎 | 第 7 章 |
| 控制用户资源 | RBAC + 配额 Quota | 第 6 章 |
💡 关键直觉:这张全景图不是要你背下来,而是让你在遇到具体问题时,知道该往哪一章找。ClickHouse 的能力是成体系的,单独用某一项往往效果一般,组合起来才显出威力。
本节速览
- 六大类特性:存储、执行、索引查询、分布式、SQL 类型、生态集成,外加运维安全。
- 存储层:列存 + LZ4/ZSTD 压缩 + MergeTree 合并模型 + 分区稀疏索引。
- 执行层:向量化 SIMD + 多线程并行 + 运行时代码生成 + 谓词下推投影裁剪。
- 分布式:分片 + 副本 + Distributed 路由 + Keeper 协调,松散耦合不追求强事务。
- 生态:Kafka/S3/MySQL 表引擎 + 多语言驱动 + Grafana/Superset/dbt。
- 每类特性都对应后面一章,遇到问题按这张图定位章节。
下一节用四象限和对比表说清这些特性该用在哪些场景、不该用在哪些场景,帮你做选型判断。
用一张建表语句串起六大特性
前面把特性分类讲了一遍,这里把它们串起来看。下面这条建表语句虽然不长,却同时用到了存储层、索引层、类型系统、TTL 等多类特性:
CREATE TABLE event_logs ( event_time DateTime, user_id UInt64, event_type LowCardinality(String), amount Decimal(18, 2), INDEX idx_type event_type TYPE set(100) GRANULARITY 4 ) ENGINE = MergeTree PARTITION BY toYYYYMMDD(event_time) -- 存储层:按天分区 ORDER BY (event_time, user_id) -- 存储层:排序键兼主键 TTL event_time + INTERVAL 90 DAY -- 运维层:过期自动清理 SETTINGS index_granularity = 8192; -- 存储层:granule 粒度
一行行拆解:PARTITION BY 决定分区裁剪的粒度,ORDER BY 决定稀疏主键索引能否命中,TTL 让过期数据自动清理,INDEX 给非主键列加跳数索引,LowCardinality(String) 和 Decimal(18,2) 是类型系统里的省空间利器。这些能力在后面的章节会逐个展开,现在你只要知道:一张表的设计,本质上就是把各类特性按业务需求组合起来。
查询侧也一样,一条 SQL 可以同时触发多个执行层特性:
SELECT event_type, count() AS cnt, round(avg(amount), 2) AS avg_amount FROM event_logs WHERE event_time >= now() - INTERVAL 7 DAY GROUP BY event_type ORDER BY cnt DESC LIMIT 10;
这段查询能跑得快,依赖的是投影裁剪(只读三列)、分区裁剪(只扫最近 7 天)、向量化执行(按列批量算)、多线程并行(多核同时扫描)。每个特性单独看都很简单,组合起来就是"海量数据 + 实时聚合"的完整答案。