2.1 进程与线程模型
2.1 进程与线程模型
本节摘要:ClickHouse 服务端是单进程多线程架构,一个查询会被拆成多个并行扫描任务扔进线程池。理解这个模型,才能调对
max_threads、解释"为什么一个查询能吃满 32 核"。
核心问题
阅读完本节,你应当能够:
- 说清 ClickHouse 服务端的进程组成
- 描述一个查询从接收到执行完成的线程流转
- 解释
max_threads的作用和默认值来源 - 理解为什么 ClickHouse 不需要传统连接池
一、服务端是什么进程
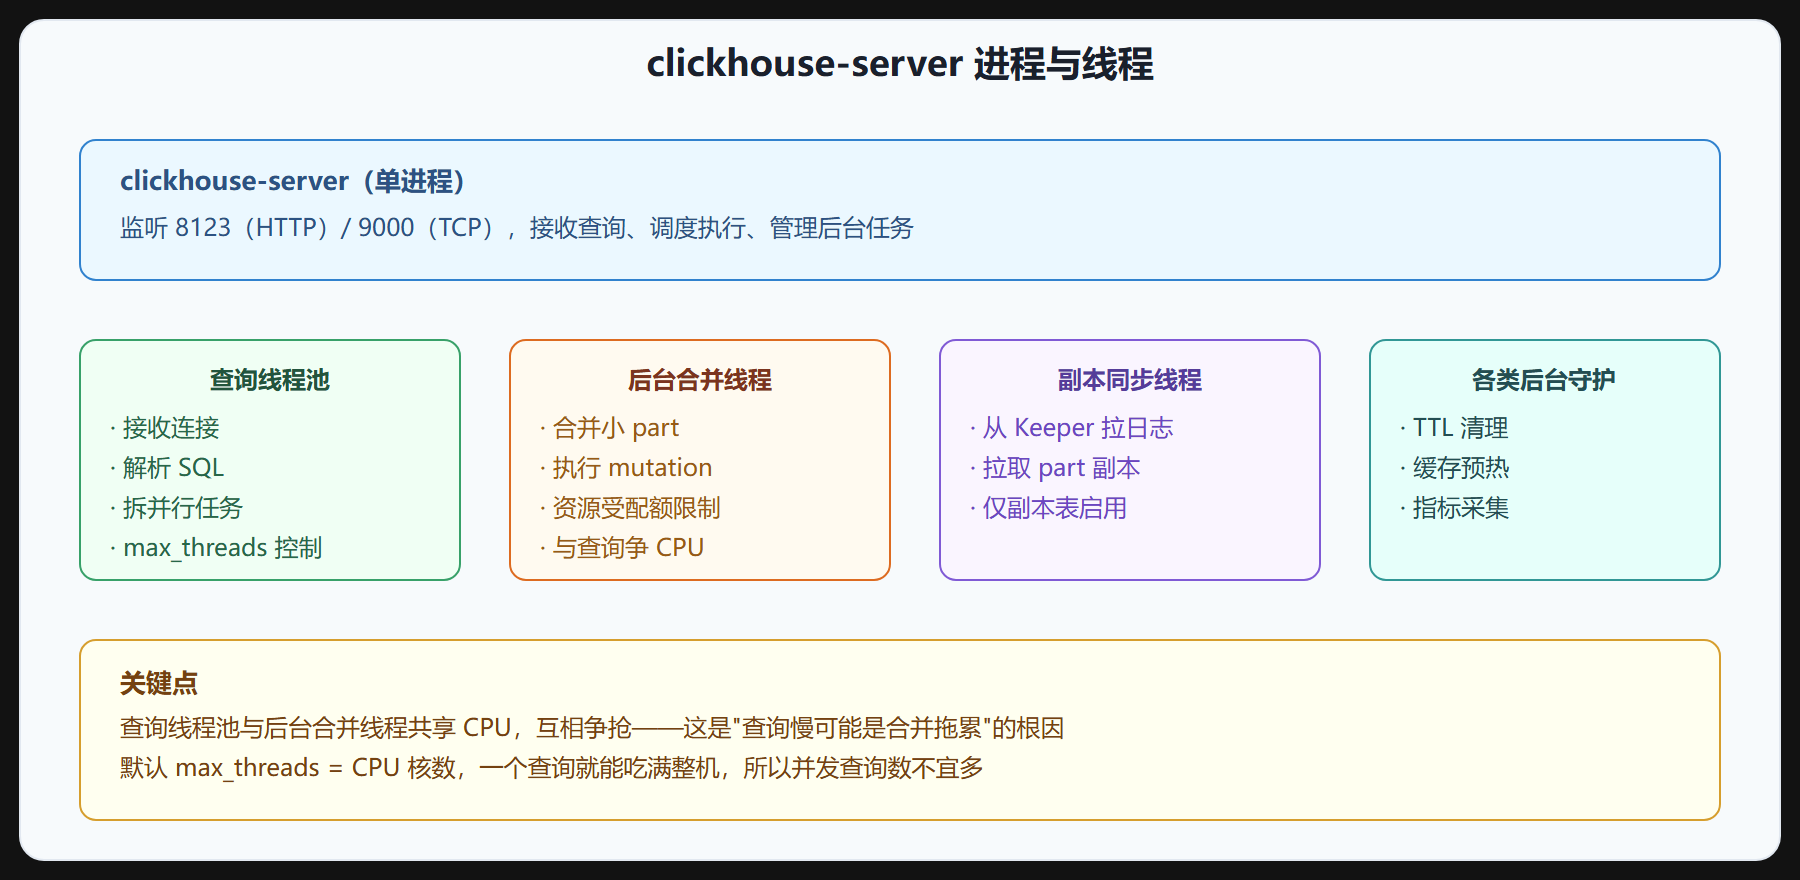
ClickHouse 服务端就是一个 clickhouse-server 进程(也常以 clickhouse-keeper 单独跑协调服务,但那是另一个角色)。它不像 MySQL 那样一个连接起一个线程——ClickHouse 的设计假设是"少量并发查询,每个查询吃满多核",所以它走的是线程池模型,而不是每连接每线程。
图 2-1 ClickHouse 进程与线程模型
二、一个查询的线程流转
当你发一句 SELECT ... GROUP BY 到 ClickHouse,大致经过这几步:
- 接收与解析:监听线程接到请求,解析 SQL 生成执行计划。
- 拆并行:根据
max_threads把扫描任务切成多份,每份交给一个工作线程。 - 并行扫描:多个工作线程同时扫描不同 granule,各自做局部聚合。
- 合并结果:各线程的局部聚合结果汇总到主线程做最终聚合,返回客户端。
关键在于第 3 步的并行扫描——这是 ClickHouse 能"一个查询吃满多核"的原因。它把数据按 granule 切分,每个工作线程处理一部分,最后合并。这跟 MySQL 一个查询基本只用一个线程形成鲜明对比。
三、max_threads 怎么定
max_threads 控制单个查询最多用多少线程,默认值是机器 CPU 核数。这意味着默认配置下,一个重查询就能把整机 CPU 吃满。这是 ClickHouse 的设计假设:它认为你不会同时跑很多查询,而是让每个查询尽量快。
这个假设带来一个直接后果:并发查询数不宜多。如果你在一台 32 核机器上同时跑 4 个重查询,每个默认想用 32 线程,结果就是 128 个线程抢 32 个核,上下文切换开销巨大,反而更慢。生产里通常的做法是:
- 给重分析查询设较小的并发数,让单个查询快
- 给交互式看板查询设配额,限制同时跑的数量
- 用
max_memory_usage和 Quota 防止某个查询把资源吃光
| 场景 | 建议 max_threads |
|---|---|
| 单人即席分析(要快) | 默认(核数) |
| 多人共用看板 | 降到核数的一半或更少 |
| 批处理 ETL | 单独时段,可用默认 |
| 高并发小查询 | 限制并发数比降线程更有效 |
⚠️ 常见坑:很多人把 ClickHouse 当 MySQL 用,开几百个连接同时查,结果整机被拖垮。ClickHouse 的并发模型是"少而精",不是"多而杂"。高并发场景要用连接池 + 查询排队 + 配额来控制。
四、为什么不需要传统连接池
传统数据库每个连接占一个线程,连接多了线程开销大,所以要连接池复用线程。ClickHouse 不一样:连接本身很轻,重的是查询执行。一个查询会被拆成多个线程并行跑,连接数和线程数不是 1:1 的关系。
所以 ClickHouse 的"池"不是连接池,而是查询执行线程池。你要控制的不是连接数,而是同时执行的查询数。这也是为什么官方推荐用连接池但要把并发查询数压低——连接可以多开,但同时跑的查询要少。
💡 关键直觉:在 ClickHouse 里,瓶颈不是"连了多少连接",而是"同时在跑几个重查询"。调优的方向是限制并发查询数、让每个查询吃够线程,而不是堆连接数。
要点串联
- 单进程多线程:
clickhouse-server一个进程,查询靠线程池并行扫描,不是每连接每线程。 - 查询四步:接收解析 → 拆并行 → 并行扫描局部聚合 → 合并结果返回。
max_threads:默认等于 CPU 核数,一个查询能吃满整机,所以并发查询数要少。- 三类线程:查询线程池、后台合并线程、副本同步线程,共享 CPU 互相争抢。
- 不需要传统连接池:连接轻、查询重,要控制的是同时执行的查询数而非连接数。
下一节我们看这些线程扫描的数据在磁盘上长什么样——列式存储的物理布局。
用 system 表观察线程与资源
前面的理论对应着可观测的指标。ClickHouse 把线程池的状态暴露在 system.threads 和 system.processes 里,排查"并发查询互相抢资源"这类问题时会非常有用:
-- 当前正在执行的查询 SELECT query_id, user, elapsed, read_rows, memory_usage, query FROM system.processes ORDER BY memory_usage DESC; -- 当前所有线程:区分查询线程、后台合并线程 SELECT thread_name, os_thread_id, thread_id FROM system.threads LIMIT 20;
system.processes 相当于"正在跑的查询快照"。当机器 CPU 飙高时,先看这里有多少查询同时在跑、各自占多少内存,再结合 system.query_log 判断是查询量太大,还是某个查询吃光了资源。如果同时跑的查询数远超核数,就说明并发控制没做好,需要降并发或加排队。
线程数控制上,max_threads 是按查询设置的,另一个相关的全局设置是 max_concurrent_queries,限制整个实例同时允许的查询数。两者配合,才能实现"每个查询吃够线程、同时又不互相争抢":
-- 限制单个查询最多用 8 个线程 SET max_threads = 8; -- 限制实例同时最多跑 10 个查询 SET max_concurrent_queries = 10;
这两行设置在生产里很常见:交互式看板查询量不大时,可以让单个查询用满线程快速返回;批量分析任务多时,则限制并发数防止互相拖累。理解了线程模型,这些参数就不再是魔法数字。