2.2 列式存储结构详解
2.2 列式存储结构详解
本节摘要:本节拆开 MergeTree 表在磁盘上的物理布局:分区之下是 part,part 之内每列一组文件(数据、标记、索引),granule 是最小扫描单位。理解这套布局,才能解释查询为什么能跳过 99% 的数据。
本节地图
阅读完本节,你应当能够:
- 画出 MergeTree 数据从分区到列文件的层级结构
- 说清 granule、mark、index 三者的关系
- 解释稀疏主键索引怎么定位到具体 granule
- 看懂一个 part 目录里各文件的作用
一、从分区到列文件
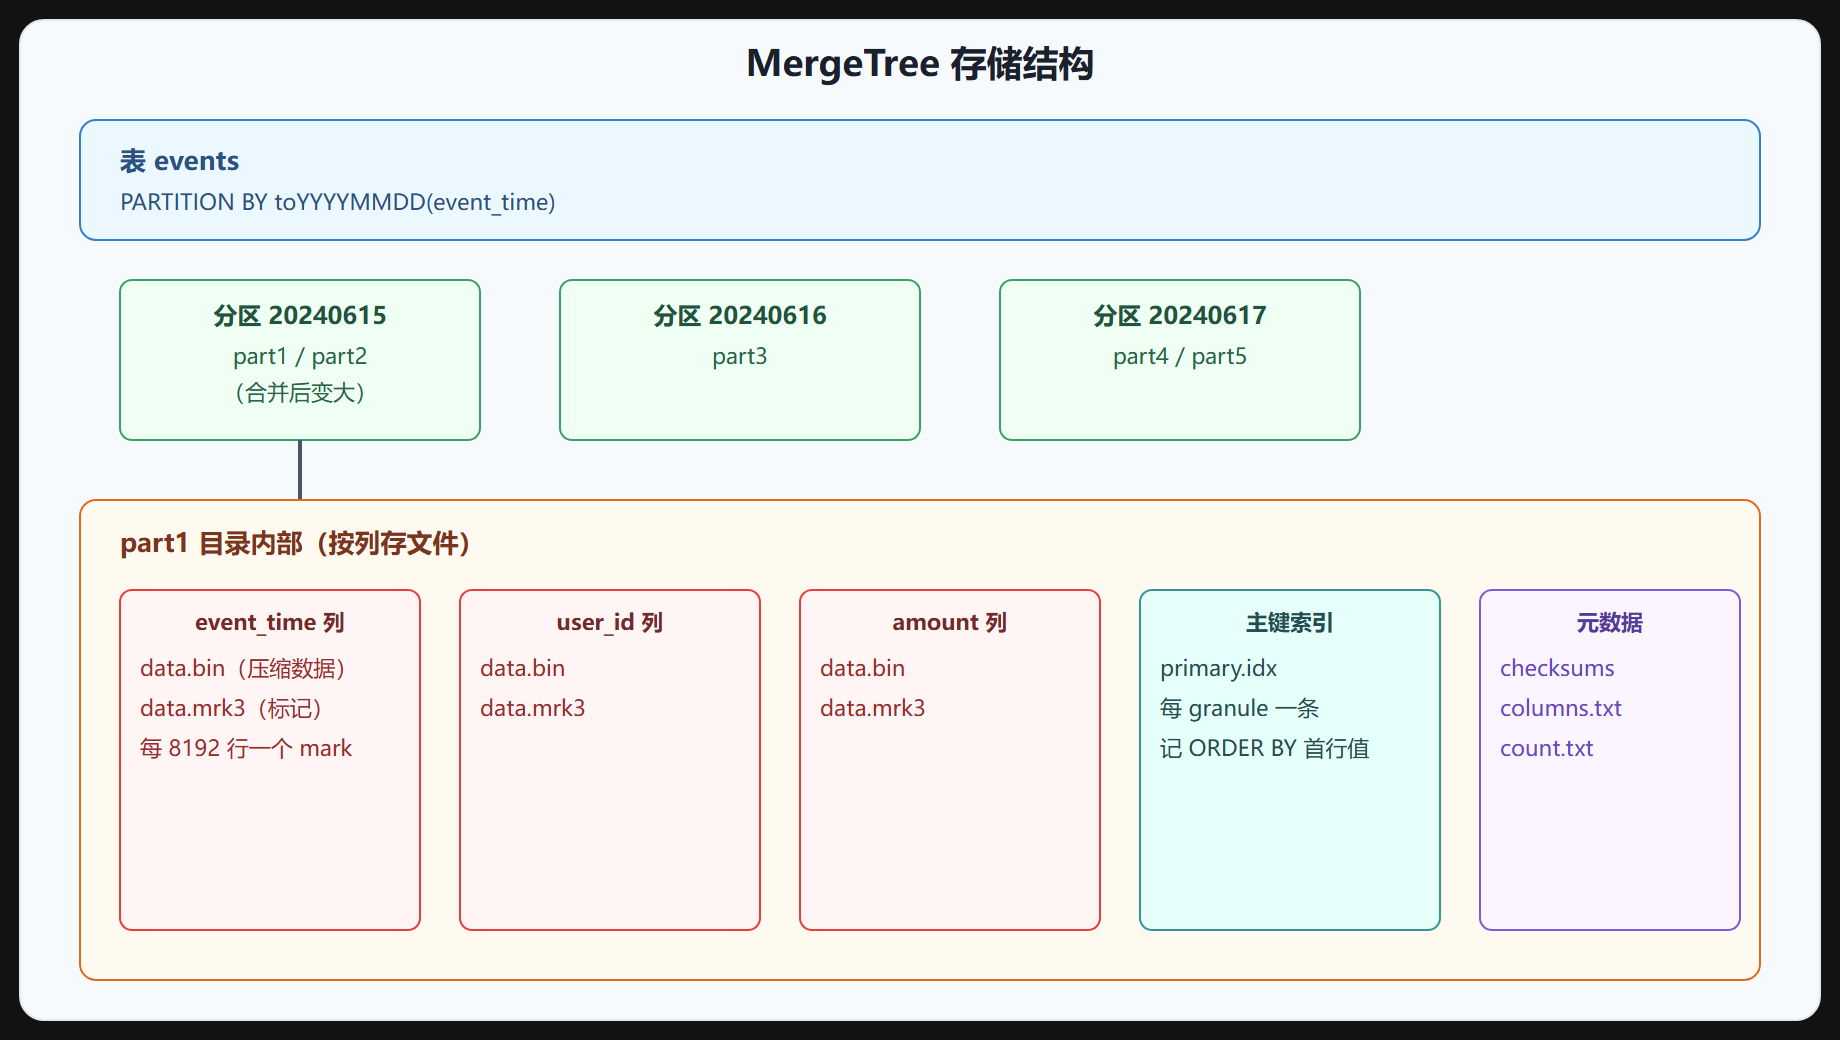
MergeTree 表的数据在磁盘上是分层组织的。最外层是分区(partition),按 PARTITION BY 切开,比如按天分区就有每天的分区。每个分区里有一个或多个 part,part 是写入的基本单位——每次 INSERT 产生一个 part。part 内部按列存储,每一列对应一组文件。
图 2-2 MergeTree 存储结构层级
二、granule:最小扫描单位
MergeTree 把每个 part 的数据按行切成 granule,默认一个 granule 8192 行。granule 是查询扫描的最小单位——要么整个 granule 扫,要么整个 granule 跳过,没有"扫半个 granule"。
为什么是 8192?这是权衡的结果:太小了主键索引条目太多、索引膨胀;太大了稀疏索引的跳过粒度太粗、跳过收益下降。8192 是个在"索引大小"和"跳过粒度"之间取的折中,可以通过 index_granularity 参数改,但一般不用动。
每个 granule 在主键索引里对应一条记录,这条记录存的是这个 granule 第一行在 ORDER BY 列上的值。查询时,ClickHouse 拿查询条件跟主键索引比对,找出哪些 granule 可能含目标数据,其余的直接跳过。
三、mark 文件:列与索引的桥梁
光有主键索引还不够。主键索引告诉你"第 N 个 granule 可能含数据",但这个 granule 在某列的 data.bin 里具体从哪个字节开始?这就是 mark 文件(data.mrk3)的作用。
每个 granule 在每列都有一个 mark,mark 记录的是这列 data.bin 里这个 granule 起始数据的偏移量(包括压缩块偏移和解压后的偏移)。这样查询时:先查主键索引定位 granule 编号 → 用 granule 编号查这列的 mark 文件拿到数据偏移 → 直接跳到 data.bin 对应位置读取。整个过程不需要扫整列。
四、压缩块
data.bin 不是一整块裸数据,它内部又按压缩块组织。默认每压缩块大约 1MB(压缩前),每个压缩块独立压缩。这样读取时可以只解压命中的压缩块,不用解压整个列文件。mark 文件里其实记的是压缩块偏移 + 块内偏移两层,才能精确跳到某个 granule。
| 文件 | 作用 | 粒度 |
|---|---|---|
primary.idx |
主键索引,记每个 granule 首行的 ORDER BY 值 | 每 granule 一条 |
<col>.data.bin |
列的压缩数据 | 按压缩块(~1MB) |
<col>.data.mrk3 |
标记文件,granule 到数据偏移的映射 | 每 granule 一条 |
count.txt |
part 总行数 | 整 part |
columns.txt |
列名与类型 | 整 part |
checksums |
各文件校验和 | 整 part |
💡 关键直觉:granule 是逻辑单位(8192 行),mark 是逻辑到物理的桥梁,压缩块是物理单位。三者配合让 ClickHouse 能"先在内存里查小索引,再精确跳到磁盘上读一小段",这是它扫描快的底层机制。
五、分区裁剪与 part 选择
查询进来时,ClickHouse 先用分区键做第一层裁剪:WHERE event_time >= '2024-06-16' 会直接排除 20240615 及更早的分区,那些分区的 part 根本不打开。然后对保留下来的 part,用主键索引做第二层裁剪,跳过无关 granule。这两层裁剪叠加,就是"跳过 99% 数据"的来源。
⚠️ 常见坑:分区键和主键前缀要选查询最常过滤的列。如果查询从不按
event_time过滤,按天分区就毫无裁剪收益,反而增加 part 数量拖累合并。分区和主键是为查询模式服务的,不是为"看起来整齐"。
温故知新
- 层级结构:表 → 分区 → part → 列文件组(data.bin + data.mrk3)+ primary.idx + 元数据。
- granule:默认 8192 行,最小扫描单位,要么全扫要么全跳。
- primary.idx:稀疏主键索引,每 granule 一条,记 ORDER BY 首行值,常驻内存。
- mark 文件:granule 到列数据偏移的映射,让查询能精确跳到磁盘位置。
- 两层裁剪:分区裁剪(排除整个分区)+ 主键裁剪(跳过无关 granule),叠加出"跳过 99%"。
- 分区和主键要按查询模式选,否则裁剪失效。
下一节看这些 part 是怎么从写入的小 part 合并成大 part 的,以及 mutation 怎么异步重写。
用 SQL 直接查看磁盘布局
前面讲了布局理论,ClickHouse 允许你用 SQL 直接查看表的物理状态,让抽象的结构变得可见。system.parts 表展示每个 part 的信息:
SELECT table, partition, part_name, -- 例如 20240616_1_3_1,含义是"分区_最小块_最大块_层级" rows, bytes_on_disk, active FROM system.parts WHERE database = 'default' AND table = 'events' ORDER BY part_name;
part_name 里的 20240616_1_3_1 是 ClickHouse 命名 part 的规则:第一个字段是分区,后面是块编号区间和合并层级。看到 active = 1 的 part 数量在写入后上升、合并后下降,就是磁盘布局在动态变化的直接证据。
更进一步,可以用 system.columns 看每列的定义,配合数据量评估列存压缩效果:
SELECT name, type, default_kind FROM system.columns WHERE database = 'default' AND table = 'events' ORDER BY position;
列存的另一个可观测点是压缩。同类型数据聚在一起后,Float64 列和 LowCardinality(String) 列的压缩比往往远高于混排的行存。你可以在建表前后对比同一批数据在 system.parts.bytes_on_disk 上的差异,感受"类型一致 → 压缩率高"这条链路。理解了物理布局,你就能解释为什么两张逻辑结构相似的表,磁盘占用和查询速度可能差出数倍。