2.3 后台任务与合并机制
2.3 后台任务与合并机制
本节摘要:写入产生小 part,后台合并把它们变成大 part;mutation 异步重写整个 part 来实现更新删除。理解合并和 mutation 的触发与代价,才能解释"为什么磁盘占用会突然涨"、"为什么 UPDATE 那么慢"。
上手前先明确
阅读完本节,你应当能够:
- 说清 part 从写入到合并的生命周期
- 解释合并的触发条件和资源限制
- 描述 mutation 的执行机制和代价
- 排查"part 太多"、"合并跟不上"类问题
一、part 的生命周期
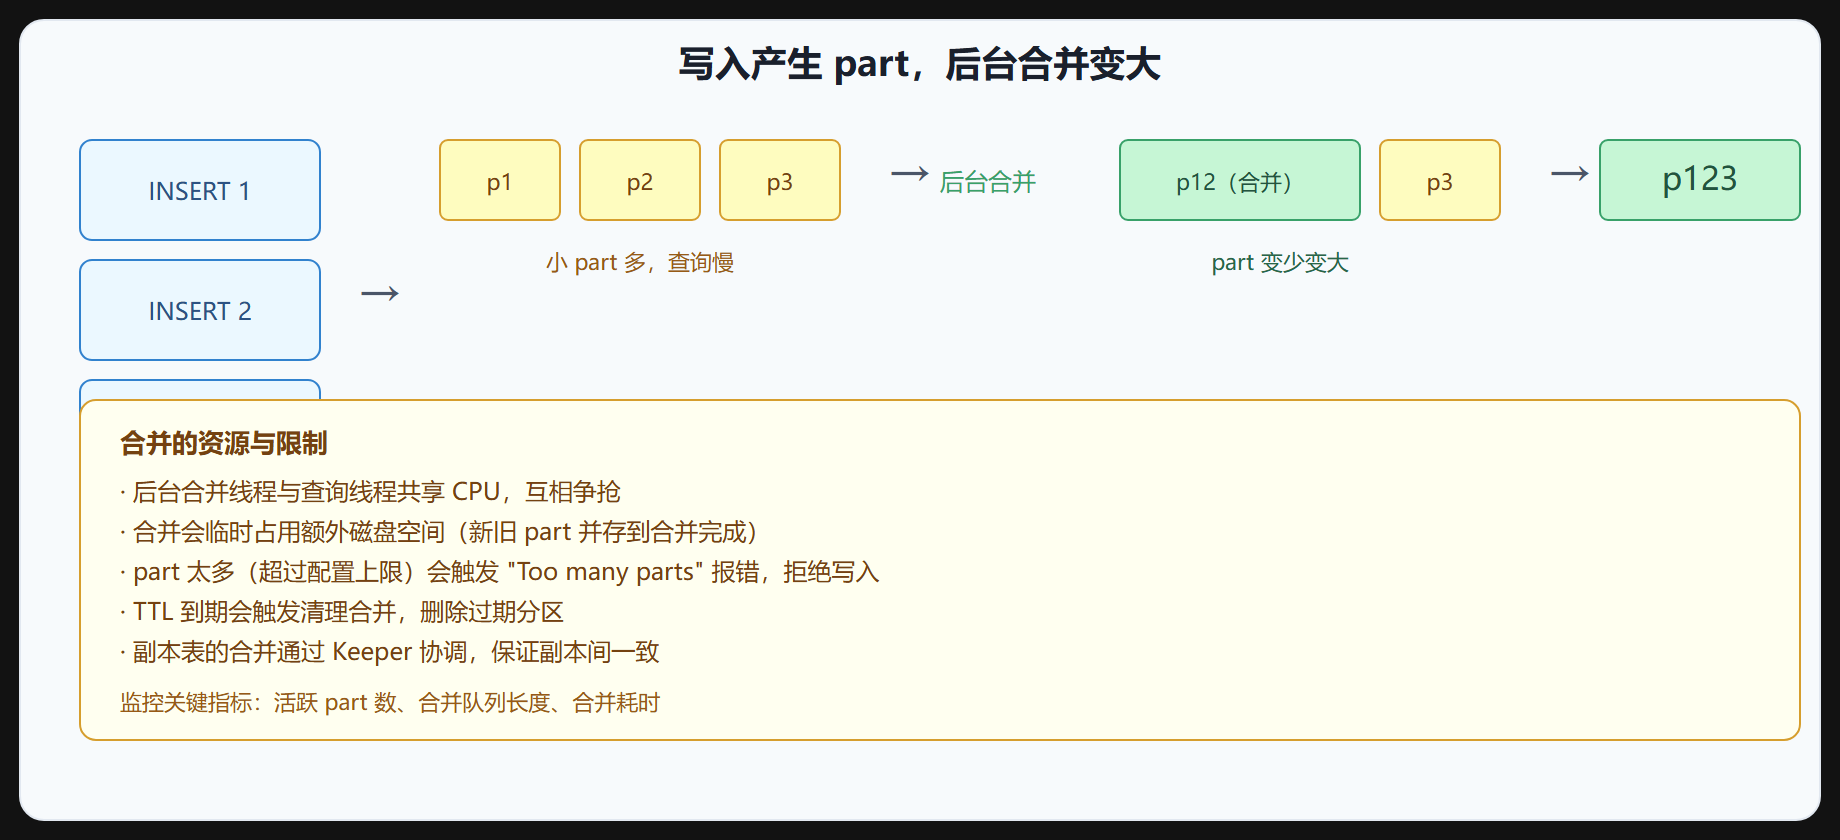
每次 INSERT 产生一个新 part。MergeTree 表刚写入时 part 又小又多,查询要扫很多小 part 效率低。后台合并线程会不断把相邻的小 part 合并成大 part,直到 part 达到配置的上限(默认约 150GB)。这是个持续的过程:写入不停、合并不停。
图 2-3 写入与后台合并流程
二、合并怎么触发
合并不是定时跑的,而是有触发条件。当一个分区里的 part 数量达到一定阈值,或者小 part 积累到一定体积,后台合并线程就会挑一批 part 合并。合并策略有多种(如 MIN、MAX、TTL),默认是按大小渐进合并:先合小 part,再合中 part,最后合大 part,避免一次性合并太多。
合并的代价主要在三处:
- CPU:合并要读旧 part、解压、按 ORDER BY 重新排序、再压缩写新 part,CPU 开销不小。
- 磁盘空间:合并期间新旧 part 并存,磁盘占用会临时上涨,合并完旧 part 被删才回落。
- IO:大量读写,和查询争 IO 带宽。
| 合并阶段 | 典型 part 大小 | 频率 | 代价 |
|---|---|---|---|
| 小→中 | KB~MB | 高 | 低,频繁 |
| 中→大 | MB~GB | 中 | 中 |
| 大→更大 | GB~百GB | 低 | 高,耗时长 |
三、mutation:异步重写
UPDATE 和 DELETE 在 ClickHouse 里叫 mutation,机制和传统数据库完全不同。它不是原地改某几行,而是把整个 part 重写成新版本(只改受影响行)。mutation 是异步的:发完 ALTER TABLE ... UPDATE 语句后,系统登记一个 mutation 任务,后台慢慢执行,执行期间数据处于"部分改部分没改"的中间态。
ALTER TABLE events UPDATE amount = amount * 1.1 WHERE city = '北京';
这句不会立刻生效,而是登记一个 mutation。你可以用 system.mutations 表查看进度:
SELECT database, table, command, is_done, parts_to_do FROM system.mutations WHERE is_done = 0;
mutation 的代价很重:它要重写整个 part,对大表来说可能要几十分钟甚至几小时,期间还要占大量 IO 和 CPU。所以 ClickHouse 的设计哲学是"尽量别频繁改数据"——把可变状态放别处,ClickHouse 只存不可变明细。
⚠️ 常见坑:有人拿 ClickHouse 当 MySQL,频繁
UPDATE改状态字段,结果 mutation 堆积、磁盘暴涨、查询变慢。如果业务必须频繁改,要么用 ReplacingMergeTree 的"插入新版本"模式代替 UPDATE,要么把状态字段拆到 MySQL。
四、几个典型问题与排查
| 现象 | 可能原因 | 排查 |
|---|---|---|
写入报 Too many parts |
合并跟不上写入,part 堆积 | 查 system.parts 活跃 part 数,降写入频率或加合并资源 |
| 磁盘占用突然涨 | 大合并进行中,新旧 part 并存 | 查 system.merges,等合并完会回落 |
UPDATE 一直没生效 |
mutation 在排队或执行慢 | 查 system.mutations 的 is_done 和 parts_to_do |
| 查询变慢且 CPU 高 | 后台合并和查询争 CPU | 限合并线程数或错峰写入 |
💡 关键直觉:ClickHouse 的写入和更新都是"追加 + 后台整理"模型,不是原地修改。理解了这一点,"磁盘为什么会涨"、"UPDATE 为什么慢"、"part 为什么会太多"就都有了答案。
要点速记
- part 生命周期:写入产生小 part → 后台合并变大 → 达到上限停止合并。
- 合并触发:part 数量或体积达阈值,按大小渐进合并,不是定时。
- 合并代价:CPU(重排压缩)、磁盘(新旧并存)、IO(读写),与查询争资源。
- mutation:UPDATE/DELETE 是异步重写整个 part,重且慢,别频繁用。
- 排查三表:
system.parts(part 数)、system.merges(合并进度)、system.mutations(mutation 进度)。 - 设计哲学:ClickHouse 存不可变明细,可变状态放别处。
第 2 章结束。你已经看清 ClickHouse 的进程模型、存储布局、后台维护。下一章进入它的核心——表引擎与数据模型,这是用 ClickHouse 最关键的一章。
用 system 三表定位合并问题
合并和 mutation 的可观测性都挂在 system 表上,排查"写入报 Too many parts"这类问题时,三个表配合着看:
-- 1. 各表活跃 part 数量(太多说明合并跟不上写入) SELECT database, table, count() AS active_parts FROM system.parts WHERE active GROUP BY database, table ORDER BY active_parts DESC; -- 2. 正在进行的合并任务 SELECT database, table, elapsed, progress, num_parts FROM system.merges; -- 3. 尚未完成的 mutation SELECT database, table, command, is_done, parts_to_do FROM system.mutations WHERE is_done = 0;
典型排查场景:写入突然报 Too many parts,说明活跃 part 数超过上限,合并跟不上写入速度。此时先看 system.merges 确认合并是否卡住,再看 system.parts 判断是哪个表的 part 在堆积,最后决定是降写入频率、错峰写入,还是调大后台合并资源。
part 数量的治理有几种手段。OPTIMIZE TABLE 可以手动触发一次合并,适合临时压 part 数,但它是同步的、会占用资源,别在高峰期频繁用:
-- 手动触发合并(同步执行,谨慎使用) OPTIMIZE TABLE events FINAL; -- 设置分区内 part 合并上限相关参数 ALTER TABLE events MODIFY SETTING parts_to_delay_insert = 300;
把 parts_to_delay_insert 调低,会让写入在 part 数接近阈值时自动放慢(delay),从源头防止 part 爆炸。这种"让写入自动减速"的机制,比手动 OPTIMIZE 更符合"写追加 + 后台整理"的设计哲学。