3.1 引擎体系分类
3.1 引擎体系分类
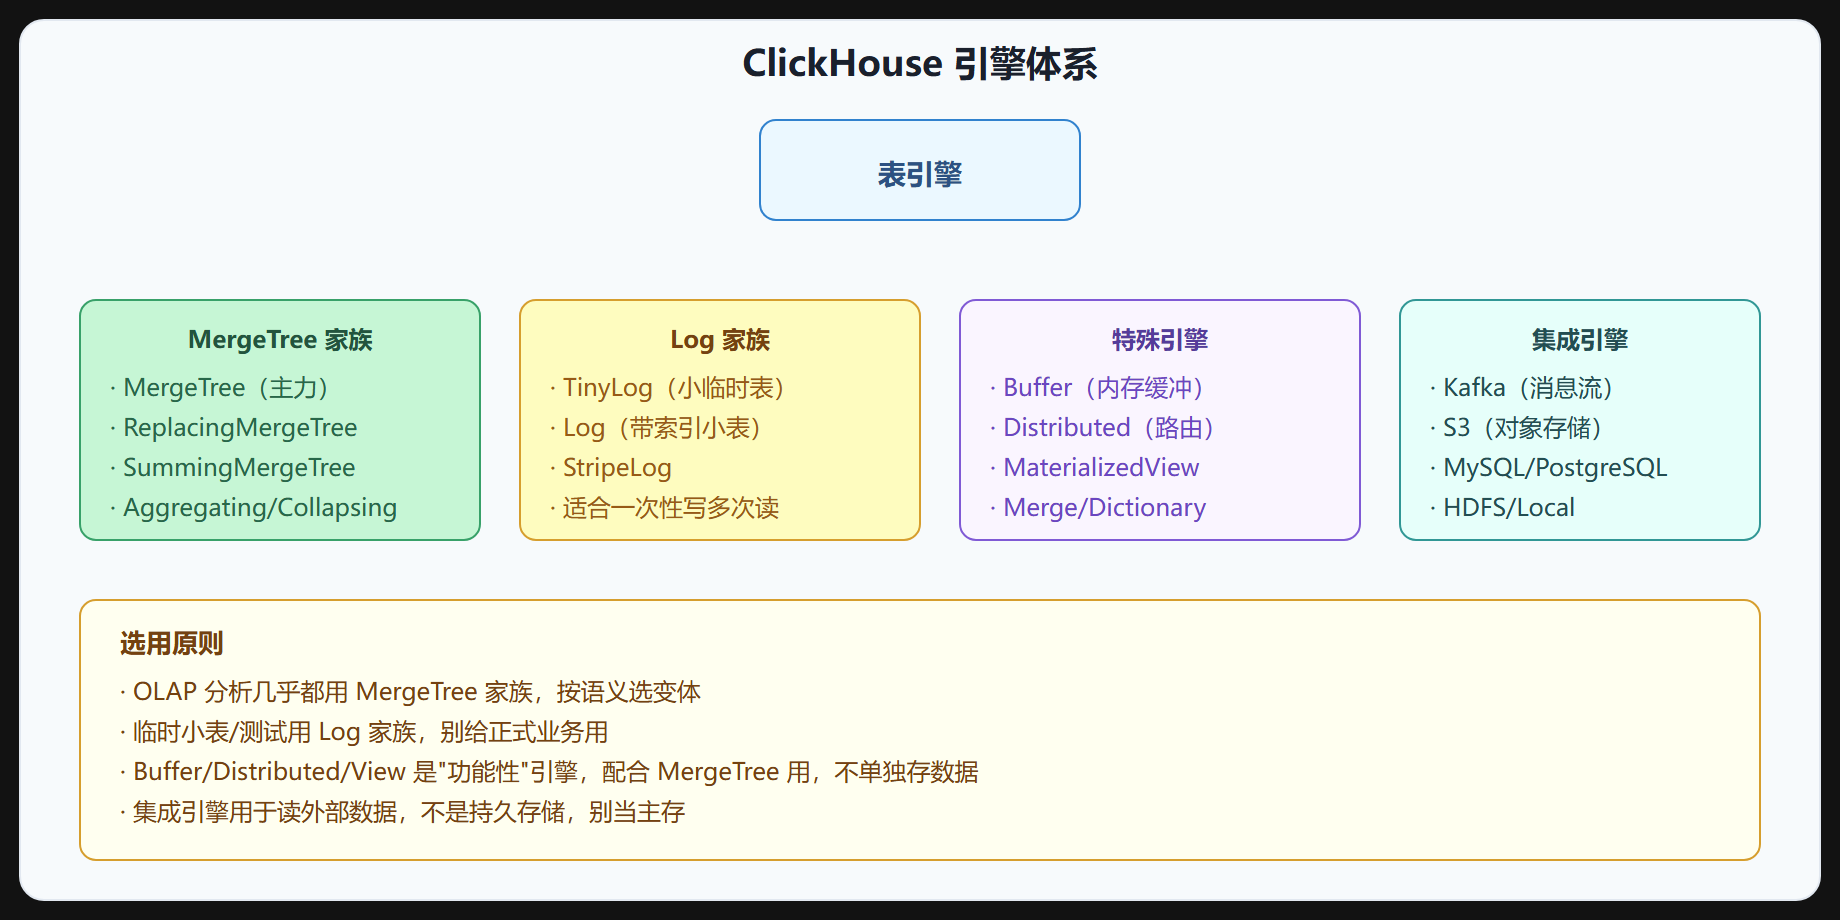
本节摘要:ClickHouse 有几十种表引擎,看着眼花,其实归成四大类就清楚了:MergeTree 家族(OLAP 主力)、Log 家族(临时小表)、特殊引擎(Buffer/Distributed/View)、集成引擎(Kafka/S3/MySQL)。本节讲清每类的定位。
本节导航
阅读完本节,你应当能够:
- 把 ClickHouse 的引擎归成四大类
- 说清每类引擎的定位和典型用法
- 为一个新表快速判断该用哪一类
- 避免把集成引擎当存储引擎用的常见错误
一、为什么引擎这么多
传统数据库的"引擎"通常只是存储格式差异(InnoDB vs MyISAM),上层 SQL 语义一致。ClickHouse 不一样:它的引擎直接决定表的语义。同样一句 SELECT,在 ReplacingMergeTree 上返回去重后的最新版本,在 Kafka 引擎表上返回尚未消费的消息流——语义完全不同。
所以选引擎不是选"存储格式",而是选"数据如何存在、如何合并、如何被查询"。这也是为什么引擎要单独成章讲。先看全貌,下一节再钻进 MergeTree 家族。
图 3-1 ClickHouse 引擎体系分类树
二、MergeTree 家族:OLAP 主力
这是 ClickHouse 的核心,几乎所有正式业务表都用它。家族里有一个基础引擎 MergeTree 和几个语义变体。基础 MergeTree 就是"按 ORDER BY 排序、分区、稀疏索引、后台合并",不带任何去重或聚合语义。变体在合并时额外做点事:
ReplacingMergeTree:合并时同主键只留最新版本(去重)SummingMergeTree:合并时同主键的数值列求和AggregatingMergeTree:合并时按预定义的聚合函数聚合CollapsingMergeTree:用 Sign 字段做"插入抵消"实现删除语义VersionedCollapsingMergeTree:带版本的 Collapsing
这些变体下一节细讲。这里只要记住:选 MergeTree 家族,再按业务语义挑变体。
三、Log 家族:临时小表
TinyLog、Log、StripeLog 这几个引擎结构简单,没有 MergeTree 的合并、分区、索引机制,适合一次性写入、多次读取的小表。比如临时存个中间结果、测试用。它们不支持并发写入(写的时候不能查),也不适合大表。正式业务别用,性能和维护都不如 MergeTree。
四、特殊引擎:功能性角色
这类引擎不持久化数据,而是承担某种功能角色:
- Buffer:在内存里缓冲写入,攒够再刷到底层表。用来缓解高频小批量写入。
- Distributed:不存数据,只是个路由层,把查询下发到各分片的本地表再合并。第 5 章细讲。
- MaterializedView:物化视图的载体,源表写入时自动增量更新。
- Merge:把多张同结构的表"虚拟"成一张来查,不改数据。
- Dictionary:把字典数据暴露成表,常用于 JOIN 维度表。
这些引擎通常和 MergeTree 配合用,比如"Buffer + MergeTree"缓解写入、"Distributed + ReplicatedMergeTree"做分布式。
五、集成引擎:读外部数据
Kafka、S3、MySQL、PostgreSQL、HDFS 这些引擎让你像查表一样读外部数据源。比如 Kafka 引擎表能消费 Kafka 消息流,MySQL 引擎表能联邦查询 MySQL 的表。它们不是持久存储——Kafka 表消费完消息就没了,MySQL 表是实时查远端的。
⚠️ 常见坑:有人把 Kafka 引擎表当主存,结果消息消费完就查不到了。集成引擎是"读外部数据的管道",不是"存数据的地方"。要持久化就把数据从集成引擎表
INSERT进 MergeTree 表。
六、选用对照
| 你的需求 | 选哪个引擎 |
|---|---|
| 海量日志分析,无需去重 | MergeTree |
| 同主键只留最新版本(如用户状态) | ReplacingMergeTree |
| 按维度自动求和(如指标聚合) | SummingMergeTree |
| 复杂预聚合(如带 count/avg) | AggregatingMergeTree |
| 用插入抵消实现删除 | CollapsingMergeTree |
| 临时小表测试 | TinyLog |
| 缓解高频小批量写入 | Buffer + MergeTree |
| 分布式查询路由 | Distributed + 本地表 |
| 消费 Kafka 持久化 | Kafka 表 → MaterializedView → MergeTree |
💡 关键直觉:90% 的业务表用 MergeTree 家族,剩下的是 Log(临时)、特殊引擎(功能)、集成引擎(外部数据)。先把主力用熟,别的按需配。
核心回顾
- 四大类:MergeTree 家族(主力)、Log 家族(临时)、特殊引擎(功能)、集成引擎(外部)。
- MergeTree 家族:基础 MergeTree + 几个语义变体,OLAP 几乎都用它。
- Log 家族:简单无合并,只适合一次性写的小临时表。
- 特殊引擎:Buffer/Distributed/View/Merge/Dictionary,功能性角色,配合 MergeTree 用。
- 集成引擎:Kafka/S3/MySQL 等,读外部数据的管道,不是持久存储。
- 选用先定大类(主力/临时/功能/外部),再在 MergeTree 家族里挑变体。
下一节钻进 MergeTree 家族,把每个变体的语义、合并行为、适用场景讲透。
用一句话验证引擎语义
引擎的差异光靠背记容易混,最可靠的办法是动手验证。比如 Buffer 引擎和普通 MergeTree 的差异,用 system.tables 就能看到引擎名,行为则靠写入观察:
-- 查看一张表用的引擎 SELECT name, engine, engine_full FROM system.tables WHERE database = 'default' AND name = 'events'; -- Buffer 引擎:内存缓冲,攒够才刷到底层表 CREATE TABLE events_buffer AS events ENGINE = Buffer(default, events, 16, 10, 100, 10000, 1000000, 10000000, 100000000);
Buffer 引擎的参数定义了刷盘策略:内存攒够多少行、多少字节、多少秒才往底层 MergeTree 写。写入先进 Buffer 表的内存,达到阈值后批量落到底层表,把高频小批量写转成低频大批量写。缺点是宕机会丢内存里没刷的数据——Buffer 只适合做"缓冲提速",不适合做持久存储。
另一个容易混淆的是 MaterializedView 和普通 View。普通视图只是 SQL 别名,不存数据;物化视图是真实表,源表写入时自动增量更新。验证方法很简单:分别查两张视图对应的 system.tables,物化视图有自己的存储路径,普通视图没有。
选引擎的次序也值得强调:先定大类(主力/临时/功能/外部),再在 MergeTree 家族里挑变体,最后用上面的 SQL 验证行为是否符合预期。把"选完不验证"改成"选完验证",很多引擎相关的坑就不会踩到了。