3.2 MergeTree 家族详解
3.2 MergeTree 家族详解
本节摘要:MergeTree 家族是 ClickHouse 的核心。本节把基础 MergeTree 和 Replacing/Summing/Aggregating/Collapsing 几个变体的合并语义、适用场景、常见坑讲透,让你建表时能选对变体。
读前必看
阅读完本节,你应当能够:
- 说清基础 MergeTree 的合并行为
- 区分五个变体各自的合并语义
- 为"用户状态"、"指标聚合"、"事件流"等场景选对变体
- 理解
FINAL关键字的代价
一、基础 MergeTree
基础 MergeTree 是家族里最朴素的:按 ORDER BY 排序、分区、稀疏索引、后台合并。合并时只做一件事——把小 part 按排序键合并成大 part,不做任何去重或聚合。同主键的行会保留多份。
什么时候用它?当你的数据天然不会重复(比如每条日志都是独立事件),不需要任何合并语义时。日志表、行为事件表大多用基础 MergeTree 就够了。
CREATE TABLE raw_events ( event_time DateTime, user_id UInt64, event String ) ENGINE = MergeTree PARTITION BY toYYYYMMDD(event_time) ORDER BY (event_time, user_id);
二、ReplacingMergeTree:同主键留最新
ReplacingMergeTree 在合并时,对主键相同的行只保留最新版本(按写入顺序,后写的覆盖先写的)。它解决的是"同主键数据会更新"的场景,比如用户资料表——同一个 user_id 的资料会变。
CREATE TABLE user_profile ( updated_at DateTime, user_id UInt64, name String, status String ) ENGINE = ReplacingMergeTree(updated_at) PARTITION BY toYYYYMMDD(updated_at) ORDER BY (user_id);
这里 ReplacingMergeTree(updated_at) 的参数指定"用哪个字段判断谁更新",updated_at 大的胜出。不传参数则按写入顺序。
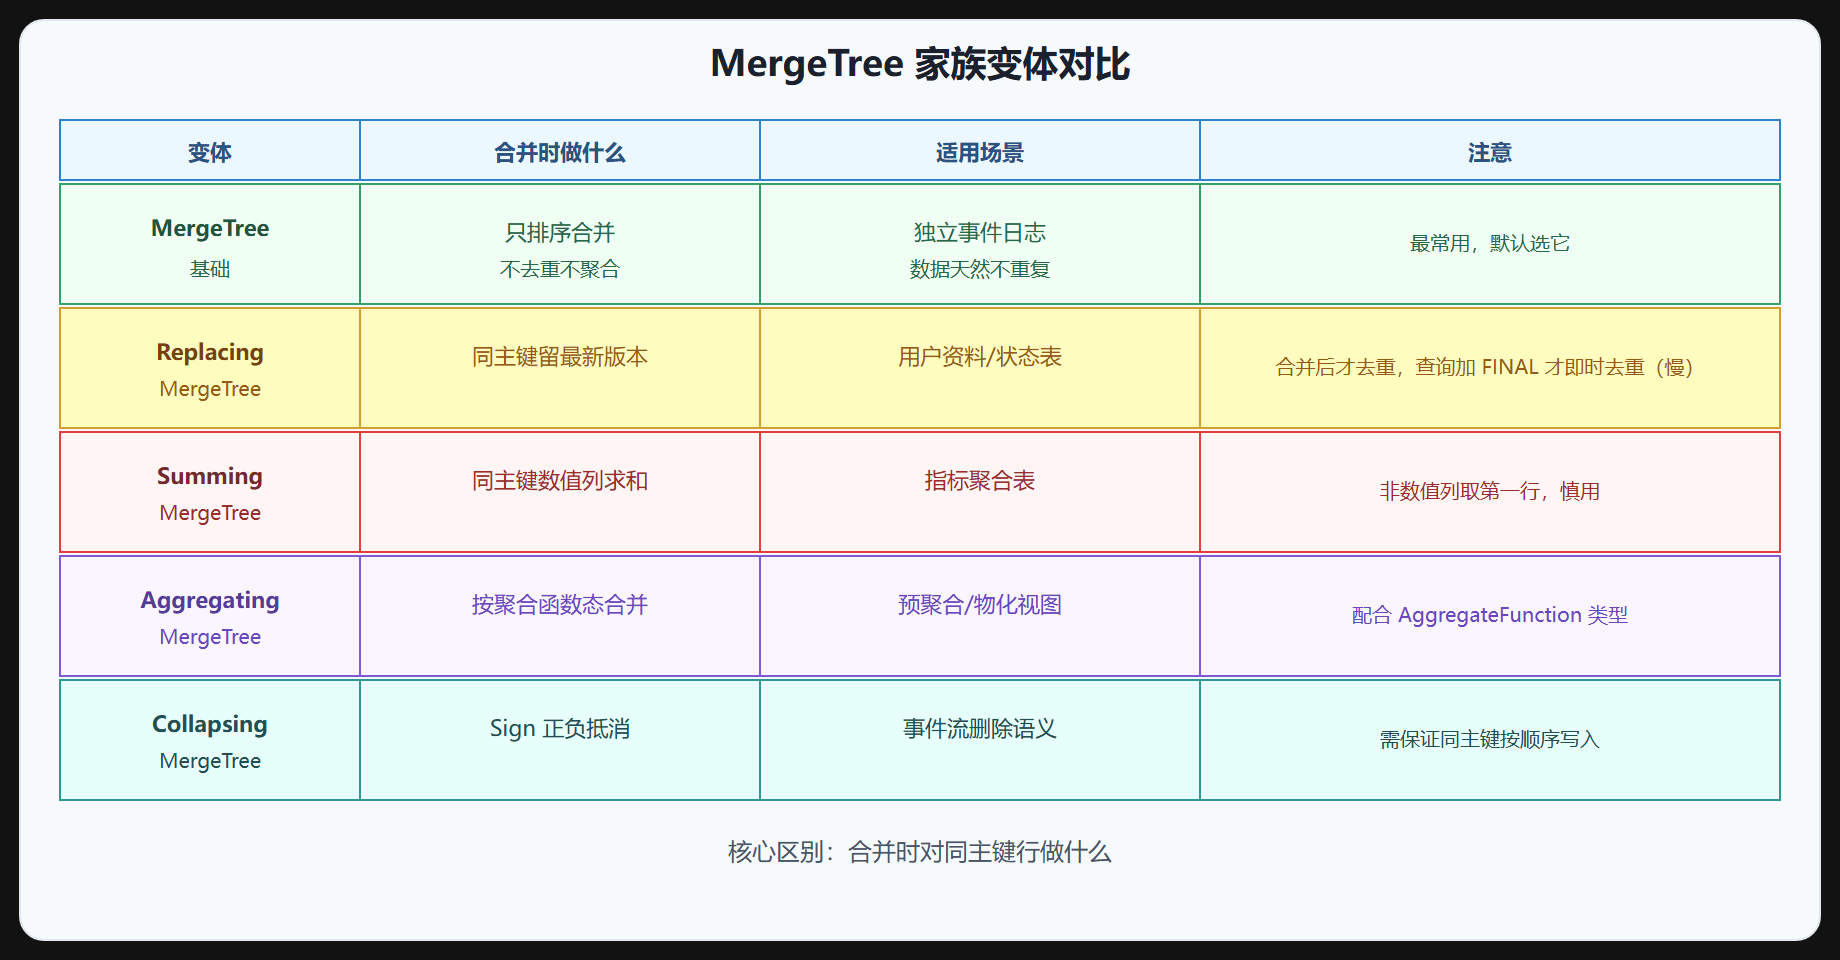
图 3-2 MergeTree 家族对比矩阵
三、SummingMergeTree:同主键求和
SummingMergeTree 在合并时,对主键相同的行,把数值列求和、非数值列取第一行。适合"按维度累加指标"的场景,比如分小时的指标要合并成按天的。
CREATE TABLE metrics ( day Date, device_id UInt64, clicks UInt64, cost Float64 ) ENGINE = SummingMergeTree PARTITION BY day ORDER BY (day, device_id);
注意它只对数值列求和,非数值列(如 String)取第一行,这可能不是你想要的。如果非数值列也想聚合,得用 AggregatingMergeTree。
四、AggregatingMergeTree:复杂预聚合
AggregatingMergeTree 配合 AggregateFunction 类型,能在合并时按预定义的聚合函数(如 sum、count、uniq、quantile)做聚合。它常和物化视图搭配:源表是明细,物化视图用 AggregatingMergeTree 存中间聚合态,查询时再 SELECT ... FROM 视图 拿最终结果。
CREATE TABLE events_raw (...) ENGINE = MergeTree ORDER BY ...; CREATE MATERIALIZED VIEW events_agg ENGINE = AggregatingMergeTree ORDER BY (day, city) AS SELECT toDate(event_time) AS day, city, sumState(amount) AS amount_sum, uniqState(user_id) AS user_cnt FROM events_raw GROUP BY day, city;
查询时用 sumMerge(amount_sum)、uniqMerge(user_cnt) 把聚合态还原成结果。这是 ClickHouse 做"灵活 + 快"的核心招数——既保留聚合灵活性,又靠预聚合提速。
五、CollapsingMergeTree:插入抵消
CollapsingMergeTree 用一个 Sign 字段(+1/-1)实现"删除"语义:插入一条 Sign=+1 的数据表示"添加",再插入一条同主键 Sign=-1 的表示"删除",合并时正负抵消。它适合"事件流"场景——比如订单状态变更,用插入新事件 + 抵消旧事件代替 UPDATE。
代价是要求同主键的 +1 和 -1 必须按顺序到达,否则抵消会失败。VersionedCollapsingMergeTree 加了版本号来缓解这个顺序依赖。
六、FINAL 的代价
这些变体的去重/聚合都只在后台合并时发生,没合并完查询会看到重复行。要查询时即时去重,加 FINAL 关键字:
SELECT * FROM user_profile FINAL WHERE user_id = 123;
FINAL 会在查询时强制做合并去重,代价很大——它要把所有 part 在查询时合并,相当于把后台合并的活临时干一遍。生产里对大表用 FINAL 是灾难。更好的做法是:要么靠后台合并保证最终一致(接受短暂重复),要么用 argMax/GROUP BY 在查询时去重,比 FINAL 高效。
| 方式 | 何时去重 | 代价 |
|---|---|---|
| 不加 FINAL | 后台合并时 | 短期可能看到重复行 |
| 加 FINAL | 查询时强制 | 高,大表慎用 |
| 查询时 GROUP BY + argMax | 查询时手动 | 中,比 FINAL 高效 |
⚠️ 常见坑:很多人建了 ReplacingMergeTree 就以为"自动去重了",查询不加 FINAL 看到重复行又困惑。记住:ReplacingMergeTree 只在合并时去重,合并没完成就有重复。要么接受最终一致,要么查询时手动去重,别滥用 FINAL。
💡 关键直觉:选变体的核心问题是"合并时对同主键行做什么"——什么都不做(MergeTree)、留最新(Replacing)、求和(Summing)、按函数聚合(Aggregating)、正负抵消(Collapsing)。业务语义决定选哪个。
本节速览
- 基础 MergeTree:只排序合并,不去重不聚合,独立事件日志用它。
- ReplacingMergeTree:同主键留最新版本,适合会更新的状态表,合并后才去重。
- SummingMergeTree:同主键数值列求和,适合指标聚合,非数值列取第一行慎用。
- AggregatingMergeTree:配合 AggregateFunction 做复杂预聚合,常配物化视图。
- CollapsingMergeTree:Sign 正负抵消实现删除,要求顺序到达。
- FINAL 代价大,大表别用,改用查询时 GROUP BY + argMax 去重。
- 选变体看"合并时对同主键做什么",由业务语义决定。
下一节讲索引机制:主键索引之外,跳数索引怎么给非主键列加速。
动手对比变体的合并行为
变体语义最好的学习方式是对比实验。建两张结构相同的表,一张 MergeTree、一张 SummingMergeTree,灌入同主键的多行数据,强制合并后再查询,观察差异:
-- 实验表 1:基础 MergeTree CREATE TABLE plain_agg (day Date, device UInt32, clicks UInt64) ENGINE = MergeTree PARTITION BY day ORDER BY (day, device); -- 实验表 2:SummingMergeTree CREATE TABLE sum_agg (day Date, device UInt32, clicks UInt64) ENGINE = SummingMergeTree PARTITION BY day ORDER BY (day, device); -- 灌入同主键的两行 INSERT INTO plain_agg VALUES ('2024-06-16', 1, 10); INSERT INTO plain_agg VALUES ('2024-06-16', 1, 20); INSERT INTO sum_agg VALUES ('2024-06-16', 1, 10); INSERT INTO sum_agg VALUES ('2024-06-16', 1, 20); -- 强制合并后再查 OPTIMIZE TABLE plain_agg FINAL; OPTIMIZE TABLE sum_agg FINAL; SELECT * FROM plain_agg; -- 两行都在:10 和 20 SELECT * FROM sum_agg; -- 合并成一行:clicks = 30
这个实验直观展示了"合并时对同主键行做什么":基础 MergeTree 什么也不做,SummingMergeTree 求和。注意 OPTIMIZE ... FINAL 是同步触发合并,实验场景用没问题,生产别频繁用。
ReplacingMergeTree 的去重同理,可以用 argMax 在查询时手动取最新版本,替代高代价的 FINAL:
-- 用 argMax 取每个用户的最新状态(比 FINAL 高效) SELECT user_id, argMax(status, updated_at) AS latest_status FROM user_profile GROUP BY user_id;
argMax(status, updated_at) 的含义是"取 updated_at 最大那一行的 status"。这种查询时手动去重的写法,避免了 FINAL 在查询时强制合并全部 part 的巨大开销,是大表上的推荐做法。