3.3 索引机制原理
3.3 索引机制原理
本节摘要:ClickHouse 的索引有三层:主键索引(稀疏,按 ORDER BY 自动建)、跳数索引(skip index,给非主键列加二级过滤)、数据跳数索引。本节讲清三者的原理、用法和选择,让你查询能跳过更多无关数据。
学习目标
阅读完本节,你应当能够:
- 说清主键索引的稀疏结构和定位机制
- 区分 minmax、set、bloom_filter 几种跳数索引
- 为非主键列选对跳数索引类型
- 理解索引失效的常见原因
一、三层索引概览
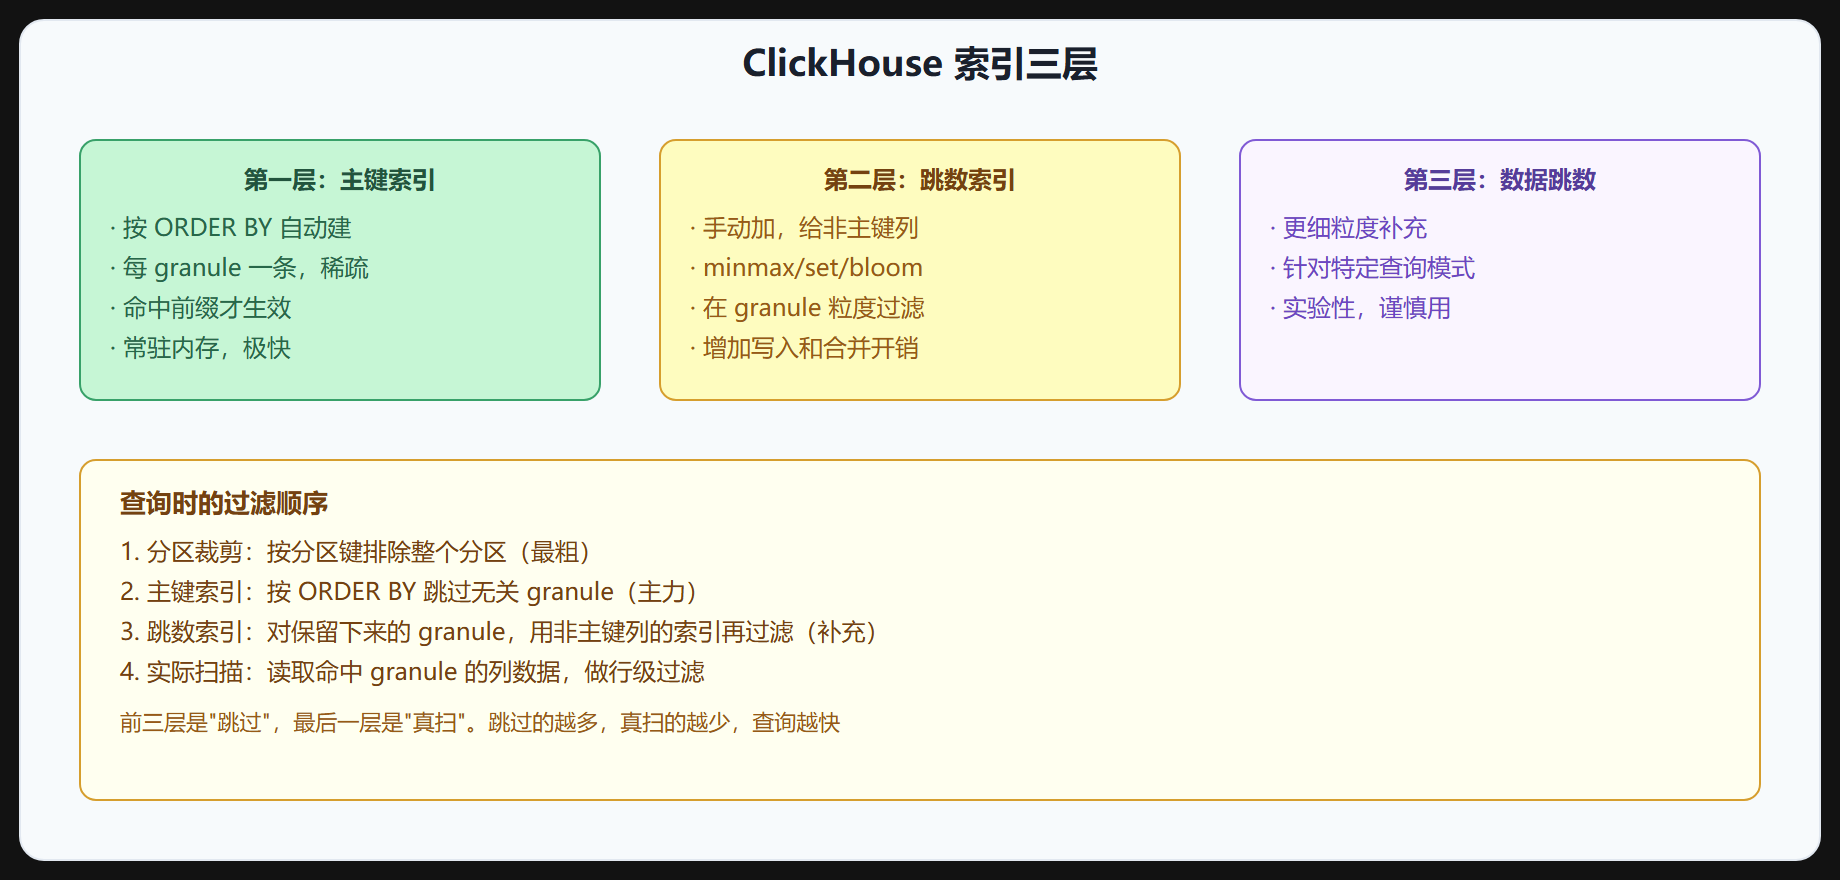
第 2 章讲过主键索引的稀疏结构。这里把三层索引放一起看:主键索引是默认的、按 ORDER BY 自动建的;跳数索引是手动加的、给非主键列做二级过滤;数据跳数索引是更细粒度的补充。三者叠加,决定查询能跳过多少数据。
图 3-3 ClickHouse 索引层级
二、主键索引:用好 ORDER BY
主键索引是按 ORDER BY 自动建的稀疏索引,第 2 章讲过它的结构。这里强调怎么用好它——核心是 ORDER BY 列的顺序。
主键索引只有当查询条件命中 ORDER BY 的前缀列时才生效。比如 ORDER BY (event_time, user_id, city):
WHERE event_time = X→ 生效WHERE event_time = X AND user_id = Y→ 生效WHERE user_id = Y→ 不生效(跳过了前缀 event_time)WHERE city = Z→ 不生效
所以 ORDER BY 的列顺序要按"查询最常过滤的列"排,最常过滤的排最前。这是建表时最关键的决定之一。
三、跳数索引:给非主键列加速
主键索引只管 ORDER BY 列。如果常按非主键列过滤(比如 WHERE city = '北京' 而 city 不在 ORDER BY 前缀),主键索引帮不上,这时加跳数索引。跳数索引在 granule 粒度记录一些摘要信息,查询时用这些信息判断整个 granule 要不要扫。
几种常用类型:
minmax:记录每个 granule 该列的最小最大值。查询WHERE x > 100时,如果某 granule 的 max < 100,整个 granule 跳过。适合数值或时间列,数据有序时效果好。set(max_rows):记录每个 granule 该列出现过的值集合(最多 max_rows 个)。查询WHERE x = 'A'时,如果该 granule 的集合里没有 'A',跳过。适合低基数字符串枚举。bloom_filter:布隆过滤器,判断"某值可能存在"。适合等值查询、高基数列。有 false positive 但无 false negative。ngrambf_v1/tokenbf_v1:n-gram 布隆过滤器,给字符串的 LIKE/contains 查询用。
CREATE TABLE events ( event_time DateTime, user_id UInt64, city LowCardinality(String), amount Float64, INDEX idx_city city TYPE set(100) GRANULARITY 4, INDEX idx_amount amount TYPE minmax GRANULARITY 4 ) ENGINE = MergeTree PARTITION BY toYYYYMMDD(event_time) ORDER BY (event_time, user_id);
GRANULARITY 4 表示每 4 个 granule 聚合成一条索引项(粒度比主键更粗)。值越小索引越细但越大,越大越粗越小。
四、跳数索引的选择
| 查询模式 | 列特征 | 选哪种 |
|---|---|---|
x > N / 范围查询 |
数值/时间,有序 | minmax |
x = V 等值 |
低基数枚举 | set |
x = V 等值 |
高基数 | bloom_filter |
x LIKE '%abc%' |
字符串 | ngrambf_v1 |
⚠️ 常见坑:跳数索引不是越多越好。每个跳数索引都增加写入和合并的开销(要维护索引),而且如果查询条件不命中它就白建。先看查询模式再决定加哪个,别盲目堆。
五、索引失效的常见原因
- ORDER BY 前缀不命中:主键索引要求前缀,跳过前缀列就失效。
- 函数包裹列:
WHERE toDate(event_time) = X如果 event_time 是 DateTime,函数包裹后可能不走索引。改用WHERE event_time >= X AND event_time < X + 1。 - 类型不匹配:
WHERE user_id = '123'(字符串)而 user_id 是 UInt64,隐式转换可能不走索引。保证类型一致。 - 跳数索引粒度太粗:GRANULARITY 设太大,跳过粒度太粗,收益下降。
- 数据无序:minmax 索引依赖数据有序,随机分布的列 minmax 跨度大,跳不过多少。
💡 关键直觉:索引的价值在"跳过",跳过的越多查询越快。建表时把最常过滤的列放 ORDER BY 前缀,次常用的加跳数索引,函数包裹和类型不匹配会偷偷让索引失效。
重点提炼
- 三层索引:主键索引(自动、稀疏、按 ORDER BY)、跳数索引(手动、非主键列)、数据跳数(补充)。
- 主键索引:只命中 ORDER BY 前缀才生效,列顺序按"最常过滤"排。
- 跳数索引类型:minmax(范围/有序)、set(低基数等值)、bloom_filter(高基数等值)、ngrambf(字符串 LIKE)。
- GRANULARITY:控制跳数索引粒度,小则细但大,大则粗但小。
- 索引失效:前缀不命中、函数包裹列、类型不匹配、数据无序、粒度太粗。
- 跳数索引有写入开销,按查询模式加,别盲目堆。
下一节讲数据类型系统,怎么用 LowCardinality、Array、日期类型省存储又提速。
用 EXPLAIN 验证索引是否生效
索引到底有没有被用到,不能靠猜,EXPLAIN 能给出明确答案。对 ORDER BY (event_time, user_id) 的表分别跑命中前缀和不命中前缀的查询,观察估算扫描的行数差异:
-- 命中主键前缀:WHERE 从 event_time 开始 EXPLAIN ESTIMATE SELECT count() FROM events WHERE event_time >= '2024-06-16 00:00:00' AND event_time < '2024-06-17 00:00:00'; -- 未命中前缀:只按 user_id 过滤 EXPLAIN ESTIMATE SELECT count() FROM events WHERE user_id = 12345;
如果两条查询的估算扫描行数相差很大,说明主键索引在正确工作;如果两条几乎一样,说明你的查询模式没有踩中索引,需要调整 ORDER BY 顺序或加跳数索引。
函数包裹列是让索引悄悄失效的高频原因,改造办法是改写条件:
-- 低效:函数包裹列,无法使用分区裁剪 SELECT count() FROM events WHERE toYYYYMMDD(event_time) = 20240616; -- 高效:区间写法,命中分区和主键 SELECT count() FROM events WHERE event_time >= '2024-06-16 00:00:00' AND event_time < '2024-06-17 00:00:00';
toYYYYMMDD(event_time) = 20240616 看起来很直观,但它在 WHERE 里对列套了函数,优化器无法把它转成对原始列的区间比较,导致分区裁剪失效、全分区扫描。把"函数套列"改写成"列与区间比较",是 ClickHouse 里最常用也最有效的小优化之一。