4.1 查询执行流程
4.1 查询执行流程
本节摘要:一句 SQL 进到 ClickHouse,要经过解析、优化、并行执行、结果合并几个阶段。本节把这条流水线拆开,并用
EXPLAIN教你看懂执行计划,定位慢在哪一步。
阅读收获
阅读完本节,你应当能够:
- 描述查询从接收到返回的完整流程
- 用
EXPLAIN看懂执行计划的各阶段 - 区分 PLAN、PIPELINE、ESTIMATE 几种 EXPLAIN
- 定位查询慢在扫描、聚合还是合并阶段
一、查询的完整流程
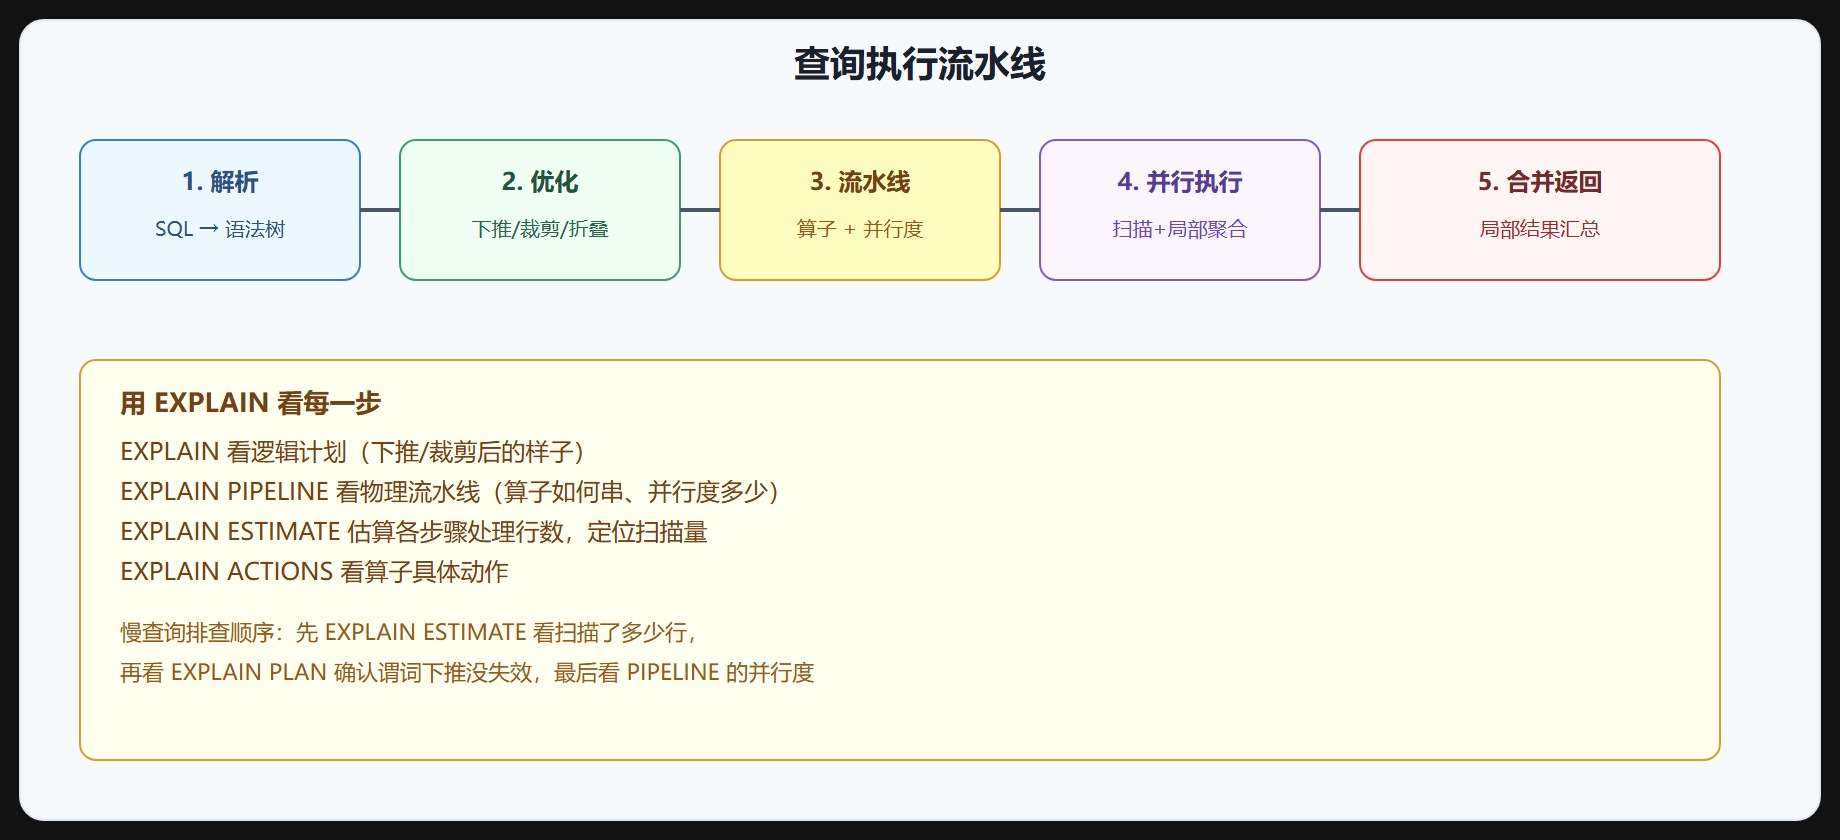
一句 SELECT 进来,ClickHouse 大致经过这几步:
- 解析:把 SQL 文本解析成语法树。
- 分析与优化:做谓词下推、投影裁剪、常量折叠等基于规则的优化,生成执行计划。
- 构建流水线:把执行计划转成算子流水线(pipeline),确定并行度。
- 并行执行:按
max_threads把流水线拆成多个并行任务,扫描 + 局部聚合。 - 合并结果:各并行任务的局部结果合并成最终结果,返回客户端。
图 4-1 查询执行流水线
二、用 EXPLAIN 看执行计划
EXPLAIN 是调优的第一工具。最常用的是 EXPLAIN(逻辑计划)和 EXPLAIN ESTIMATE(估算行数)。
EXPLAIN SELECT city, count() FROM events WHERE event_time >= '2024-06-16' GROUP BY city;
输出会显示:读哪个表、做了什么过滤(Where)、按什么聚合(Aggregating)、怎么排序。重点看过滤有没有下推到扫描层、有没有读多余的列。
EXPLAIN ESTIMATE SELECT city, count() FROM events WHERE event_time >= '2024-06-16' GROUP BY city;
ESTIMATE 会给出每个步骤估算处理的行数和 part 数。如果发现"扫描了几亿行"而你以为只该扫几百万,说明分区裁剪或主键索引没生效,回去查 WHERE 条件。
三、各阶段耗时定位
查询慢,要先定位慢在哪个阶段。ClickHouse 提供 system.query_log 记录每条查询的耗时分解:
SELECT query_duration_ms, ReadRows, -- 扫描了多少行 ResultRows, -- 返回多少行 MemoryUsage, -- 内存占用 exception FROM system.query_log WHERE event_time > now() - 3600 ORDER BY query_duration_ms DESC LIMIT 10;
| 慢在哪 | 表现 | 可能原因 |
|---|---|---|
| 扫描阶段 | ReadRows 巨大 | 分区/主键裁剪失效,扫描太宽 |
| 聚合阶段 | MemoryUsage 高 | GROUP BY 基数太大,内存撑爆 |
| 合并阶段 | 多分片结果合并慢 | 分布式表分片太多 |
| 等待阶段 | duration 大但 ReadRows 小 | 在排队等资源/锁 |
四、并行执行的细节
第 4 步并行执行是 ClickHouse 快的核心。一个查询被拆成多个并行任务,每个任务扫描一部分 granule 做局部聚合,最后合并。并行度由 max_threads 控制(第 2 章讲过)。
这里有个细节:聚合分两阶段——各线程先做局部聚合(局部哈希表),再把局部结果合并成全局结果。这种"局部 + 合并"的两阶段聚合让聚合能并行,但也意味着如果 GROUP BY 的基数(不同组数)极大,每个局部哈希表都很大,内存会爆。这就是为什么"GROUP BY 高基数列"容易内存溢出。
⚠️ 常见坑:
GROUP BY user_id(user_id 几百万个)容易内存溢出,因为每个局部哈希表都要存几百万个 key。解法是先按时间或其他维度收窄,或用max_memory_usage配合max_bytes_before_external_group_by让聚合溢写到磁盘。
温故知新
- 五步流程:解析 → 优化 → 流水线 → 并行执行 → 合并返回。
- EXPLAIN:看逻辑计划;EXPLAIN ESTIMATE:看扫描行数定位瓶颈。
- system.query_log:记录每条查询的耗时、扫描行数、内存,是排查慢查询的主表。
- 慢在哪:扫描量大(裁剪失效)、内存爆(GROUP BY 基数大)、合并慢(分片多)、等待(资源排队)。
- 两阶段聚合:局部聚合 + 合并,能并行但高基数 GROUP BY 易爆内存。
下一节讲具体的优化技术:谓词下推、投影裁剪、物化视图怎么用。
用 PIPELINE 与溢写配置追踪执行细节
EXPLAIN 之外,EXPLAIN PIPELINE 展示实际执行流水线:扫描算子、过滤算子、聚合算子按什么顺序连接、每个算子预计处理多少行。相比逻辑计划,它更贴近真实执行:
EXPLAIN PIPELINE SELECT city, sum(amount) FROM events WHERE event_time >= '2024-06-16' GROUP BY city;
如果看到过滤算子在扫描算子之后很远,或者扫描算子处理的列数比需要的多,说明有裁剪没生效。PIPELINE 模式下还能看到每个算子的并行度,配合 max_threads 判断单查询是否吃满了核。
聚合是查询里最容易出内存问题的一环。两阶段聚合(局部聚合 + 合并)在高基数 GROUP BY 时会撑爆内存,缓解手段是让聚合溢写到磁盘:
-- 允许聚合在内存紧张时溢写到磁盘 SET max_bytes_before_external_group_by = 10000000000; -- 设置单查询内存上限 SET max_memory_usage = 20000000000;
max_bytes_before_external_group_by 设成 max_memory_usage 的 60%-70% 是常见经验值:聚合数据超过这个阈值就开始写临时文件,避免内存直接爆掉。代价是溢写会变慢——这是"保命"的兜底,不是常态。如果查询频繁触发溢写,说明 GROUP BY 基数太大或数据没按时间收窄,应优先从查询结构上解决,而不是一味抬内存。