4.2 查询优化技术
4.2 查询优化技术
本节摘要:本节讲 ClickHouse 的几大优化手段:谓词下推、投影裁剪、物化视图、聚合下推、限制与采样。理解这些,你才能写出"优化器能帮上忙"的查询,也能在优化器帮不上时手动补救。
先说结论
阅读完本节,你应当能够:
- 说清谓词下推和投影裁剪的作用,识别失效场景
- 用物化视图做预聚合,让分析既灵活又快
- 用 LIMIT 和采样控制查询代价
- 避免几种让优化器帮不上忙的写法
一、谓词下推与投影裁剪
这两个是 ClickHouse 优化器最基础也最有效的手段,自动执行,但你要会识别它们失效的情况。
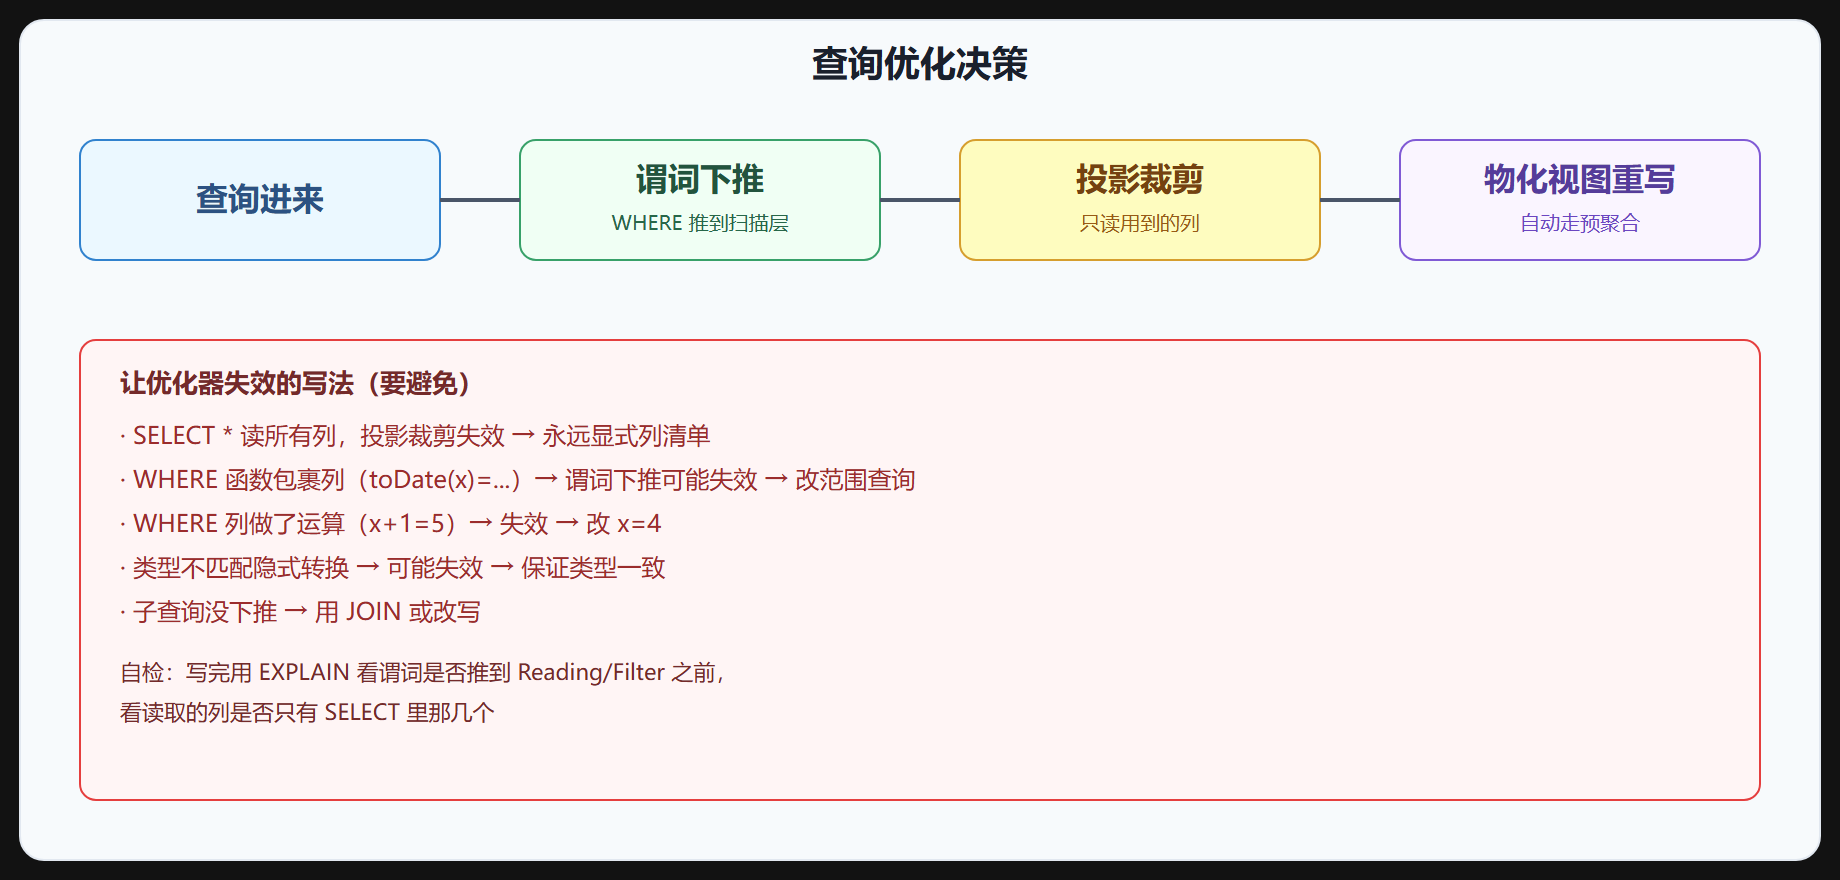
谓词下推:把 WHERE 条件尽量推到扫描层,让扫描时就跳过无关数据,而不是先全读再过滤。比如 SELECT ... FROM t WHERE date = X,下推后扫描时就只读 date=X 的 part。
投影裁剪:只读查询里用到的列,其余列不读。这是列存天然的优势,但要确保 SELECT 的列清单不冗余——SELECT * 会读所有列,把列存优势全废了。
图 4-2 优化器决策树
二、物化视图:预聚合的利器
物化视图是 ClickHouse 优化复杂分析的核心武器。它不是普通视图(普通视图只是 SQL 别名),而是真正存数据的表,源表写入时自动增量更新。
典型用法:源表存明细(MergeTree),物化视图用 AggregatingMergeTree 存预聚合态。查询时直接查物化视图,扫描量从"全量明细"降到"聚合后少量行",快几个数量级。
-- 源表:明细 CREATE TABLE events_raw ( event_time DateTime, city LowCardinality(String), amount Float64 ) ENGINE = MergeTree ORDER BY event_time; -- 物化视图:按天按城市预聚合 CREATE MATERIALIZED VIEW events_daily ENGINE = AggregatingMergeTree ORDER BY (day, city) AS SELECT toDate(event_time) AS day, city, sumState(amount) AS amount_sum, countState() AS cnt FROM events_raw GROUP BY day, city;
查询时用 sumMerge、countMerge 把聚合态还原:
SELECT day, city, sumMerge(amount_sum), countMerge(cnt) FROM events_daily WHERE day >= '2024-06-01' GROUP BY day, city;
物化视图的妙处在于:源表写入时自动增量更新,不用手动维护;查询时如果条件匹配,优化器会自动把对源表的查询重写到物化视图上。这是"灵活 + 快"的统一。
💡 关键直觉:宽表预聚合是 ClickHouse 的主场。与其在查询时做复杂聚合,不如用物化视图把聚合前置到写入时。查询变快,灵活性还在。
三、聚合下推与分布式查询
在分布式表上查询时,ClickHouse 会把聚合下推到各分片:各分片先做局部聚合,协调节点再合并。这样网络传输的是局部聚合结果(小),不是全量数据(大)。
但有些操作没法完全下推,比如 ORDER BY ... LIMIT N 需要各分片返回 top N 再全局排序,下推不完全。理解哪些能下推、哪些不能,能帮你设计分布式查询。
四、LIMIT 与采样
大数据量下,全量扫描代价高。两种控制代价的手段:
LIMIT:SELECT ... LIMIT 1000 只返回前 1000 行,但注意 ClickHouse 不保证顺序,除非加 ORDER BY。LIMIT 配合 ORDER BY 才有意义。
采样:SELECT ... FROM t SAMPLE 0.1 只扫描 10% 的数据做近似查询。适合探索性分析——先采样看个大概,确认方向再全量跑。采样是确定性的(按某列哈希),同条件多次采样结果一致。
-- 近似去重,采样 10% SELECT city, uniqApprox(user_id) FROM events SAMPLE 0.1 GROUP BY city;
五、几种常见低效写法
| 低效写法 | 问题 | 改进 |
|---|---|---|
SELECT * |
投影裁剪失效 | 显式列清单 |
WHERE toDate(t) = '2024-06-16' |
函数包裹列,下推失效 | WHERE t >= '2024-06-16' AND t < '2024-06-17' |
WHERE x + 1 = 5 |
列运算,下推失效 | WHERE x = 4 |
count(distinct user_id) 全量 |
高基数去重慢 | 用 uniq(user_id) 近似去重 |
大表 ORDER BY rand() LIMIT 10 |
全表排序 | 用 SAMPLE 或按主键取 |
⚠️ 常见坑:
count(distinct ...)在大数据量下很慢,因为它要维护一个全局去重集合。ClickHouse 提供uniq()/uniqExact(),uniq()是近似去重(HyperLogLog),快得多,误差可控。除非必须精确去重,否则用uniq()。
要点速记
- 谓词下推:WHERE 推到扫描层,函数包裹列/列运算/类型不匹配会让它失效。
- 投影裁剪:只读用到的列,
SELECT *让它失效,永远显式列清单。 - 物化视图:AggregatingMergeTree 预聚合,写入时增量更新,查询自动重写,灵活又快。
- 聚合下推:分布式查询各分片局部聚合再合并,网络传小结果。
- LIMIT/SAMPLE:控制查询代价,采样适合探索性近似分析。
- uniq() 替代 count(distinct),近似去重快得多。
下一节把这些技术落到性能调优实践上,给一套慢查询排查流程。
物化视图的增删改与回填
物化视图用起来有几个容易忽略的细节。首先是它的"增量"属性:物化视图只处理创建之后写入源表的数据,不会回填历史。如果先有表、后有视图,历史数据不在视图里,需要手动回填:
-- 建物化视图后,手动回填历史数据 INSERT INTO events_daily SELECT toDate(event_time) AS day, city, sumState(amount) AS amount_sum, countState() AS cnt FROM events_raw WHERE event_time < '2024-06-01' GROUP BY day, city;
注意回填时用的是 sumState/countState(聚合态函数),而不是 sum/count,因为 events_daily 是 AggregatingMergeTree,存的本来就是聚合中间态。这一点写错,回填的数据会无法正确 Merge。
物化视图的另一个坑是"底层是隐藏表"。CREATE MATERIALIZED VIEW 会生成一张存储数据的表,删视图不会删数据,删数据要删视图对应的 .inner 表:
-- 查看物化视图对应的存储表 SELECT name, engine FROM system.tables WHERE name LIKE '.inner%'; -- 彻底删除物化视图及其数据 DROP TABLE default.`.inner_id_xxxxxxxx` SYNC;
最后是"是否命中自动重写"的判断。优化器会在源表查询条件与物化视图定义匹配时自动重写,但匹配规则严格,比如过滤粒度和 GROUP BY 维度不一致就可能不命中。别依赖自动重写——要么明确查物化视图本身,要么用 EXPLAIN 确认重写发生,避免"建了视图却不生效"的错觉。