4.3 性能调优实践
4.3 性能调优实践
本节摘要:本节给一套可落地的慢查询排查流程,从看
query_log定位、到 EXPLAIN 分析、到对症下药,并附常见瓶颈和参数调优清单。
核心问题
阅读完本节,你应当能够:
- 按流程排查一个慢查询,定位瓶颈类型
- 针对不同瓶颈选对优化手段
- 调几个常用参数改善性能
- 建立慢查询监控机制
一、慢查询排查流程
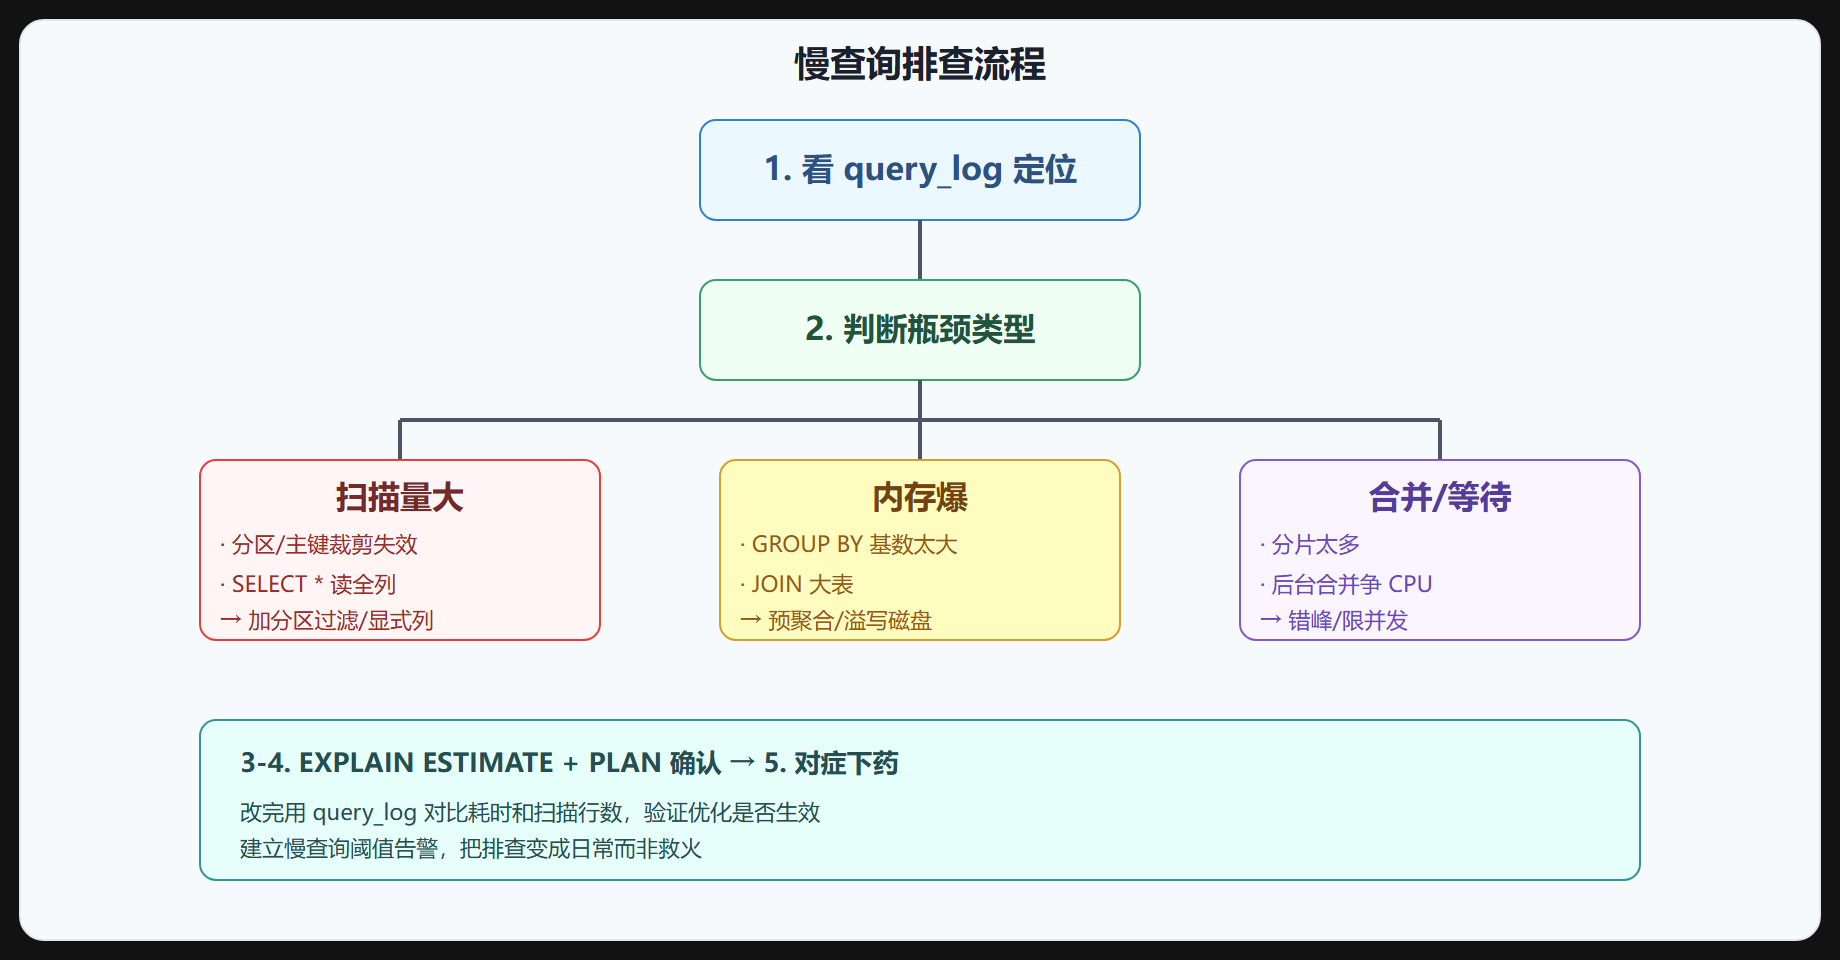
遇到慢查询,别急着改 SQL,按这个流程走:
- 看 query_log:从
system.query_log找到这条查询的耗时、扫描行数、内存、异常。 - 判断瓶颈类型:扫描量大(IO/CPU)、内存爆(聚合基数)、合并慢(分布式)、等待(资源)。
- EXPLAIN ESTIMATE:看扫描了多少行、读了多少 part,确认裁剪有没有生效。
- EXPLAIN PLAN:看谓词下推、投影裁剪有没有失效。
- 对症下药:按瓶颈类型选优化手段。
图 4-3 慢查询排查流程
二、常见瓶颈与对策
瓶颈一:扫描量太大
最常见。表现是 ReadRows 巨大。根因通常是分区或主键裁剪没生效。
对策:
- WHERE 加上分区键过滤(如
event_time范围) - 确保条件命中 ORDER BY 前缀
- 别
SELECT *,显式列清单 - 高频非主键过滤加跳数索引
瓶颈二:内存溢出
表现是 MemoryUsage 接近上限或报 Memory limit exceeded。根因是 GROUP BY 基数大或 JOIN 大表。
对策:
- 提高上限:
SET max_memory_usage = 10000000000(10GB) - 开聚合溢写磁盘:
SET max_bytes_before_external_group_by = 5000000000 - 开 JOIN 溢写:
SET max_bytes_before_external_join = ... - 用
uniq()替代count(distinct) - 用物化视图预聚合降低基数
瓶颈三:分布式合并慢
表现是单分片快、分布式表慢。根因是分片太多、网络传输、协调节点合并。
对策:
- 控制分片数,别过度分片
- 聚合能下推就下推(默认会下推)
- 大结果集避免
SELECT *到分布式表
瓶颈四:后台任务争抢
表现是查询时延波动大,CPU 高。根因是合并或 mutation 和查询争 CPU/IO。
对策:
- 限制合并线程数:
background_pool_size、merge_tree.max_merge_select_threads - 错峰写入:批量写入集中在低峰
- mutation 排队别堆太多
三、常用参数调优
| 参数 | 作用 | 调优建议 |
|---|---|---|
max_threads |
单查询线程数 | 默认核数,高并发场景调低 |
max_memory_usage |
单查询内存上限 | 大聚合调高,配合溢写 |
max_bytes_before_external_group_by |
聚合溢写磁盘阈值 | 设为内存上限的 60-70% |
max_block_size |
批处理块大小 | 默认 65536,一般不动 |
index_granularity |
granule 行数 | 默认 8192,一般不动 |
background_pool_size |
后台任务线程池 | 写入压力大时调大 |
⚠️ 常见坑:调参不是越多越好。很多参数有默认值是有道理的,乱调可能让别的场景变差。调一个参数前先想清楚它影响什么、为什么默认值不合适。能用结构优化(分区、索引、物化视图)解决的,别靠参数硬扛。
四、建立慢查询监控
把排查变成日常而非救火,靠监控。设一个慢查询阈值(比如 10 秒),超过就记录并告警:
SELECT query_duration_ms, query, ReadRows, MemoryUsage, event_time FROM system.query_log WHERE query_duration_ms > 10000 AND type = 'QueryFinish' ORDER BY query_duration_ms DESC LIMIT 20;
定期看这张表,找出 top 慢查询逐个优化。配合第 6 章的监控体系,慢查询、合并队列、磁盘占用一起盯,集群健康度就有保障。
一节小结
- 排查五步:query_log 定位 → 判断瓶颈 → EXPLAIN ESTIMATE → EXPLAIN PLAN → 对症下药。
- 四大瓶颈:扫描量大(裁剪失效)、内存爆(基数大)、合并慢(分片多)、争抢(后台任务)。
- 内存对策:调高上限 + 开聚合/JOIN 溢写磁盘 + uniq 替代 count(distinct) + 物化视图预聚合。
- 参数调优:max_threads、max_memory_usage、external_group_by 是最常用的几个,调前想清楚影响。
- 慢查询监控:设阈值定期看 query_log,把排查变日常。
第 4 章结束。你已经能看懂执行计划、应用优化技术、系统排查慢查询。下一章把单机扩成分布式集群。
一份可复用的调优检查清单
把调优经验沉淀成检查清单,比每次都从零排查高效得多。下面是一份按优先级排列的检查清单,配合 SQL 直接执行:
-- 1. 找出一小时内最慢的 20 条查询 SELECT query_duration_ms, read_rows, read_bytes, memory_usage, query FROM system.query_log WHERE event_time > now() - INTERVAL 1 HOUR AND type = 'QueryFinish' ORDER BY query_duration_ms DESC LIMIT 20; -- 2. 按查询特征分类:看慢查询主要卡在扫描还是聚合 SELECT if(read_rows > 10000000, 'scan_heavy', 'other') AS category, count() AS cnt, round(avg(query_duration_ms)) AS avg_ms FROM system.query_log WHERE event_time > now() - INTERVAL 1 HOUR AND type = 'QueryFinish' GROUP BY category;
清单的优先级大致是:结构问题优先于参数问题。第一看查询是否扫了太多数据(分区/主键没命中、SELECT *、函数包裹列),第二看聚合是否太重(高基数、没走物化视图),第三才轮得到调参数。大部分慢查询在前两步就能解决。
针对"扫描量大"的常见修法是把高频过滤条件固定下来。如果查询总是按 event_time 过滤,把 ORDER BY 首列设为 event_time 且按天分区,查询裁剪效果立竿见影。已经上线的表要调整排序键,可以用新增一个按新键组织的物化视图的方式渐进迁移,而不是直接改表结构。
监控和调优是闭环的:调优前记录基线(query_log 里的平均耗时),调优后对比同一指标。没有基线的调优无法判断是变好还是变差,这也是第 6 章要讲监控的原因。