6.2 监控与告警
6.2 监控与告警
本节摘要:监控是运维的眼睛。本节把 ClickHouse 的关键指标分层(系统/服务/查询/副本),给出告警阈值建议,并讲怎么搭监控体系。
本节目标
阅读完本节,你应当能够:
- 列出 ClickHouse 的四层监控指标
- 为关键指标设合理告警阈值
- 搭一套 Prometheus + Grafana 监控
- 区分"正常波动"和"真故障"
一、四层监控指标
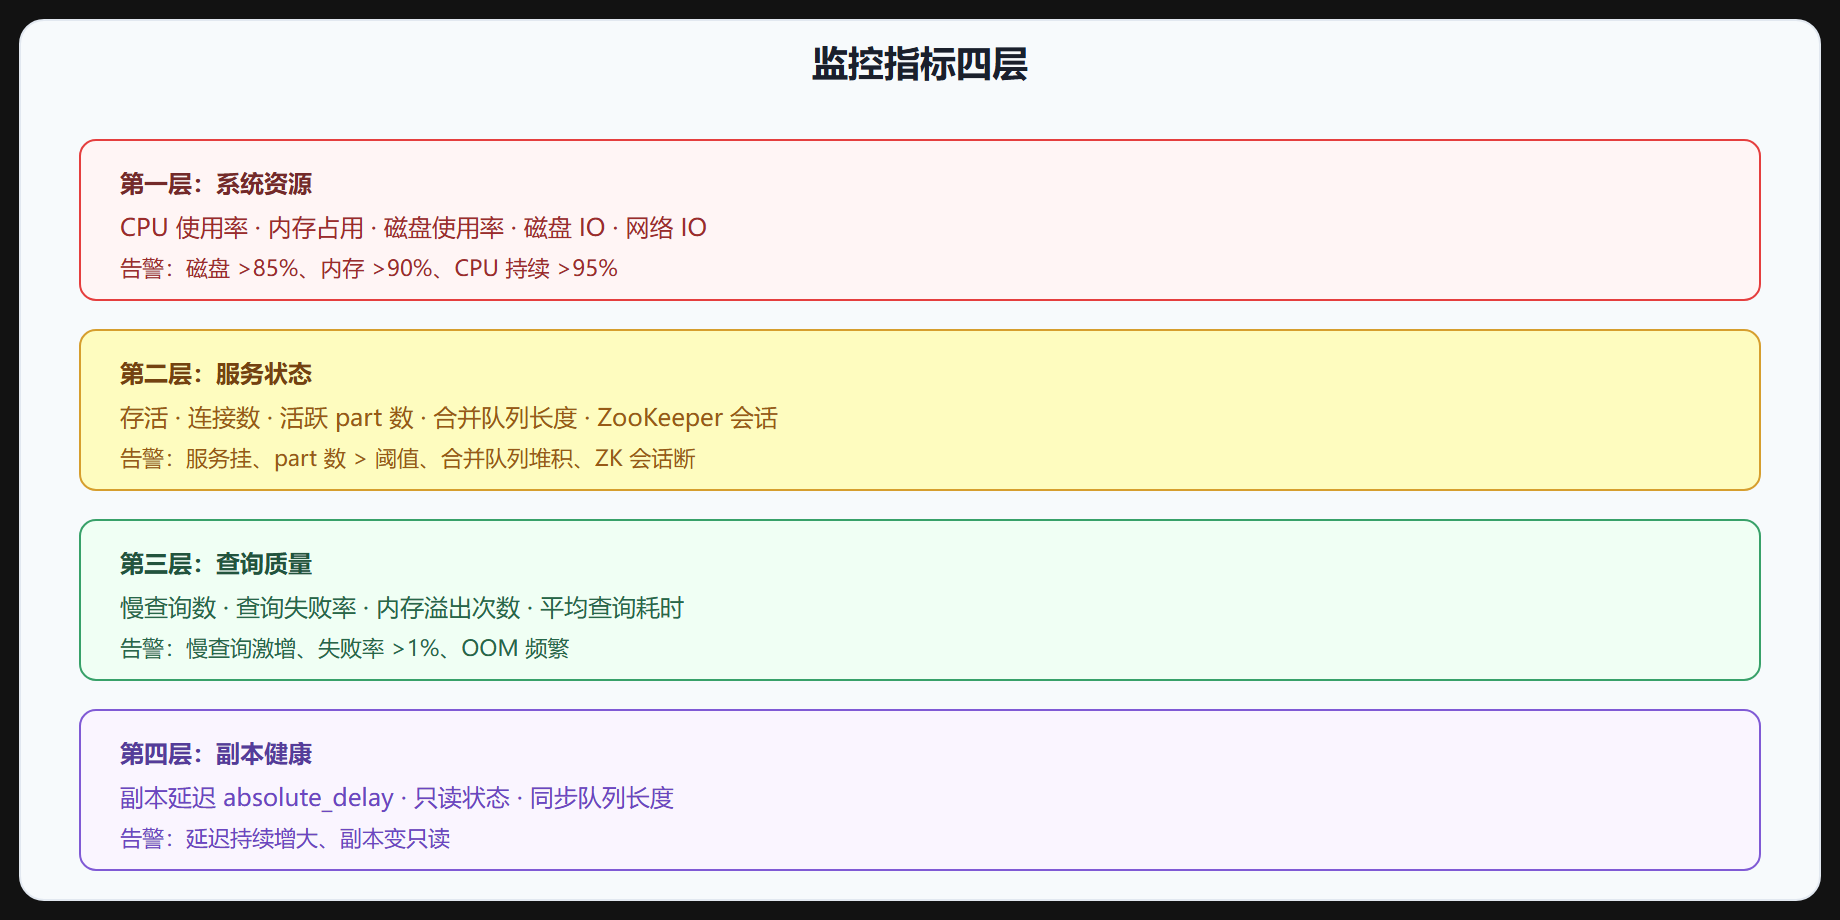
ClickHouse 的监控指标可以分成四层,从底到上:系统资源、服务状态、查询质量、副本健康。
图 6-2 监控指标分层
二、关键指标与阈值
ClickHouse 把大量指标暴露在 system.* 表里,配合 Prometheus exporter 采集。几个必盯的:
| 指标 | 来源 | 告警阈值 |
|---|---|---|
| 磁盘使用率 | system.disks | >85% 警告,>92% 紧急 |
| 活跃 part 数 | system.parts (active=1) | 单表 >1000 查合并 |
| 合并队列长度 | system.merges | 持续 >10 排查 |
| 慢查询数 | system.query_log | >10s 的查询激增告警 |
| 查询失败率 | system.query_log | >1% 告警 |
| 副本延迟 | system.replicas.absolute_delay | 持续 >100 排查 |
| ZooKeeper 会话 | system.replicas.is_session_expired | 任一节点 expired 告警 |
| 内存使用 | system.metrics | 接近 max_memory_usage 告警 |
三、几个关键 system 表
排查问题时这几个表最常用:
-- 磁盘 SELECT name, path, free, total FROM system.disks; -- 活跃 part 数(按表) SELECT database, table, count() AS parts FROM system.parts WHERE active GROUP BY database, table ORDER BY parts DESC LIMIT 20; -- 合并进度 SELECT database, table, elapsed, progress, num_parts FROM system.merges; -- 副本状态 SELECT database, table, replica_name, absolute_delay, is_readonly FROM system.replicas; -- 慢查询 SELECT query_duration_ms, query, ReadRows, MemoryUsage FROM system.query_log WHERE type = 'QueryFinish' AND query_duration_ms > 10000 ORDER BY query_duration_ms DESC LIMIT 20;
四、搭监控体系
主流方案是 Prometheus + Grafana:
- 采集:用 ClickHouse 的 Prometheus exporter(官方或社区),把
system.*指标转成 Prometheus 格式。 - 存储:Prometheus 存指标,按时间序列。
- 展示:Grafana 画仪表盘,分四层展示。
- 告警:Prometheus AlertManager 按阈值发告警(邮件/钉钉/Slack)。
社区有现成的 ClickHouse Grafana 仪表盘模板,导入即用,再按自己集群调整。
五、区分正常波动与故障
监控会报很多,要学会区分:
- part 数波动:写入后 part 数上升是正常的,合并后会回落。持续不回落才异常。
- 副本延迟:短暂延迟是异步同步的正常表现,持续增大才是问题。
- 慢查询偶发:单个慢查询可能是用户写了烂 SQL,激增才是系统问题。
- CPU 峰值:合并时 CPU 高是正常的,持续 100% 才异常。
⚠️ 常见坑:新手把所有指标都设告警,结果告警泛滥,真正出问题反而被淹没。告警要少而精——只盯会导致故障的指标,设合理阈值,避免"狼来了"。
💡 关键直觉:监控的价值不在"看多少指标",在"出问题时能快速定位"。四层指标 + 合理阈值 + 少而精的告警,比堆一百个仪表盘有用。
要点速记
- 四层指标:系统资源、服务状态、查询质量、副本健康,从底到上。
- 必盯指标:磁盘使用率、活跃 part 数、合并队列、慢查询、副本延迟、ZK 会话。
- 排查三表:system.disks、system.parts、system.merges、system.replicas、system.query_log。
- 监控栈:Prometheus 采集 + Grafana 展示 + AlertManager 告警,有现成模板。
- 区分波动与故障:part 数、副本延迟、CPU 峰值有正常波动,持续异常才是故障。
- 告警少而精,别泛滥。
下一节讲备份与恢复——出事时的保险。
一条 SQL 生成监控看板数据
监控体系搭好之前,先用几条 SQL 把核心指标查出来,手工做一张"体检表"也很有价值。下面的语句可以在几条查询里汇总四层指标:
-- 服务层:当前连接数、正在执行的查询数 SELECT (SELECT value FROM system.metrics WHERE metric = 'TCPConnection') AS tcp_conn, (SELECT count() FROM system.processes) AS running_queries; -- 数据层:各表活跃 part 数 SELECT database, table, count() AS active_parts FROM system.parts WHERE active GROUP BY database, table ORDER BY active_parts DESC LIMIT 10; -- 查询质量:最近一小时的慢查询数与失败率 SELECT countIf(query_duration_ms > 10000) AS slow_count, countIf(exception IS NOT NULL) / count() AS fail_rate FROM system.query_log WHERE event_time > now() - INTERVAL 1 HOUR AND type = 'QueryFinish';
这三段可以组合成一个"每日体检"脚本,输出一行健康概览。等 Prometheus + Grafana 搭好后,把同样的指标接进去持续采集,体检就从"每日一次"变成"实时刷新"。
告警阈值设计有一个实用的原则:阈值要比"正常波动上限"略高,比"故障下限"略低。比如磁盘使用率,正常运营一般到 60%-80%,故障临界在 90% 以上,把警告设在 85%、紧急设在 92%,既不会天天误报,也不会等爆盘才发现。
别忘了把告警分级:警告级(磁盘 85%)当天处理即可,紧急级(副本会话过期、磁盘 92%)要立刻响应。分级能让值班的人分清轻重缓急,避免所有告警一视同仁带来的麻木。
指标告警落到配置
前面讲了看哪些指标,这里落到可执行的一步:把慢查询阈值和失败率做成每日自检视图。用 system.query_log 配一个简单的视图,值班的人每天看一眼就能掌握整体质量:
-- 建立慢查询与失败率自检视图 CREATE VIEW v_query_health AS SELECT toStartOfHour(event_time) AS hour, countIf(query_duration_ms > 10000) AS slow_queries, countIf(exception IS NOT NULL) AS failed_queries, count() AS total_queries FROM system.query_log WHERE type = 'QueryFinish' GROUP BY hour ORDER BY hour DESC;
这个视图把"查询质量"压缩成按小时一行,慢查询数和失败数一目了然。等 Prometheus 接入后,同一个查询可以直接转成指标表达式,阈值和分级沿用前面讨论的规则。监控不是越复杂越好——先把核心指标查到、看到、告警到,再逐步丰富,是运维体系从零到一的正确路径。