6.3 备份与恢复
6.3 备份与恢复
本节摘要:备份是出事时的保险。本节讲 ClickHouse 的几种备份方式(part 拷贝、clickhouse-backup、S3 冷备)、恢复流程、容灾规划,让你能从故障中把数据救回来。
你能学到什么
阅读完本节,你应当能够:
- 选择合适的备份方式
- 制定备份策略(频率、保留、存储位置)
- 执行数据恢复流程
- 规划容灾方案
一、为什么备份
很多人觉得"有副本就不用备份了",这是误解。副本防的是单机故障,防不了:
- 误操作:
DROP TABLE、DELETE FROM误删,副本也会同步删掉。 - 逻辑错误:错误的 ETL 写入脏数据,副本也是脏的。
- 集群级故障:整个机房断电、协调服务全挂。
- 勒索/破坏:恶意删除。
副本是高可用手段,备份是数据安全手段,两者不能互相替代。生产必须有备份。
二、几种备份方式
方式一:part 级别拷贝
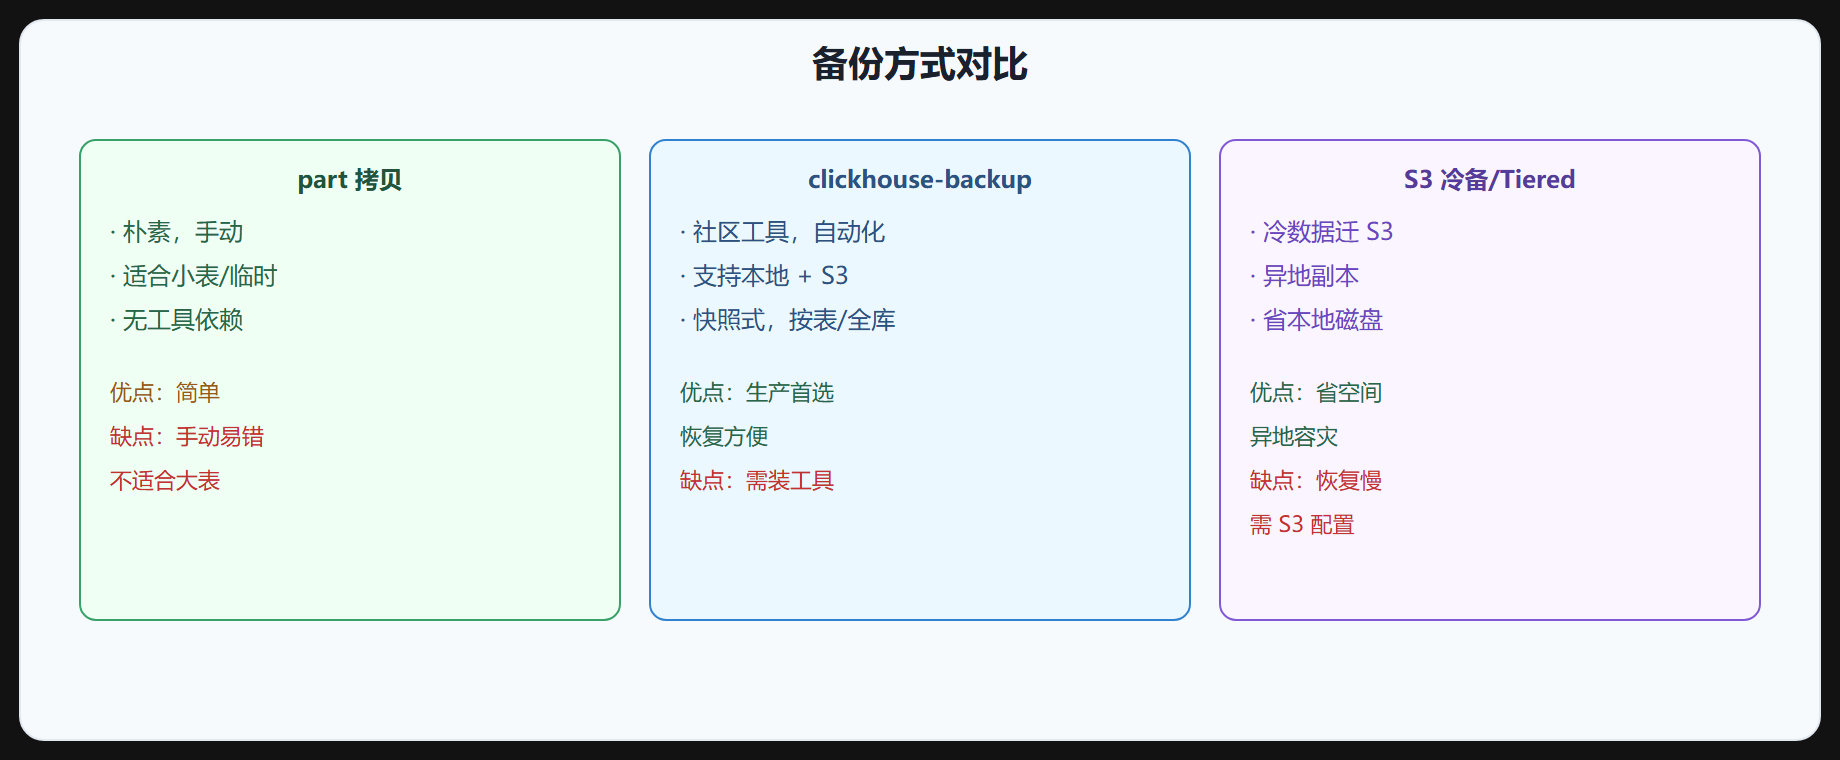
最朴素的方式——把数据目录里的 part 拷到备份存储。MergeTree 的 part 是自包含的(一个 part 目录有完整数据),拷走就能恢复。适合手动备份小表。
# 找到 part 路径 ls /var/lib/clickhouse/data/default/events/20240615_1_1/ # 拷到备份位置 cp -r /var/lib/clickhouse/data/default/events/20240615_1_1 /backup/events_20240615/
恢复时把 part 拷回数据目录,ALTER TABLE ... ATTACH PARTITION 挂载。
方式二:clickhouse-backup 工具
社区工具 clickhouse-backup 能做完整的备份恢复,支持本地和 S3。它创建快照式备份,能按表或全库备份,恢复也方便。
clickhouse-backup create my_backup_20240615 clickhouse-backup upload my_backup_20240615 # 上传到 S3 clickhouse-backup download my_backup_20240615 # 从 S3 下载 clickhouse-backup restore my_backup_20240615
这是生产最常用的方式,配合定时任务做日常备份。
方式三:S3 冷备 / Tiered Storage
ClickHouse 支持把冷数据存到 S3(Tiered Storage 或 S3 表引擎),相当于一份异地副本。配合 TTL 把冷数据自动迁到 S3,既省本地磁盘又有冷备。
图 6-3 备份方式对比
三、备份策略
光有方式不够,还要有策略:
- 频率:热数据每天全备 + 增量,冷数据低频。
- 保留:本地保留近 7 天,异地保留近 30 天或更久(按合规要求)。
- 存储:备份要存到和集群不同的位置(异地),防机房级故障。
- 验证:定期做恢复演练,确认备份能用——只备份不验证等于没备。
| 数据重要性 | 备份频率 | 保留 | 存储 |
|---|---|---|---|
| 核心 | 每天全备+增量 | 本地7天+异地30天 | 异地 S3 |
| 一般 | 每天增量 | 本地7天 | 本地+异地 |
| 冷数据 | 低频 | 长期 | S3 冷备 |
四、恢复流程
出事时的恢复流程:
- 确认故障范围:是误删表、误删数据、还是整个集群挂。
- 选恢复点:从哪个备份恢复(误删前的备份)。
- 恢复:用 clickhouse-backup restore 或 part 拷贝挂回。
- 验证:跑查询确认数据完整、正确。
- 复盘:找根因,补防护(加权限、加确认提示)。
五、容灾规划
备份是基础,容灾更进一步——保证故障时业务能快速恢复:
- 异地备份:备份存到不同地域,防地域级故障。
- 多副本跨机房:副本分布在不同机房,单机房挂还有副本。
- 恢复演练:定期演练恢复,测恢复时间(RTO)和数据点(RPO)。
- 降级方案:极端故障时业务能降级(只读、缓存兜底)。
⚠️ 常见坑:只备份不演练,真出事才发现备份损坏、恢复流程不会操作。定期演练是唯一能保证"备份真有用"的办法——至少每季度做一次恢复演练。
💡 关键直觉:副本防单机故障,备份防误操作和集群级故障,两者不能替代。备份要异地、要演练、要验证,"备份了"不等于"能恢复"。
一节小结
- 副本 ≠ 备份:副本防单机故障,备份防误操作和集群级故障,都要有。
- 三种方式:part 拷贝(手动小表)、clickhouse-backup(生产首选)、S3 冷备(省空间异地)。
- 备份策略:频率、保留、异地存储、定期验证,核心数据每天全备+增量。
- 恢复流程:确认范围 → 选恢复点 → 恢复 → 验证 → 复盘补防护。
- 容灾:异地备份、跨机房副本、定期演练、降级方案,至少每季度演练一次。
下一节讲安全控制——权限、TLS、配额,给集群加护栏。
演练一次完整的恢复
备份的价值在恢复,恢复能力只能靠演练验证。下面是一次最小演练的完整步骤,建议在测试环境按这个流程走一遍:
# 1. 创建备份 clickhouse-backup create daily_$(date +%Y%m%d) # 2. 模拟故障:误删一张表 clickhouse-client --query "DROP TABLE default.events" # 3. 确认误删后从备份恢复 clickhouse-backup restore daily_$(date +%Y%m%d) --table default.events # 4. 验证数据完整 clickhouse-client --query "SELECT count(), max(event_time) FROM default.events"
演练的关键是验证"恢复后数据对不对",而不仅是"恢复命令不报错"。比对备份前的行数、最大值,确认数据完整才叫恢复成功。这类演练建议至少每季度一次,并记录实际花费的时间(RTO 的实测值)。
备份的粒度也值得规划。全库备份简单但耗时长,按表备份灵活。核心表可以每天全备,次要表每周备一次。冷热数据分开处理:热数据高频备份,冷数据靠 S3 上的副本本身就不容易丢。把备份策略和业务重要性对齐,资源花在刀刃上。
最后补一个容易被忽略的细节:备份要验证可读性。clickhouse-backup list 能列出所有备份,clickhouse-backup check 能做完整性检查。把这些检查也做成定时任务,备份体系才算闭环——"备份了"不等于"能恢复",验证过才算数。