1.2 从数据字典到元数据平台:演化脉络
1.2 从数据字典到元数据平台:演化脉络
本节摘要:DataHub 的每个设计决定都不是凭空来的,而是对前两代元数据工具缺陷的回应。本节沿着"数据字典时代、目录时代、平台时代"三代工具的更替,讲清能力跃迁的内在逻辑:采集从手工到自动、覆盖从单系统到全域、模型从写死到可扩展。读完本节,你能看懂 DataHub 架构里那些看似古怪的部件各自在解决什么历史遗留问题。本节承接 1.1 的定位讨论,为 1.4 的选型对比提供历史坐标系。
先讲一段历史
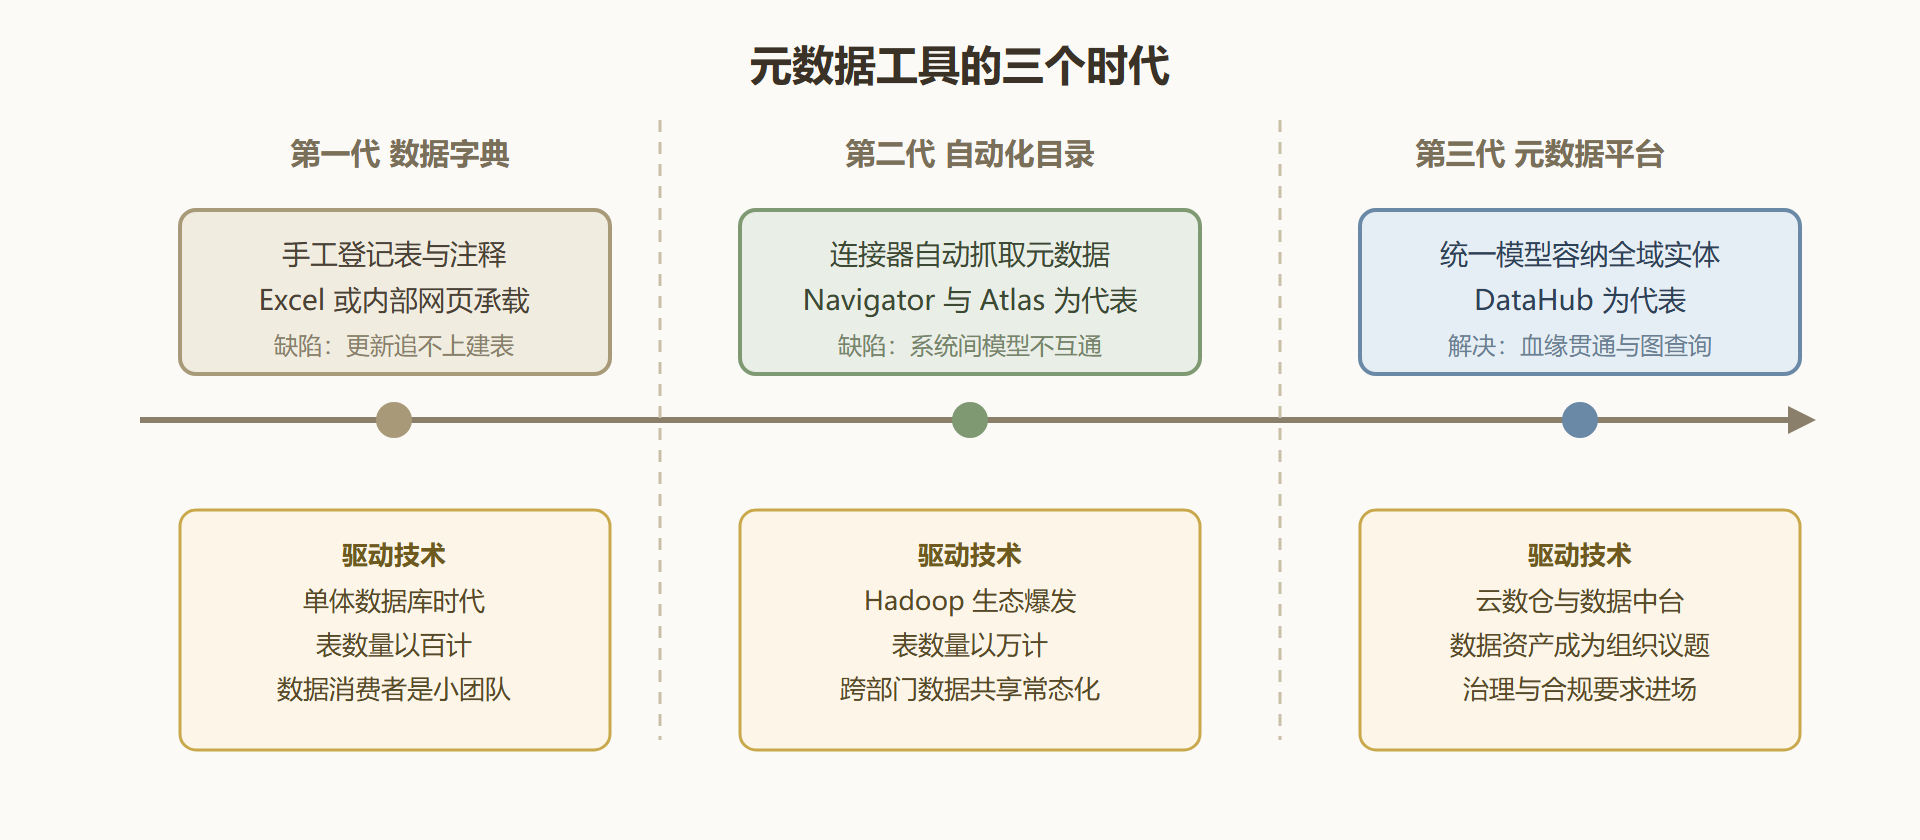
2000 年前后的数据团队,普遍维护着一份"数据字典":一张 Excel 或一个内部网页,登记着每张核心表的名字、负责人和字段说明。那时数据系统屈指可数,一张字典勉强够用。真正的转折出现在 Hadoop 兴起之后:数据湖、数仓分层、实时流、BI 工具在同一组织里并存,表的数量从几百暴涨到几万,手工字典的维护成本瞬间失控——登记速度永远追不上建表速度。
第一代工具就此被淘汰。第二代工具的思路是"自动采集":连上数据系统,把表结构定期抓回来,配上搜索界面,代表产品有 Cloudera Navigator 和 Apache Atlas。自动采集解决了登记速度问题,但很快暴露新缺陷——抓回来的元数据是孤岛式的:Hive 的元数据一套、Spark 的一套、BI 的一套,彼此模型不兼容,血缘断在系统边界上。目录看起来什么都有,实际什么都串不起来。
第三代工具要解决的是"统一":用一个通用元数据模型容纳所有系统,用一张图把所有实体连起来,血缘跨系统贯通。DataHub 正是这一代的代表——它的前身是 LinkedIn 内部的 WhereHows 项目,早期专注于数据集与作业血缘,后来重构为通用元数据架构,以 DataHub 之名开源,逐步演化出实体建模、事件驱动的元数据分发、可插拔接入框架等能力。OpenMetadata、Amundsen 也属于这一代,只是实现路径各异。
图2 元数据工具三代演化时间线
演化背后的三条主线
第一条:采集从手工到自动再到事件化。 字典时代靠人填写,目录时代靠定时抓取,平台时代则把元数据变更当成事件流处理。DataHub 的架构里能清楚看到这条痕迹——它把每一次元数据变化抽象成变更提案,经由消息队列分发,让搜索索引、图存储在变更发生时同步更新。这不是炫技:血缘要求"上游一变、下游立刻知道",批式抓取的延迟撑不起这种时效。
第二条:模型从写死到可扩展。 目录时代的工具通常内置固定模型——表就是表,任务就是任务,想加一个"数据产品"或"特征"实体,得改源码。第三代平台把模型本身做成了可配置资产:DataHub 用 PDL 语言定义实体与 Aspect,业务可以在不改动平台代码的情况下新增实体类型。第 3 章会专门讲这套建模体系,此处只需记住:模型可扩展性是三代工具的分水岭之一。
第三条:消费从"查"到"用"。 字典和目录的交互止步于查询——搜到、点开、看结构。平台时代的元数据要反哺生产环节:调度系统在发布前调血缘接口检查下游影响,质量工具把校验结果写回元数据图,权限系统根据数据分级标签自动收敛访问。元数据从"文档"变成了"基础设施",这是理解 DataHub 为什么强调 API 能力的关键。
💡 判断一个元数据工具属于哪一代,看它对"变更"的处理即可:只能定时全量抓取的是二代,能以事件方式增量传播变更的才是三代。
DataHub 自己的几个关键节点
LinkedIn 内部,WhereHows 项目长期承担数据集与作业的目录和血缘职能,随着公司数据栈复杂化,团队意识到通用性问题无法在旧架构上修补,于是按"元数据即图"的思路重新设计,这就是 DataHub 的起点。开源后,几个节点值得记住:
- 通用元数据架构确立:以元数据服务 GMS 为核心,存储层引入文档库加图库的组合,分别服务属性查询与关系查询。这套"双存储"格局延续至今,第 2 章会展开。
- 变更提案与事件流模型:元数据写入统一走变更提案,经消息队列广播给各索引,奠定了增量同步与解耦扩展的基础。
- 接入框架标准化:统一的连接器框架把"从各类系统采集元数据"变成声明式配置加可插拔代码,社区由此快速积累了大量数据源支持,这正是第 4 章的主题。
这段历史对选型的启示很直接:看一个平台是否成熟,别只数功能列表,看它是否完成了"事件化采集、可扩展模型、API 化消费"这三关。缺任何一关,规模化使用后都会撞上对应的天花板。
三代工具在一家组织里的遗迹
历史不是干净利落地换代,而是层层叠压。今天走进多数组织,三代工具的遗迹同时可见:某个业务组还维护着一份没人敢删的 Excel 字典,那是第一代;三年前部署的一套自动扫描工具定时抓着库表结构,但血缘一片空白,那是第二代的遗产;刚立项的元数据平台是第三代。认清这些遗迹有两个用处。
其一,迁移策略。老字典里沉淀的字段注释与业务口径是资产,别让它烂在共享盘里——把字典内容批量回填到平台的描述与术语表,是接入初期内容运营最划算的一笔进货。老扫描工具则可以在新平台覆盖同等范围后光荣退役,避免两套目录并存时"以谁为准"的口径之争。
其二,沟通话术。向维护老字典的团队介绍新平台时,别说"这个会取代你的 Excel",要说"你的字典内容会被搬进一个所有人都能搜到的地方,署名还是你"。三代工具的更替在技术上是进化,在组织上是谈判——1.3 节的三本账就是为这场谈判准备的。
用演化主线给新功能定标
三条主线的另一个用法常被忽略:给眼花缭乱的新功能定标。社区每隔一阵就会冒出新概念——大模型自动生成描述、语义层、主动元数据——值不值得跟进?拿三条主线量一量就心里有数。
大模型生成描述,本质是采集自动化主线向内容生产的延伸,评估标准与任何采集机制相同:生成的描述进不进事件流、可不可追溯、错了能不能修正,而不是"生成的文字像不像人写的"。主动元数据,则是消费主线从"人查"走向"系统推"的正式化,判断它是否真价值,看它能不能在变更发生的时刻触发下游动作,而非又一套定时报表。语义层与业务术语表的结合点在模型主线:口径定义能否以受控模型的形式进入平台并被血缘引用。
这套定标法的好处是让你免于追新焦虑:符合主线方向的新能力值得小成本试点,与三条主线无关的炫技特性,等它长出主线位置再说。历史不会重复它的细节,但主线相当可靠。
把本节放进更长的时间轴看,还有一层意义:当新同事问“为什么平台要这样设计”时,三代演化的故事比任何架构图都好懂。历史解释现在,也预支了未来的容忍度——知道每代工具死于什么的人,对现役平台的取舍会多一分公道。
一句话收束本节:把三代史当工具书用——判断新平台看主线,评估旧资产看年代,安排迁移看缝隙。
本节要点回顾
- 三代更替:手工字典、自动化目录、元数据平台,分别败于更新速度、模型孤岛,最终统一于图模型平台。
- 主线一:元数据采集从手工到批式抓取再到事件化传播,血缘时效性是关键驱动。
- 主线二:元数据模型从平台内置到业务可扩展,PDL 建模是 DataHub 的分水岭能力。
- 主线三:元数据消费从人查文档变成系统调接口,元数据升级为数据基础设施。
- 选型启示:用"事件化、可扩展、API 化"三关检验任何元数据平台的成熟度。
下一步我们把镜头对准人:同一张数据地图,工程师、治理负责人、分析师各自能从中拿到什么,阻力又会在哪。