2.1 整体架构:从GMS到存储层
2.1 整体架构:从GMS到存储层
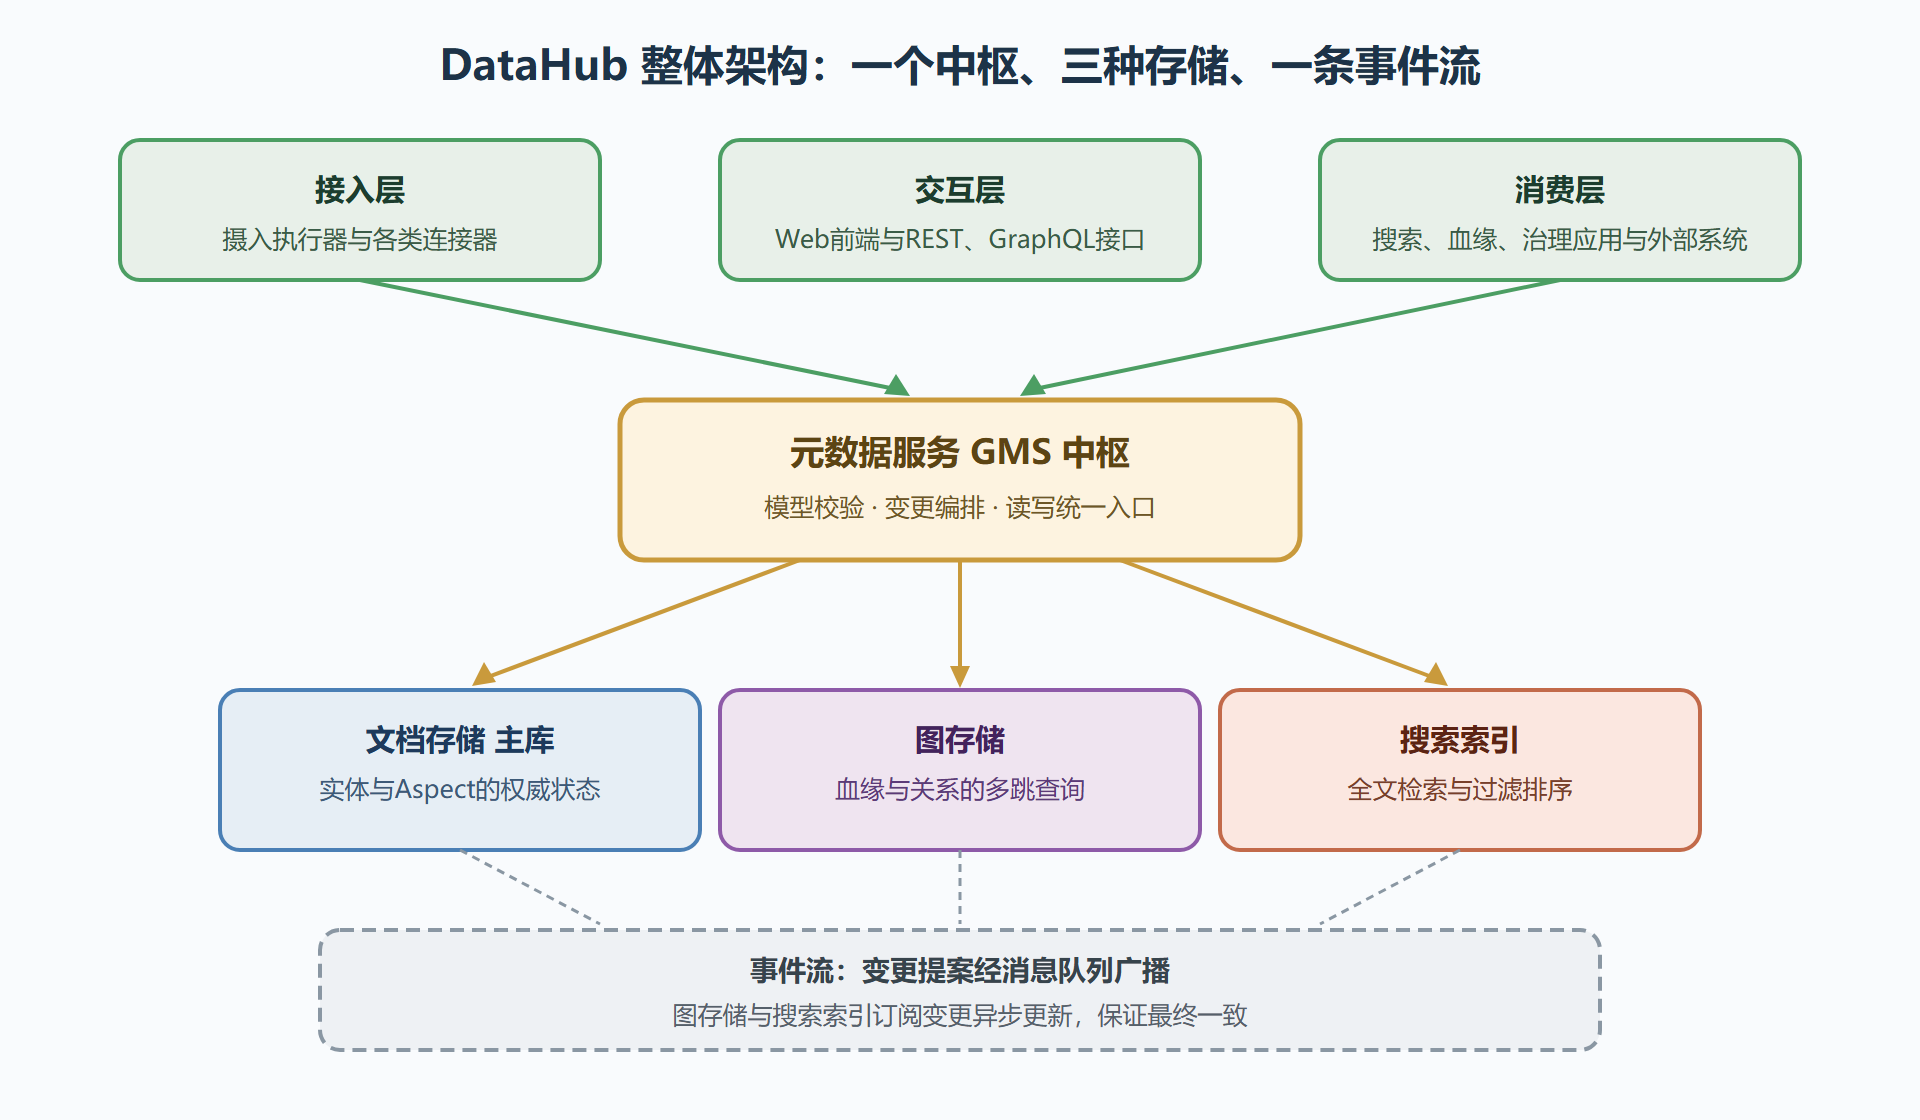
本节摘要:DataHub 的整体架构可以概括为"一个中枢、三种存储、一条事件流":元数据服务 GMS 是唯一的主存储写入者,文档库、图库、搜索索引分别服务属性查询、关系查询与全文检索,所有变更经由消息队列广播保持最终一致。本节自顶向下拆解分层结构,解释每个设计选择背后的查询负载假设。本节承接第 1 章的选型结论,为 2.2 的组件剖析与 6.2 的扩容调优提供结构底图。
先给架构定个性
给 DataHub 的架构定性,最贴切的说法是"读写分离的元数据仓库加多视图索引"。它不像业务系统那样有复杂的事务逻辑,它面对的是三类负载特征迥异的查询:按实体找属性(这张表有哪些字段)、按关系找邻居(这张表的下游是谁)、按关键词找实体(搜"订单"相关的表)。没有任何单一存储引擎能同时把三类查询做到最优,所以 DataHub 的架构答案很干脆——用同一份逻辑数据,建三种物理视图,各答各的题。
理解了这个出发点,整个架构图就不再需要死记:凡是属性查询走文档库,凡是关系查询走图库,凡是模糊检索走搜索索引,而让三份数据保持同步的机制,就是贯穿全章的事件流。
图5 DataHub整体架构分层图
GMS:唯一的写入中枢
元数据服务 GMS 是整个平台的宪法法院:任何写入——不管来自摄入执行器、界面操作还是 API 调用——都必须经过它,由它完成三件事。
校验。写入内容必须符合已注册的元数据模型。你无法往一张表实体上挂一个平台不认识的属性,这条铁律保证了平台内元数据的语法一致性,也是第 3 章 PDL 建模的意义所在:先在模型层定义"什么是合法",GMS 才能在运行时把关。
编排。一次写入往往牵动多个下游:主存储要更新,图存储的血缘边要重建,搜索索引要刷新。GMS 不自己干完所有事,它把变更写进主存储,然后把变更事件发布到消息队列,让关心变更的组件各自消费。这个编排决定让 GMS 保持轻量,也让系统获得横向扩展的余地。
仲裁。并发写入同一实体时,GMS 按语义决定合并策略:有的 Aspect 是整体覆盖,有的支持按项合并。理解这一点对排查"为什么我的字段描述被覆盖了"这类问题至关重要——那不是 bug,是覆盖语义在起作用,正确做法是改用局部更新接口。
三种存储:各答各的题
文档库(主存储)。权威状态存放处,通常用关系型数据库承载。实体与 Aspect 以文档形式存储,按主键检索极快。所有"点开详情页看到的内容"最终都源于这里。它是唯一的事实来源,其余两种存储都是它的派生视图——这一点在灾难恢复时尤其重要:图库和索引坏了可以全量重建,主库坏了就是真丢了。
图存储。血缘与关系的多跳查询专用。搜索某个实体的二度、三度下游,用文档库要一层层递归查,图库则是原生操作。节点是实体,边是关系,边可以携带属性(比如血缘的查询来源)。图库的选型经历过演进,理解"图库是可重建的派生数据"这一点,能让运维心态放松很多——第 6 章讲扩容时会复用这个结论。
搜索索引。全文检索与过滤排序的家。前端的搜索框、按平台过滤、按热度排序,背后都是它。搜索索引的另一个隐藏职责是"列表页加速":浏览某个域下所有数据集这类操作,实际走的是索引查询而非主库翻表。
| 存储类型 | 承载内容 | 服务场景 | 损坏后的恢复方式 |
|---|---|---|---|
| 文档主库 | 实体与 Aspect 权威状态 | 详情页、精确读取 | 不可重建,需备份 |
| 图存储 | 节点关系与血缘边 | 多跳血缘、影响分析 | 可从主库与事件重放重建 |
| 搜索索引 | 倒排索引与排序字段 | 全文搜索、过滤列表 | 可从主库全量重建 |
前端与接入层的位置
前端服务是浏览器与平台之间的门面:处理会话、聚合 GMS 的多次调用、把图查询结果整形成界面需要的数据形状。它本身不存业务状态,所以前端服务的扩容是无状态的横向堆机器。
接入层在架构图里是"摄入执行器加连接器",严格说它不是平台常驻组件,而是围绕平台的客户端程序:它可以部署在任何地方,把采集到的元数据以变更提案的形式推给平台。这个松耦合设计意味着接入层的故障不会拖垮平台本体——摄入挂了,地图只是不再更新,已入库的元数据照常可查。这也是排错时的第一个分界线:问题出在"数据没进来"还是"进来查不到",两者走的是完全不同的排查路径(4.4 节会系统展开)。
⚠️ 新手最常见的架构误解是以为前端服务里藏着业务逻辑,于是排错时拼命查前端日志。记住分层:前端只做聚合与整形,元数据的对错一律找 GMS,查询结果的全不全找搜索与图库。
一次扩容预演:从架构图推导动作
架构图学没学会,测一测就知道:假设某天用户量翻倍、摄入源从五个涨到十五个,扩容动作按什么顺序做?带着这个问题回看分层,答案可以从结构里推出来。
前端变慢(界面点开详情卡顿):无状态服务,直接加副本,零副作用——第一层扩容永远最便宜。摄入变慢或 GMS 写入报超时:先别加 GMS 副本,它身后的主库连接池可能已经吃紧,加副本反而加剧争抢;正确动作是给摄入限流并检查主库连接水位。搜索新数据迟到:这不是存储不够,是事件链路的消费者消化不动——扩消费者副本或提升其并行度。搜索整体变慢:才轮到搜索索引加节点。多跳血缘查询变慢:图库升配。
你会发现每个动作都能从"哪类查询走哪个存储、哪段链路是异步的"推出来。这正是本章反复强调架构认知的原因:运维动作不是背出来的,是从结构里读出来的。6.2 节会把这套推导展开成正式的决策表,此处先建立直觉。
负载的脾气:读多写少、写有尖峰
规划容量前还要知道这套系统的负载形状。它是典型的读多写少系统:查询占比常年九成以上,写入则由摄入节奏决定——十几个源在凌晨集中跑定时任务时,写入会出现尖峰;白天业务时段写入平缓,读取随用户活跃起伏。
这个形状有两个工程推论。第一,写入尖峰不需要为它常态扩容:消息队列天然是削峰的缓冲,尖峰被队列吸收后由消费者按自己的节奏消化,代价只是新元数据可见的延迟从秒级滑到分钟级——对元数据场景完全可接受。第二,读取侧的容量按白天峰值规划即可,且前端与 GMS 的无状态副本可以配合工作时段弹性伸缩,夜间缩容。第 6 章的容量规划会反复用到这两个推论。
还有一条负空间的推论:这套架构里没有为高并发写入做优化的部件,也无需为此自责。元数据的写入频率天然受限——表的创建与变更远没有订单业务那样高频。评审任何针对"写入吞吐"的深度改造方案前,先确认瓶颈真的在写入侧:多数时候,凌晨的写入尖峰只是队列积压的正常呼吸。
读完本节,不妨做个自测:合上材料画出三存储与 GMS 的关系图,并标注每类查询的走向。画不出来的部分,就是回读的地图——架构章的学习成果,从来以“能否重构”而非“能否复述”计量。
本节要点回顾
- 架构定性:三类查询负载(属性、关系、全文)决定了一份数据建三种物理视图的格局。
- GMS 三职责:校验模型合法性、编排多存储写入、仲裁并发覆盖语义,它是唯一写入中枢。
- 主库地位:文档库是唯一事实来源,图库与索引是可重建的派生视图,备份策略据此分级。
- 前端无状态:只做聚合与整形,扩容即堆机器;元数据对错找 GMS,查询结果找索引。
- 接入松耦合:摄入执行器是平台外客户端,摄入故障只影响更新不影响查询。
架构有了骨架,下一节把关键组件逐个拆开——它们各自的接口契约与协作方式,是后续所有排错动作的部件手册。