2.3 元数据的数据流:写入与查询
2.3 元数据的数据流:写入与查询
本节摘要:本节沿一条元数据变更的完整生命周期走通写入链路——变更提案、消息队列、GMS 落库、变更日志广播、索引消费者更新——再走通查询链路,说明读请求如何在前端、搜索服务、图服务与 GMS 之间分配。读罢你应能对"元数据从提交到可搜"给出精确到组件的叙述,并能解释链路上每一处延迟与丢失的表现形式。本节把 2.2 的静态部件变成动态过程,为 4.4 排错与 6.4 监控提供时序依据。
一条描述的旅程
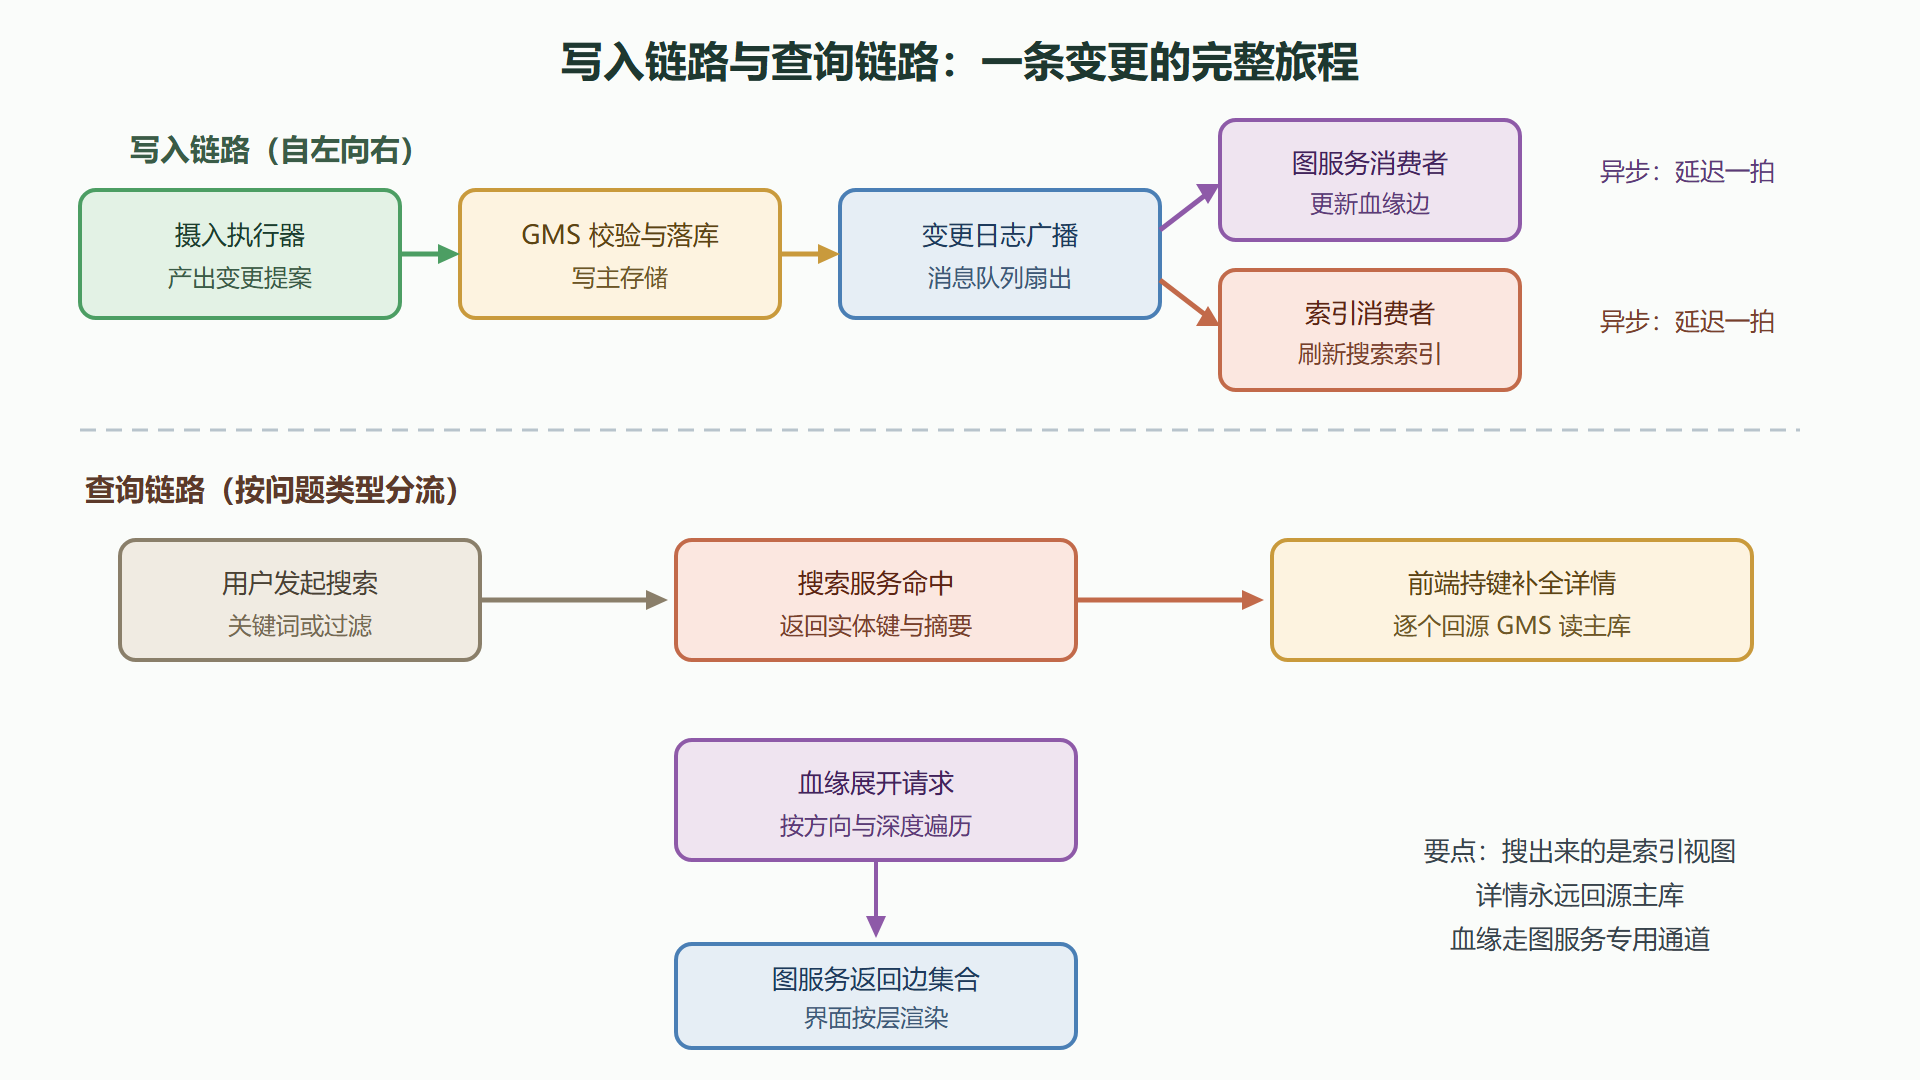
把抽象组件串起来的最好办法是跟踪一个具体变更。假设数据治理员在界面上把一张核心表的负责人从 A 团队改成 B 团队。这个点击在毫秒级触发了下面这串动作:前端把它组装成一个变更提案发往 GMS;GMS 校验提案合法性,写入主存储;GMS 同时发布一条变更日志事件到消息队列;图服务与搜索索引的消费者各领到这条事件,分别更新自己负责的视图。几十毫秒后详情页已显示新负责人,而搜索结果里这张表的负责人卡片可能还要再等一拍。
这条旅程里有两个容易混淆的概念需要先钉死。变更提案是请求方提交的"我想改成这样",它是入口处的意图表达;变更日志是 GMS 处理后广播的"实际变成了这样",它是下游视图的更新依据。区分二者有一个立刻能用的推论:摄入端的问题看提案有没有发出去、发得对不对;平台端的问题看日志有没有消费、消费得快不快。
图7 一次元数据变更的写入与查询链路
写入链路逐站细看
第一站:提案生成与投递。 摄入执行器或界面把变更包装成提案投出。这里最常见的故障是提案根本没出门——网络不通、认证失败、目标服务地址配错。判断特征很直接:GMS 的访问日志里完全没有对应记录,说明请求死在了路上;有记录且带校验错误,说明到了但被拒收。两种情况修法不同,前者查连接与凭证,后者改提案内容。
第二站:校验与落主库。 GMS 校验通过后写入主存储,这一步之后数据就是"官方"的了——详情页立即可见。主库写入失败的典型原因是连接池耗尽或存储容量告警,症状是 GMS 返回超时,同时界面上大量操作一起变慢。它也是链路里唯一不能异步的一步:主库没写进去,后面一切都免谈。
第三站:变更日志与异步扇出。 GMS 把变更日志发进消息队列,图与索引的消费者分头认领。这一站是"最终一致"的发生地:消费者正常时延迟以秒计;消费者宕机时延迟随积压增长;消息意外丢失时会永久不一致,需要重放修复。6.4 节的监控指标里,消费积压深度是这一站健康度的核心读数。
批量摄入时,链路上发生了什么
日常的单条变更走不完链路的全部风景,批量摄入可以。凌晨两点,十五个源的定时摄入同时启动,每秒成百上千条变更提案涌向 GMS。此刻链路上依次发生:GMS 的校验与落库压力陡增,主库连接池吃紧;变更日志在消息队列里堆积,消费者以自己的最大速率消化;搜索索引的写入缓冲排起长队。
链路的设计让这场洪峰不致失控——但前提是你理解三个参数的含义。摄入端的批量与并发:执行器把工作单元攒批发送,批太大单条失败牵连整批重试,批太小吞吐不足;并发数决定了对 GMS 与源系统的同时压力,默认值通常保守,全量接入前值得显式调优。队列的保留时长:变更事件在队列里的留存时间必须大于"最长故障修复时间"——消费者停机检修四小时,队列只留两小时事件,那两小时的变更就永久丢了,只能全量重建。消费者的处理速率:它是整条链路的节流阀,洪峰场景下宁可摄入慢一点,也别让消费者带着无限积压硬扛。
如果你在 6.4 的看板上看到"凌晨积压尖峰、上午归零"的曲线,那就是这三个参数协同工作的日常景象。曲线形状突变——尖峰变高、归零变晚——才是需要介入的信号。
查询链路:三种问题三条路
查询侧的关键设计是按问题类型分流。关键词搜索与过滤列表走搜索服务——它返回的是实体键加摘要的轻量列表;点开详情时,前端拿着实体键回源 GMS 读主库的权威状态;血缘展开走图服务的专用遍历接口。三条路各司其职,也各自继承所属存储的延迟特征:搜索可能滞后一拍,详情永远是新的,血缘偶有缺边。
这个分流设计解释了几个界面上的"怪现象"。搜索计数与详情列表数对不上,因为前者是索引视图、后者是权威状态;刚发布的表搜索不到,但用完整名称能直达详情——直达走的是主库精确读取,绕过了索引;血缘图上个别边闪现闪失,多半是图索引的异步更新与主库写入的时间差。理解了三条路,这些现象从 bug 变成了架构的呼吸。
三条路的延迟特征也值得整理成一张随身卡片:搜索结果允许分钟级陈旧(索引异步刷新),详情页要求秒级新鲜(主库同步读),血缘介于两者之间(图边同步写一份、异步核一份)。给外部系统做集成设计时直接引用这套口径——问"血缘查询的数据最多旧多久",答案从架构而非拍脑袋里来。
三个高频追问
问:变更事件在队列里丢了怎么办? 罕见但存在。表现是主库与索引永久不一致、积压为零。修复靠重放:从主库读出该实体的最新状态,重新提交一次写入,事件链路随之补齐。平台通常提供按实体重放的运维入口;没有的话,用 2.4 的 REST 接口手工提交一次覆盖写等效。一致性抽样告警(6.4)抓的就是这类静默丢失。
问:为什么不让索引与主库同步双写,彻底消除延迟? 同步双写把主库写入的可用性与索引的可用性焊在一起:索引抖一下,写入就要失败。异步扇出用"可容忍的秒级延迟"换"写入路径的稳定",这笔交易对元数据场景是划算的——详情页的新鲜由主库同步读保证,搜索晚一拍无人在意。
问:能否绕过 GMS 直接写图库或索引? 技术上或许可行,工程上绝对禁止。绕过校验的写入会让非法结构污染派生视图,且主库没有对应记录——重建视图时这些"幽灵数据"会被静默清洗,你的写入凭空蒸发。GMS 是唯一的写入中枢,这条规则没有例外。
一个手工写入的对照实验
想真正吃透链路,做个两分钟的小实验。用接口手工提交一个字段描述的变更提案,成功后立刻搜索该字段:大概率搜不到新描述,而详情页已经是新文案。再等几秒刷新搜索,新描述出现。这个"先详情后搜索"的时间差,就是异步扇出的直观证据。动手试一次,胜过重读本节三遍。
💡 排错时给自己立一条分界铁律:数据不对找写入链路,数据不全找消费积压,数据查不到先分清"搜不到"还是"取不到"——三个短语对应三段链路,开口报障时说清是哪种,能省掉半个来回。
链路理解的最终检验在表达:能否用一分钟向新人讲清“一条描述从提交到可搜”的全过程,中间每站在哪个组件、哪一步允许延迟。讲不清的地方,就是理解还没有长出来的地方。
写完链路再看监控,你会发现 6.4 的每个指标都是链路上某一站的读数——指标不是清单,是链路的影子。
本节要点回顾
- 两个概念:变更提案是入口意图,变更日志是落库后的事实广播,排错时先分清在说哪个。
- 写入三站:提案投递、校验落库、异步扇出;主库写入是唯一同步步骤,其余允许最终一致。
- 查询分流:搜索走索引、详情回源主库、血缘走图服务,三种问题三条路各带各的延迟特征。
- 不一致三型:秒级滞后属正常、积压型滞后看消费者、永久不一致靠重放修。
- 对照实验:手工提交一次变更观察"详情先新、搜索后新",链路理解立刻落地。
数据流看通了,还剩最后一扇门:外部使用者怎么打开这扇门——下一节讲 REST 与 GraphQL 两套 API 的分工与用法。