4.1 摄入体系:pull与push两种模式
4.1 摄入体系:pull与push两种模式
本节摘要:元数据进入平台只有两条路:平台主动去抓(pull),或源系统主动来推(push)。本节讲清两种模式的机制差异、各自的最佳适用场景,以及真实项目里"pull 打底、push 补时效"的组合策略。这是接入工作的顶层设计——模式选错,后面每一节都会更费力。本节承接第 3 章的模型准备,是 4.2 连接器实操与 4.3 自定义开发的路线图。
两种模式的机制差异
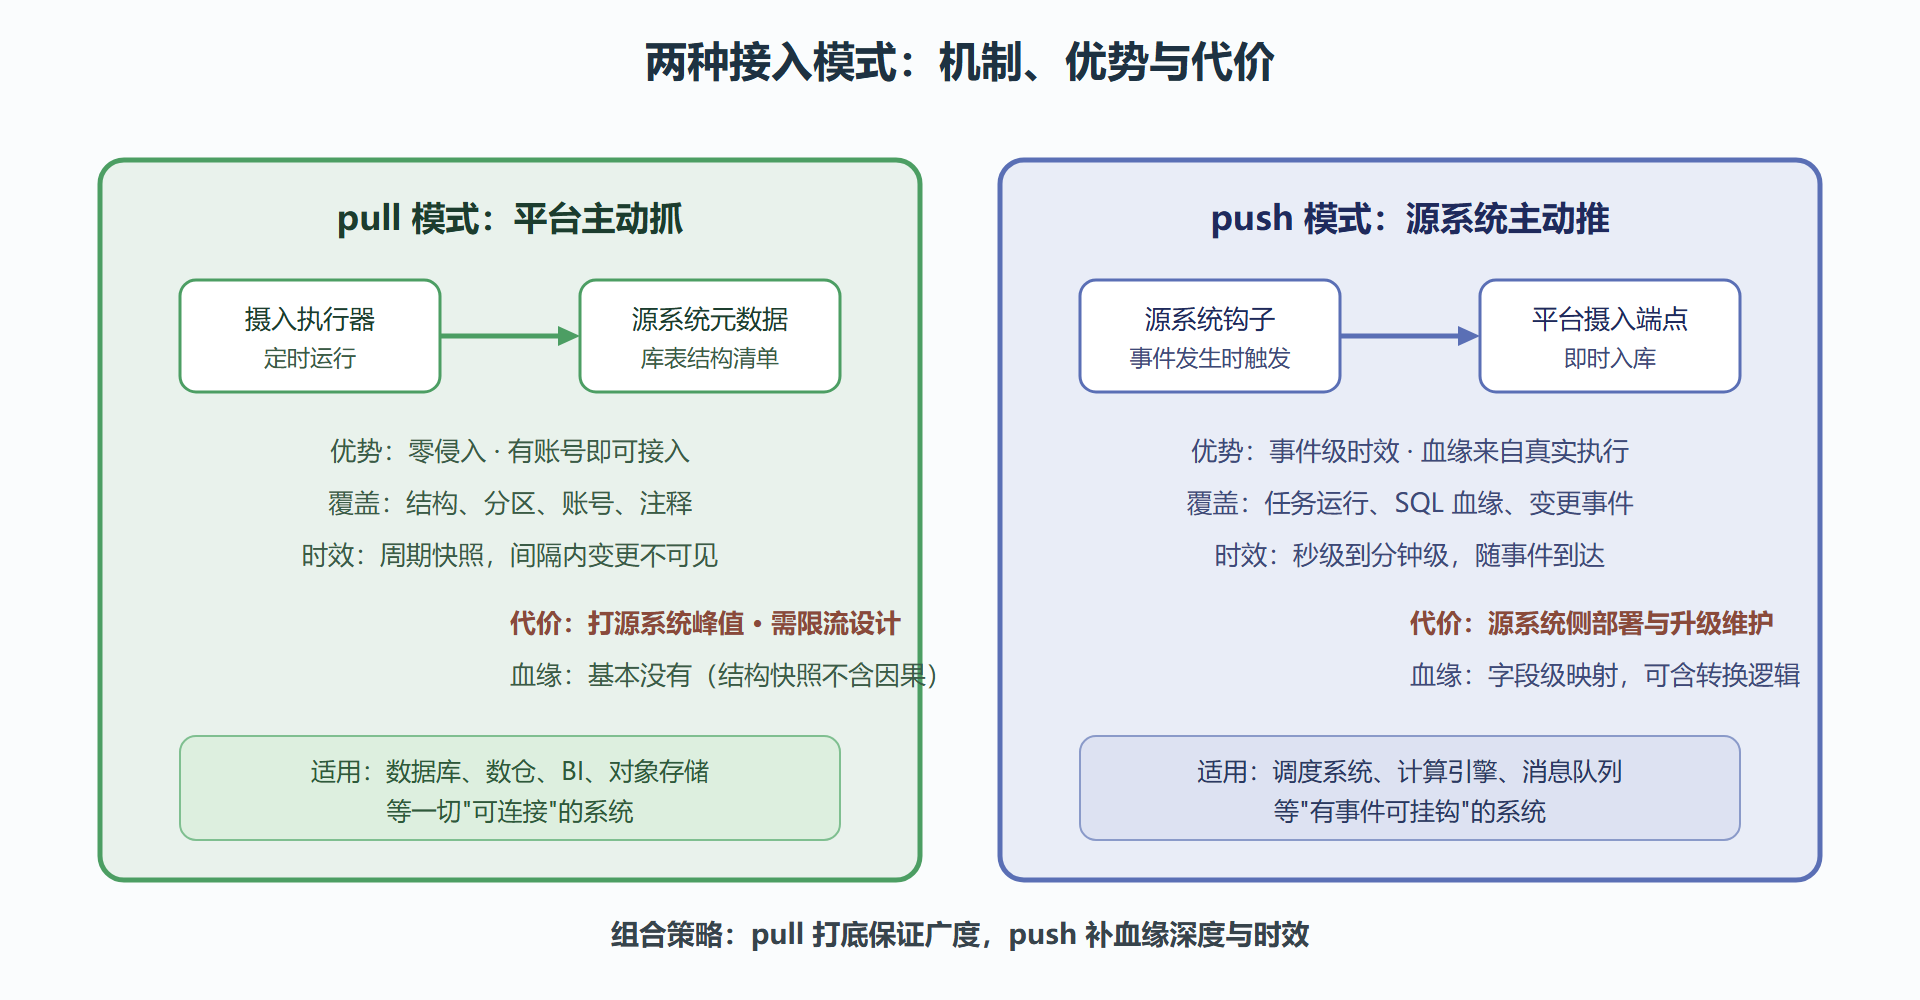
pull 模式里,摄入执行器是主动方:按计划周期运行,通过源系统的管理接口或元数据库读取库表结构、分区信息、账户清单,转换成平台模型后推送入库。它的优势是对源系统零侵入——不需要在源系统装任何东西,只要有连接权限就能干活;劣势是快照性质:两次运行之间的变更,地图上是看不见的。
push 模式里,源系统是主动方:调度系统在任务完成时推一条运行记录,计算引擎在 SQL 执行时钩一下解析出输入输出表。它的优势是事件级时效与天然血缘——血缘来自实际执行过的语句,而不是猜出来的;劣势是要在源系统侧部署插件或改造,对源系统有侵入,覆盖范围取决于哪些系统愿意配合。
一句话记住分工:**pull 负责广度,push 负责深度与时效。**结构、清单、账号这类慢变量交给 pull;血缘、运行状态这类快变量交给 push。
图11 pull与push模式的机制对比
pull 模式的三个工程细节
**周期与限流。**pull 是对源系统的周期性"体检",执行器会在短时间拉取大量元数据。对生产库做全量拉取可能挤占业务连接,务必给摄入配置并发与批量上限,并把运行窗口安排在业务低峰。经验值:数百张表的库分钟级可完成;上万张表的数仓实例,建议开启增量过滤(只抓取元数据有变动的库)并拆分多个任务分批跑。
**凭证最小化。**摄入账号只需要读元数据的权限——数据库的元数据视图、BI 工具的只读接口。用管理员账号跑摄入是常见的越权坏味道,一旦摄入框架或配置泄露,风险面不可控。给摄入单独开账号,权限恰好够读元数据,是底线要求。
**结构快照用覆盖语义。**连接器抓回的结构是源系统的全量快照,按 3.2 的口诀应走覆盖语义写入。这意味着:人工在平台上补的表描述,可能被下一次摄入覆盖回去。成熟的处理方式是"描述分区管理"——源系统里维护的注释走覆盖,平台内人工增补的描述存放在独立 Aspect,两边互不侵犯。发现"人工描述莫名消失"时,先查是不是这个语义冲突。
push 模式的两个部署要点
**钩子放哪。**调度系统的钩子通常以插件形式安装在调度服务上,任务完成事件触发时组装运行记录推送给平台;计算引擎的钩子则挂在执行链路上,SQL 提交时解析语句并抽取输入输出表。钩子的版本要跟随源系统升级一起维护——调度系统大版本升级后钩子静默失效,是血缘断流的最常见原因,4.4 排错实录里有它的完整案例。
**失败的兜底。**推送失败不能影响源系统本职工作,这是钩子设计的铁律:推送超时要短、失败要吞掉并记录,宁可丢一条事件也不拖死调度任务。代价是推送链路可能静默丢数据,所以 push 模式必须配对账机制——定期比对"源系统实际任务数"与"平台收到的运行记录数",缺口超过阈值就告警。丢的血缘可以靠 pull 侧的 SQL 解析兜底补齐。
组合策略:一张接入栈蓝图
真实项目的接入栈几乎都是组合拳。一个典型配置:核心数仓与 MySQL 用 pull 定时抓结构;调度系统装钩子推任务级血缘;分析引擎装钩子推字段级血缘;BI 工具用 pull 拉报表与依赖关系。这样配置后,结构数据每天更新一次,血缘准实时到达,覆盖了"改字段前查影响"的全部时效需求。
优先级建议:如果人力只够做一件事,先做核心数仓的 pull——它一次性让地图上有了全量地标,项目立刻可见效;如果只能再加一件,给调度系统装 push 钩子——血缘是平台价值的放大器,任务血缘的血缘图一出来,管理层的观感会立刻不同。
⚠️ 不要被"接入越多源越好"的口号带着跑。接入一个源就要长期维护一个连接配置与一份凭证,接入栈的规模就是你的长期负债。按 1.3 节的三本账,先接痛的,再接多的。
定时化:把摄入当数据管道来运维
摄入任务跑通一次不难,难的是它以正确的节奏常年跑着。定时化阶段有三个运维决策要做。
节奏按源定,不搞一刀切。 核心数仓的结构一天一更足够——表结构本来就不是高频变更物;账号与权限清单一周一更也够;而 push 侧的任务血缘没有节奏概念,它跟事件走。把每个源的节奏写进配置注释,下一任维护者就不用重新推导一遍"为什么这个源是每周日跑"。
错峰编排。 十几个源的摄入全堆在凌晨零点,等于自己制造洪峰:源系统在低峰期被集中扫描、平台的事件链路在凌晨拥塞。按源系统的重要度错开窗口,核心源放在它业务低峰的最前端,边缘源散落在后半夜。编排逻辑用任何调度平台实现都行,关键是摄入任务之间有先后依赖声明,而不是各自为政的定时器。
配置即资产。 每个源的配置文件进版本库、变更走评审,搭配 4.2 的对账告警,构成接入栈的完整运维形态。判断定时化做没做到位,有个朴素标准:新同事接手时,能否只看版本库就把"哪个源、什么节奏、覆盖什么、出了事找谁"回答全。答不全,说明配置还散落在某台机器的某个目录里。
混合模式下的两个衔接问题
pull 与 push 同栈运行后,有两个衔接缝隙值得提前堵上。
血缘先到、结构未入库。 push 钩子在任务完成瞬间推送血缘,而血缘指向的两张表可能还没被 pull 扫过——尤其新表刚上线的那几天。平台的处理方式是先按 URN 创建"骨架实体"(只有身份没有属性),等 pull 的结构快照到达后再补全。这解释了一个界面现象:偶尔能看到"有血缘关系但详情页内容很薄"的实体,它们不是数据损坏,是时序差的临时形态。要缩短这个窗口,把新表密集的库纳入 pull 的高频清单即可。
覆盖快照与人工修补的优先级。 结构走覆盖语义后,"人工在平台上改的字段描述"与"源系统的注释"同处一个包里的风险在 4.1 开头已经讲过;混栈场景下还有一层:push 的 SQL 解析也会回填字段级映射,若与 pull 的结构快照相差太久(比如快照落后源系统一周),映射会指向已经不存在的旧字段。对应对策是给结构快照定一条时效红线——超过红线未更新就告警(6.4 新鲜度告警的配置项),让快照的陈旧变成可见状态而非潜伏病灶。
把本节的模式决策写成一行备忘贴在接入文档首页:结构靠 pull 的勤奋,血缘靠 push 的敏捷,两者相遇时以结构快照补全骨架、以事件血缘标注因果。接入栈的一切配置争议,几乎都能回到这句话上裁决。
本节要点回顾
- 模式分工:pull 零侵入管广度(结构与清单),push 事件级管深度与时效(血缘与运行状态)。
- pull 三细节:限流加低峰窗口、凭证最小化、结构快照覆盖语义并注意与人工描述的分区。
- push 两要点:钩子随源系统升级维护、推送失败吞掉并靠对账补漏。
- 组合蓝图:数仓 pull 结构、调度与引擎 push 血缘、BI pull 报表依赖,四源成栈。
- 优先级:先核心数仓 pull 让地图可见,再调度钩子让血缘可见,克制扩张节奏。
顶层设计定了,下一节进入标准动作:用官方连接器把一个 MySQL 的元数据真正接入,让搜索里出现你的第一张表。