1.1 dbt 是什么:定义、价值主张与适用边界
1.1 dbt 是什么:定义、价值主张与适用边界
本节摘要:dbt(data build tool)是一个运行在数据仓库之上的转换层工具:分析师和工程师把清洗、加工、建模逻辑写成带依赖声明的 SQL 文件,dbt 负责把这些文件编译成纯 SQL、按依赖关系排好执行顺序、跑进仓库并完成测试与文档生成。它接管 ELT 流程中的 T(Transform),不碰数据抽取与加载,也不做实时流处理。本节给出它的准确定义、四项核心价值,以及三条必须提前知道的边界。
一句话定义与来龙去脉
工地上动工之前,先要弄清这台机器是干什么的。dbt 的定义可以压缩成一句话:它是一个把 SQL 转换逻辑当作代码来管理的命令行工具与协作框架,运行在你的数据仓库之上,负责「转换」这一个环节。
这个定位是从数据流程的分工里切出来的。一条完整的数据链路分三段:先把数据从业务系统搬出来(Extract),装进仓库(Load),然后在仓库里完成清洗、拼装、聚合(Transform),最后交给报表和应用消费。dbt 只做第三段。在 ELT 这个词里,E 和 L 由 Fivetran、Airbyte 这类同步工具或者团队自建的采集管道负责,T 才是 dbt 的地盘。
dbt 2016 年前后开源,最初只是解决一个很具体的痛点:SQL 没法模块化,一段复杂查询里同样的 JOIN 逻辑要抄来抄去,改一处就得全局搜索所有引用它的脚本。它借用了网页模板领域成熟的 Jinja 语法,给 SQL 加上了「引用另一个模型」的能力——你写一个函数调用代替硬编码的表名,工具在编译期把引用解析成真实的表名,顺便把「谁依赖谁」记了下来。依赖被记录之后,拓扑排序、按序执行、影响分析、血缘图,全都是从这棵依赖树上自然长出来的能力。理解了这个起点,你会发现 dbt 的所有功能都围绕同一件事:让依赖关系从人脑里搬到代码里。
四项核心价值,一项比一项实在
第一,依赖显式化。 传统脚本靠注释和口口相传记录「先跑 A 再跑 B」,dbt 里每个模型在 SQL 中写明自己引用了哪些上游,编译期就能生成完整的 DAG(有向无环图)。执行顺序由工具算出来,不用人排。
第二,逻辑版本化。 所有模型文件住在一个 Git 仓库里,谁改的、为什么改、改了哪几行,提交历史说得清清楚楚。出问题可以回滚到任何一个历史版本——这在存储过程时代几乎不可想象。
第三,质量可验证。 dbt 内置了一套测试机制:主键是否唯一、字段是否为空、枚举值是否在合法范围内,写成几行配置就能在每次构建时自动检查。数据测试不再是「上线前人肉点一点」,而是流水线上的固定工序。
第四,文档与血缘自动生成。 模型的描述写在配置文件里,紧跟代码更新;一条命令可以渲染出整个项目的文档站点,包括每张表的上游来源和下游去向。新人接手时不再需要「找老员工问三天」。
这四项价值串起来,指向同一个变化:转换逻辑从「散落的脚本」变成「有结构、有验收、有图纸的工程」。 这本教程把 dbt 项目比作一次施工,正是因为这套工作方式和建筑工程的分工逻辑高度同构——图纸(模型设计)、材料(上游数据)、工序(分层与物化)、验收(测试)、竣工图(文档与血缘),一一对应。
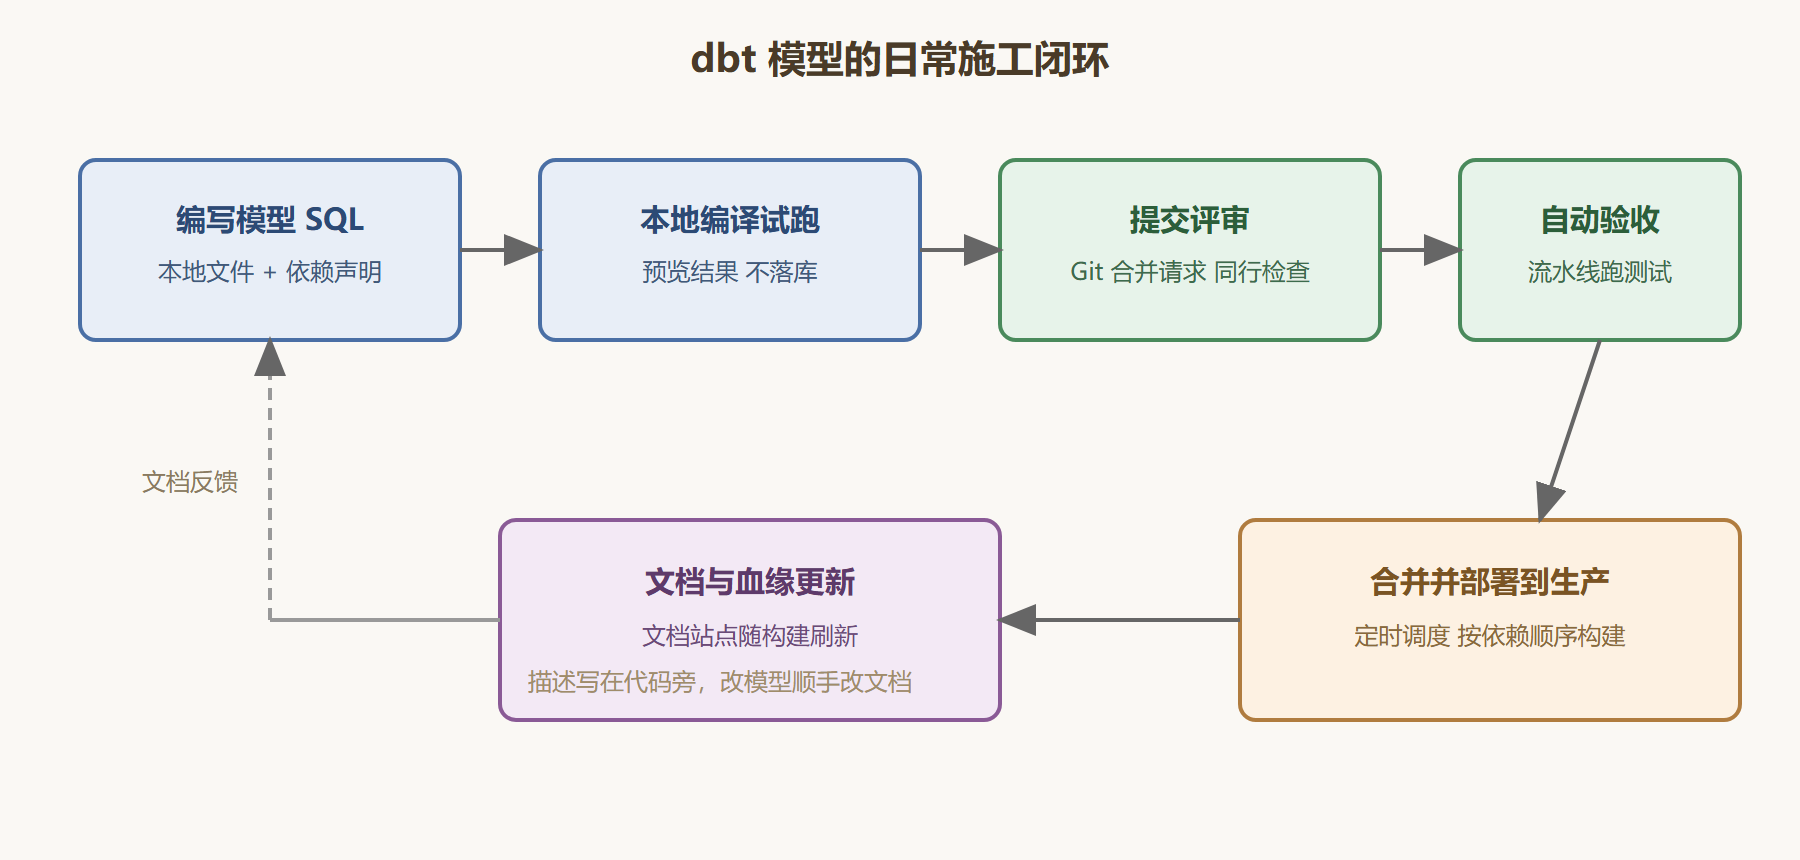
图:一个 dbt 模型从编写到生效的闭环
一个真实的场景:口径变更引发的连锁反应
背景是这样的:某电商团队一直把「营收」定义为下单金额,运营侧某天决定口径改为「支付完成的金额」,因为大量订单下单后未支付,之前看到的营收虚高。这是数据工作中最普通的一类需求,也是最容易出事故的一类。
在改造前的环境里,这个团队的营收逻辑抄在了至少七个地方:三张下游视图、两个存储过程、一个 BI 工具里的计算字段、还有一份定时导出报表的脚本。改动流程是:先全局搜索关键词,凭经验找出这七处;逐个修改;改完在测试环境跑一遍;上线后第三天,某个没被搜到的角落脚本(关键词拼写还不一样)还在用旧口径,两个部门的周报数字对不上,数据团队花了一整天排查。
迁移到 dbt 之后,同类需求的过程变成了这样:营收口径定义在一个中间层模型里,上游是贴源层的订单明细模型,下游是三张指标宽表。工程师改中间层模型里的过滤与汇总逻辑,提交合并请求;评审者在血缘图上看到这次改动的下游影响范围——正是那三张宽表和挂在上面的六张报表,范围确认无误;流水线自动重跑了改动模型及其下游,口径切换后数字与手工核算的结果一致;合并部署,当晚调度生效。全程没有「搜索关键词碰运气」这个环节,因为引用关系全部写在代码里,工具算得一分不差。
解读这个案例:差别不在「写 SQL 的水平」,而在引用关系由谁保管。前一种方式里,引用关系保管在老员工的记忆和运气里;后一种方式里,它被 ref 函数显式声明,编译期即可分析。变式思考:如果口径变更需要同时保留新旧两个版本做对照(比如财务追账),在 dbt 里可以新建一个模型引用同一个上游、实现第二套口径,两个版本并存、各自命名,互不干扰——这在视图散落的旧方案里同样能做,但下游引用哪个版本、有多少表在用,就又回到人肉排查了。
适用边界:它不做什么
工具的成熟度体现在它知道自己不做什么。三件事不要指望 dbt:
不做数据的抽取与加载。 dbt 假设数据已经在仓库里了。从业务库到仓库这一段,用同步工具、采集管道或者你自建的系统解决。dbt 有 source 声明机制可以监控上游数据的到货新鲜度,但到货这个动作本身不是它做的。
不做实时流处理。 dbt 的执行模型是「发起一批、跑完一批」的批处理,依赖仓库的计算引擎。秒级延迟的实时场景需要流计算引擎,那是一套独立的技术栈。对绝大多数分析场景,分钟级的定时构建已经够用,但需求如果是实时风控、实时大屏,别硬套。
不替你定义业务口径。 dbt 提供把口径固化下来的载体(模型、测试、文档),但「营收到底算不算运费」这种业务判断只能由人和业务方敲定。工具能让口径一旦定下就稳定执行、有据可查,定口径的责任仍然在人。
关键直觉:判断一个需求该不该用 dbt,就问一句——它是不是「已经在仓库里的、关系型的、可以批处理的数据变换」。三项都满足,dbt 是正解;任何一项不满足,先考虑别的工具。
新人最常见的三个疑问
dbt 和 BI 工具里的建模功能是什么关系
BI 工具的建模(计算字段、语义模型)服务的是「展示层」的灵活拼装,逻辑住在 BI 工具里,跟着报表走;dbt 的建模服务的是「数据资产」的沉淀,逻辑住在版本库里,跟着代码走。两者不是替代关系,但有一条纪律:业务口径的定义要放 dbt 侧,BI 只做展示层的轻计算。口径一旦搬进 BI,它就脱离了版本控制与测试的管辖区,1.3 节讲的「口径漂移」会从工具缝隙里重新长出来。
用 Python 做转换的团队适合 dbt 吗
适合,但要选对入口。dbt 支持 Python 模型(在支持的仓库上运行),适合「SQL 表达不了的处理」——统计检验、简单的机器学习推理、复杂的文本解析。但 Python 模型的适用范围与代价(调试复杂度、平台支持度)都高于 SQL,原则是:能用 SQL 表达的用 SQL,Python 只做 SQL 做不了的最后一公里。
学 dbt 需要先学数据仓库理论吗
需要,但只需要一课的量:理解事实表与维度表的区别、知道星型模型长什么样。dbt 报表层的 dim 与 fct 前缀背后就是这套建模常识,没有它,报表层的设计会退化成「把明细原样再存一遍」。至于更深的维度建模理论(渐变维、总线矩阵),可以边做边补,不构成入门门槛。
本节要点回顾
- 定位一句话:dbt 是运行在数据仓库之上的转换层工具,只管 ELT 里的 T,不碰抽取加载,不做实时流。
- 起点是依赖问题:ref 引用让 SQL 获得模块化能力,依赖树是从这里长出来的,拓扑排序、血缘、影响分析都建立在它上面。
- 四项核心价值:依赖显式化、逻辑版本化、质量可验证、文档自动生成——合起来把脚本变成了工程资产。
- 口径变更案例的核心启示:引用关系由工具保管还是由人的记忆保管,决定了变更成本与事故概率。
- 边界判断法:仓库内、关系型、可批处理,三个条件同时成立才优先考虑 dbt。
下一节我们把 dbt 这台机器的机盖打开,看看 Core、适配器与 Cloud 三个部件各自承担什么职责——那是一条命令背后真正干活的零件。