- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
dbt数据转换:把数仓建设当工程来做
「分析即代码」——在数据团队的圈子里,这五个字出现的频率越来越高。它的意思是:数据清洗、加工、建模这一整套转换逻辑,不该再以一堆散落的脚本形式存在,而应该像软件代码一样,进版本库、走评审、配测试、可回滚。dbt 就是这个想法最成体系的落地工具:你写 SQL(也支持 Python),它负责把这些 SQL 之间的依赖关系算清楚、按顺序跑进数据仓库、验数据质量、生成文档和血缘。这本教程按「数仓分层施工志」的路子组织——把一个 dbt 项目从立项到交付看成一次完整的工程施工,你在每一章看到的都不是孤立的功能清单,而是工地上环环相扣的工序。
为什么 dbt 值得花几周时间学
先说它解决的实际问题。在不少团队里,数据加工逻辑长年住在三种地方:调度系统里的 Shell 脚本、数据库里的存储过程、BI 工具里点出来的计算字段。三种地方三套口径,改一处不知道会牵连哪里,出了问题靠人肉翻日志。dbt 把这些逻辑全部拉回到一个代码仓库里:每个模型是一个文件,模型之间用引用函数显式声明依赖,整张依赖图在编译期就能算出来——谁依赖谁、改一张表会影响哪些下游,工具直接告诉你。转换逻辑从「口口相传的经验」变成「可审查的资产」,这是 dbt 带来的最本质变化。
再说它的工程属性。版本控制、代码评审、自动化测试、持续集成,这些软件行业的标准动作,dbt 全部原生支持。一个模型改了口径,评审的人能在合并请求里看到 SQL 的差异;合并之前,流水线自动跑数据测试,脏数据过不了闸;上线之后,文档站点和血缘图随构建自动更新。数据团队第一次可以理直气壮地说:我们的产出物和后端服务一样可靠。
也要把丑话说在前面。dbt 只负责「转换」这一段:数据从哪来(抽取与加载)、到哪去(BI 与应用),都不归它管。它跑在数据仓库的计算引擎上,不自带存储和算力;它擅长基于关系表的批处理建模,不擅长流式计算和复杂的机器学习特征管线。如果你的场景是把上游业务库的变更实时同步到仓库,dbt 不是那把对的锤子。
全册知识地图
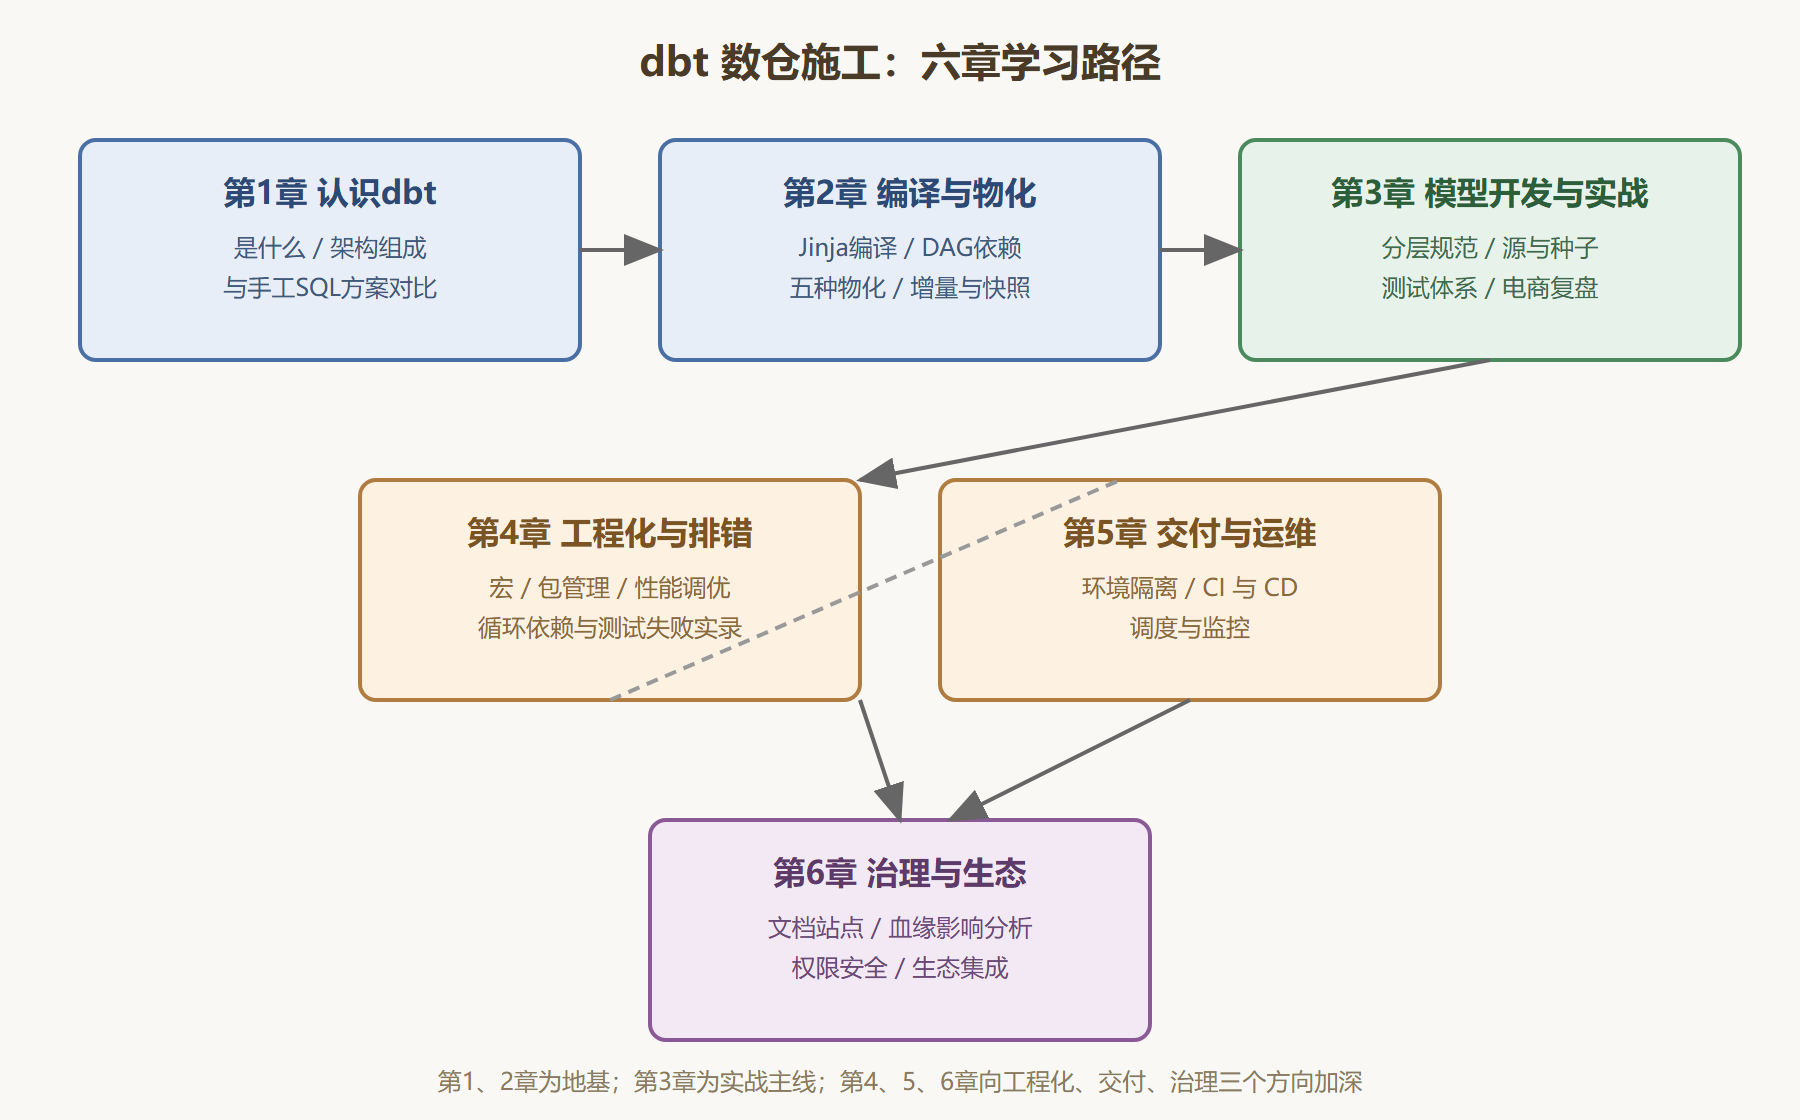
全册六章,按「先认识工地、再学施工工序、然后真刀真枪干一个项目、最后补齐交付与治理」的顺序推进。下图标出了章节之间的依赖关系:第一章和第二章是地基,第三章把模型开发的完整流程走一遍并用一个电商项目串起来,第四、五、六章分别向工程化、交付、治理三个方向加深。
图:全册章节依赖与学习路径
各章覆盖什么、怎么读
第一章回答「dbt 是什么、由什么组成」:Core 与 Cloud 的分工、适配器如何对接不同数仓,以及它和「手写 SQL 建视图」这类传统做法的系统性对比。第二章钻进机器房:一段带模板语法的 SQL 如何被编译成纯 SQL、依赖图如何生成、五种物化策略各自把表变成什么形态,最后用增量模型与快照两条路径解决「既要新数据又要留历史」的问题。
第三章是全册的实战主线。先讲模型目录结构与分层规范(放线),再讲数据源声明与种子文件(进场材料验收),然后是数据质量测试体系(工序验收),最后用一个电商项目把订单、用户、支付三类数据从贴源层一路建到指标宽表,完整复盘从建模到上线的全过程。第四、五、六章面向要把 dbt 用到生产环境的读者:宏与包是工地上的预制件体系,性能调优是工期优化,排错实录收录了循环依赖、测试失败这些高频事故的现场;第五章讲多环境隔离与持续集成部署;第六章讲文档站点、血缘影响分析、权限安全与上下游生态。
每章的章首都有本章知识点清单和一张全景图;每节开头会说明它承接哪里、通向哪里。如果你只有零散时间,第一章、第二章和第三章的电商复盘是最低限度不可跳过的部分;如果你正准备把团队的调度脚本迁到 dbt,第五、六章请务必连读。
学完这本教程,你应当能独立完成这些事:为一个新项目设计分层目录与命名规范;把一批存储过程翻译成带依赖声明的 dbt 模型;为关键模型配置物化与增量策略;给核心表配上非空与唯一性测试并接入持续集成;上线后用文档站点和血缘图回答「这张表能不能动」的问题。工器具已经摆好,下一章先从认工地开始。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...