4.1 宏开发与代码复用
4.1 宏开发与代码复用
本节摘要:宏是 dbt 项目里的预制件厂:一段带参数的逻辑定义一次,几十个模型重复引用,改一处全项目生效。本节讲三类最值钱的宏——通用 SQL 片段、方言适配、动态 SQL 生成——以及「该不该抽宏」的判断标准。宏的滥用和不用一样伤项目:预制的标准件能提速,但满屋子都算预制件的房子没法住。
预制件思维
建筑工地的两种模式:一种把水泥砂浆搬到每一层现场现拌,一种在地面把构件预制好、吊装到位。模型数量超过二十个之后,前一种模式的问题会集中爆发——同样的「时区转换」逻辑出现在十五个清洗模型里,某个字段规则变了,你要凭记忆改十五处,漏一处就是一张口径不一致的表。
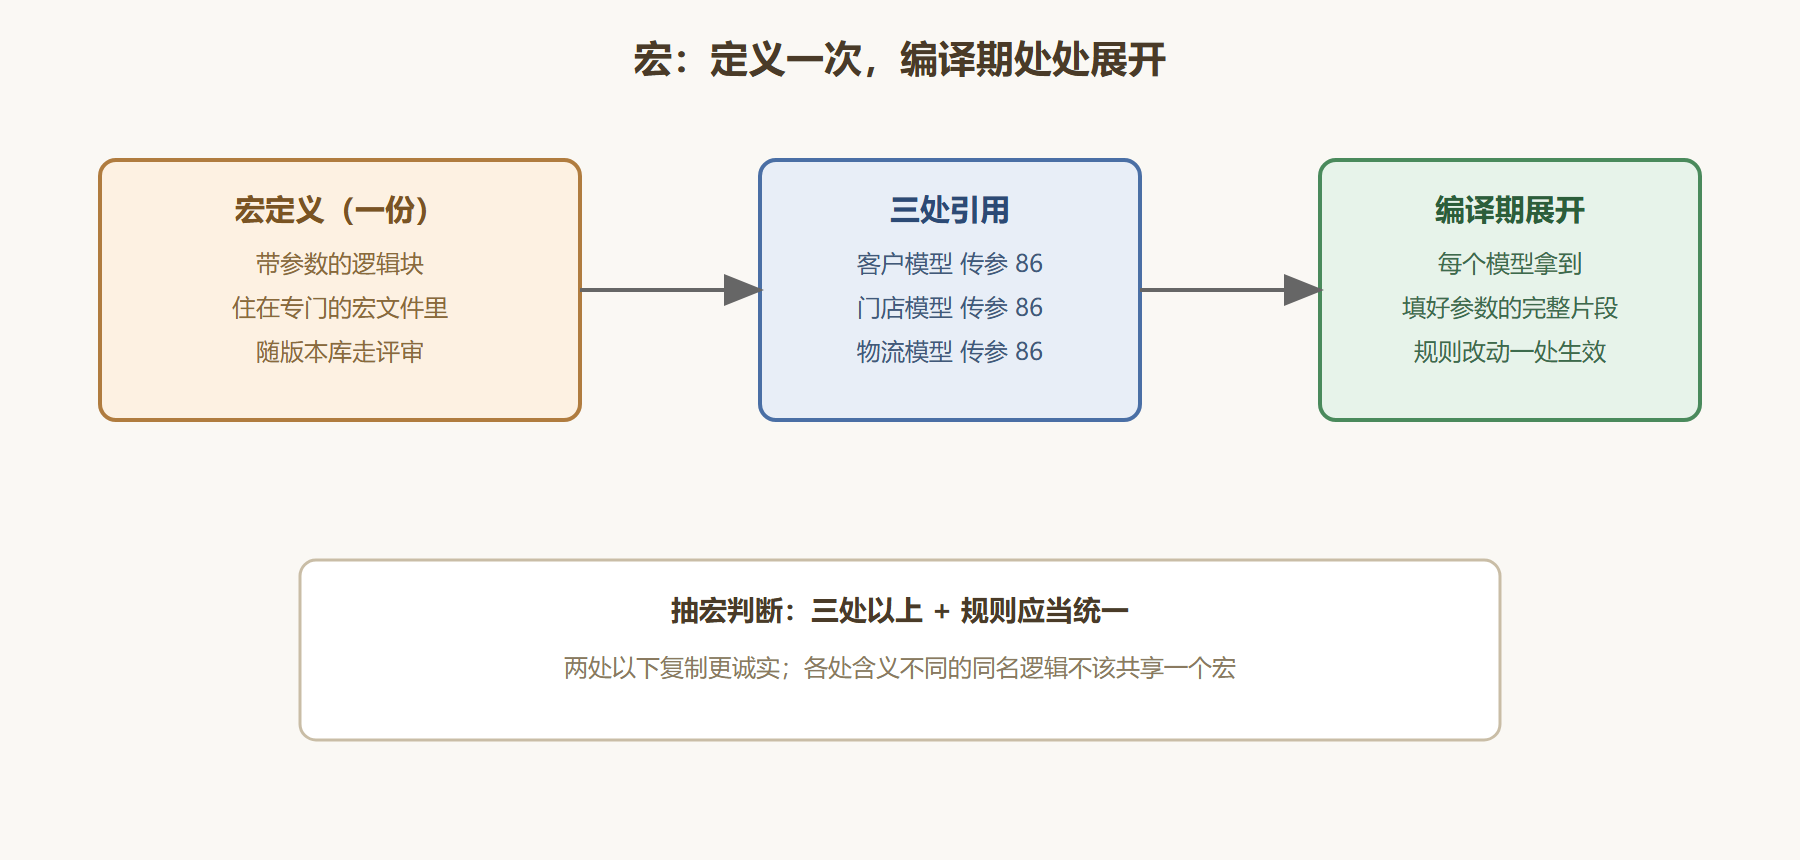
宏就是 dbt 的预制件。它定义在专门的宏文件里,本质是一个带参数的 Jinja 函数,编译期展开进引用它的每个模型:
-- 宏定义:统一的国家码标准化逻辑 {% macro standardize_phone(raw_phone, default_country) %} case when raw_phone is null then null when raw_phone like '+%' then raw_phone else '+{{ default_country }}' || regexp_replace(raw_phone, '[^0-9]', '') end {% endmacro %}
任何模型里一行引用,编译期就展开成完整的 case 表达式:
-- 模型中的引用写法 select user_id, {{ standardize_phone('phone', '86') }} as phone_std from {{ ref('stg_customers') }}
这个例子里宏买到的保险是:标准化规则只存在一处。哪天要支持港号格式,改宏文件一行,十五个模型下次构建全部生效——没有全局搜索,没有「我记得还有哪几个文件也写过」。
三类最值钱的宏
第一类:通用 SQL 片段。 上面手机号的例子属于此类。判断一段重复逻辑值不值得抽成宏,看两个条件:出现在三个以上模型里,且业务规则有理由统一(同一含义的字段就该同一套清洗规则)。只出现两次的、或各处含义本就不同的逻辑,复制粘贴反而更诚实——过早上宏是过度设计,过晚是技术债,三个模型是行业里约定俗成的分界线。
第二类:方言适配。 团队跨着 Snowflake 与 BigQuery 两个仓库时,日期截断、字符串拼接这类方言差异可以用宏收口:
-- 方言适配宏:日期截断按所在仓库选写法 {% macro date_trunc_day(column) %} {% if target.type == 'bigquery' %} date_trunc({{ column }}, day) {% elif target.type == 'snowflake' %} date_trunc('day', {{ column }}) {% else %} date_trunc('day', {{ column }}) {% endif %} {% endmacro %}
模型里统一写 {{ date_trunc_day('ordered_at') }},仓库差异被关进宏的笼子。这类宏的额外收益是「迁移友好」:换仓库时改宏不动模型,呼应了 1.2 节适配器案例的结论。
第三类:动态 SQL 生成。 宏可以按输入生成整段结构化 SQL。典型场景是「对一组列做同一套处理」:二十个指标列都要做空值转零与单位换算,手写二十遍不如一个循环宏,按传入的列清单逐列生成。这类宏写起来像编程,也最容易写过界——当宏的逻辑复杂到需要调试时,通常说明该停下来想想是不是把不该用 SQL 干的事塞给了 SQL。
图:宏在编译期的展开过程
宏的维护与命名约定
宏一旦多起来(一个成熟项目几十个很正常),它自己就需要治理,否则预制件厂变成废品堆。三个被验证过的约定:
按用途分文件。通用片段、方言适配、动态生成各住一个文件(或一组文件),文件名即索引。找宏的场景永远是「我记得有个干这件事的宏」——按用途组织才能三十秒定位。
命名带动词与参数语义。宏是函数,命名照函数的规矩来:standardize_phone 一眼知道干什么;helper、common、utils 这类名字是命名灾难,一个月后没人知道里面装了什么。参数名同理,default_country 比 arg2 可维护得多。
公开与私有分开。只在本项目内部使用的宏加私有前缀,不对外承诺行为——这样改它不必顾虑下游;确有跨项目复用价值的宏,移入内部共享包(4.2 节)并按公开 API 的标准对待:改行为要走评审、写变更说明。
还有一条测试纪律值得单列:宏改了,引用它的模型要全量重跑测试。宏的展开发生在编译期,一个宏影响几十个模型,改动它的风险半径是所有引用者。评审时看「这个合并请求改了宏文件」,就按「等于同时改了几十个模型」的量级对待——多数宏事故源于把它当成改一行的小事。
宏写错了怎么排查
宏的报错分两种,排查路径不同。第一种是编译期报错:Jinja 语法写错、参数个数不对,编译命令会把错误指到宏文件的具体行号,照着改就行。第二种隐蔽得多:编译成功、运行失败——宏展开出的 SQL 在仓库里语法不合法或逻辑不对。这时要养成「先看编译产物再猜原因」的习惯:跑一次编译,把项目渲染成纯 SQL,打开出问题的模型对应的产物文件,肉眼检查宏到底展开成了什么。十有八九你会当场看到答案:参数传错了类型、分支判断走进了没料到的岔路、或者两个宏套用时引号层数错了。
一个真实的小案例:某团队的标准手机号宏在测试环境一直正常,上了生产仓库开始报类型错误。排查半小时无果,最后看编译产物才发现——生产数据里手机号字段是数值类型,宏里的正则函数吃不下数字,开发环境里它一直是字符串。宏不是错,是两边数据类型不一致,而宏没做类型防御。这次的改进是把宏开头加了一步显式转字符串,从此两个仓库行为一致。教训值得记住:宏的可靠性以最差的引用环境为准,写宏时想的不是「我的数据长什么样」,是「所有引用处的数据可能长什么样」。
变量与宏的分工
宏之外,Jinja 还提供变量机制(var)。两者的分工常被混淆:宏是逻辑复用,变量是配置注入。一套代码在开发环境算七天数据、在生产环境算三年,把时间窗做成变量,部署时注入不同值——这是变量该干的活。判断「要不要根据环境改变逻辑」也用变量,而「多个模型共享一段逻辑」用宏。把本该是变量的事写成宏(宏内部判断环境名然后返回不同逻辑),短期省事,长期是灾难:逻辑分叉藏在宏里,评审的人看不到,环境行为差异变成考古题。
变量两种注入方式都要会用:项目配置里给默认值,命令行用加参数临时覆盖(比如回溯数据时临时把时间窗拉长)。默认值进版本库,临时覆盖不落库——这是一对理想的组合。
💡 关键直觉:宏与变量都在对抗重复,但对抗的不是同一种重复——宏消灭「代码的重复」,变量消灭「配置的重复」。分不清这两者的团队,会写出按环境名分叉的巨无霸宏,那不是复用,是把开关藏进了代码。
本节要点回顾
- 宏是预制件:定义一份、编译期展开到引用处,规则改动一处生效。
- 三类值钱的宏:通用片段(三处以上才抽)、方言适配(换仓库改宏不改模型)、动态 SQL 生成(对一组列做同套处理)。
- 过早上宏是过度设计:两个模型间的复制不是债,是诚实;三个是分界线。
- 宏管逻辑、变量管配置:环境差异走变量注入,别让宏内部长出按环境分叉的逻辑。
自己的轮子收敛好了,下一步看别人的轮子怎么装。下一节讲包管理——把社区现成的通用模型与工具装进项目,以及装多了会发生什么。