4.3 通用计算DirectCompute与DirectML实战
4.3 通用计算 DirectCompute 与 DirectML 实战
本节摘要:计算着色器让 GPU 跳出画图本行,成为大规模并行处理器:DirectCompute 是原始算力接口,DirectML 是其上的机器学习推理层。本节拆解调度模型,用图像去噪与推理两个案例展示"图形与计算同卡共驾"的实战。
从一个念头说起
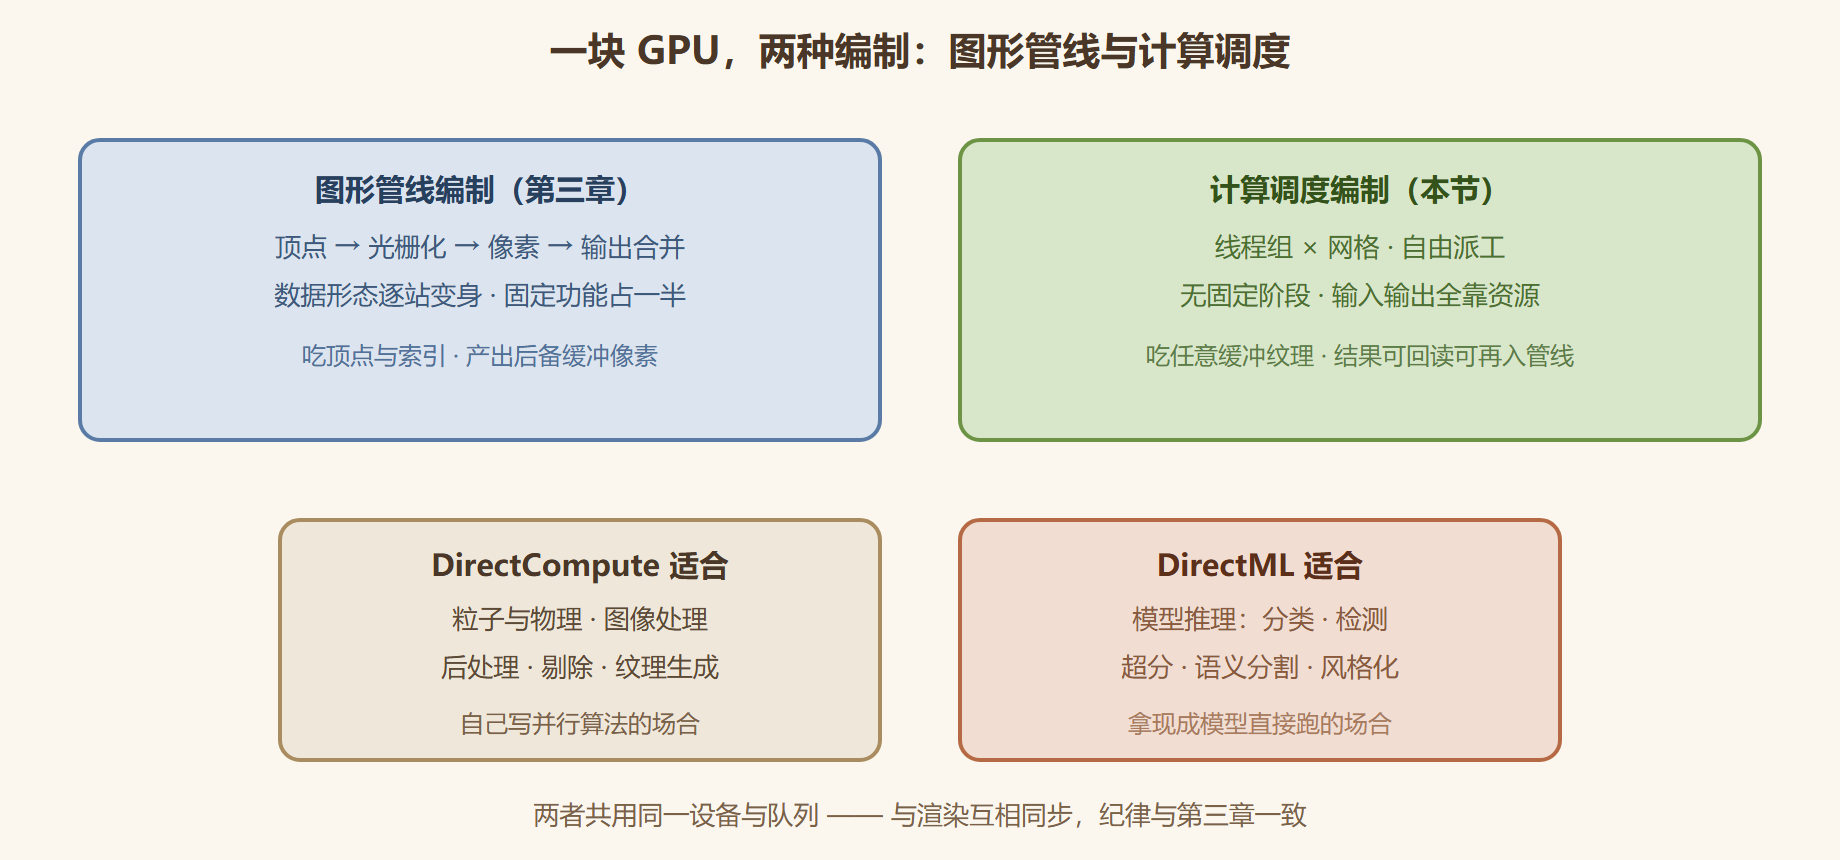
盯着像素着色器写久了,有人会冒出一个念头:这些并行单元既然能算颜色,能不能算点别的?物理粒子、流体、图像处理、矩阵乘法——本质都是"大量数据元素各自独立做同样计算"。DirectCompute 就是这个念头的正式化:不画图,纯算数的计算着色器。它借住在一个特殊的管线阶段里,输入输出靠缓冲与纹理,调度靠线程组。而 DirectML 更进一步:把神经网络推理常用的算子(卷积、池化、激活)打包成现成接口,底层仍跑在计算着色器上。一个给"自己写并行算法"的人,一个给"只想跑模型"的人。
调度模型:线程组是基本编制
计算着色器的调度单位是线程组:一个组内若干线程共享一块小内存(组共享内存),组间再排成更大的网格调度。这个两级编制对应两类数据共享:组内用共享内存快速交换,全局用缓冲通信。写一个图像去噪的计算着色器骨架:
// 输入输出都是 2D 纹理,numthreads 声明每组的线程编制 Texture2D<float4> noisy : register(t0); RWTexture2D<float4> clean : register(u0); groupshared float4 tile[16][16]; // 组内共享块 [numthreads(16, 16, 1)] void CSMain(uint3 gid : SV_GroupID, uint3 tid : SV_GroupThreadID, uint3 dtid : SV_DispatchThreadID) { tile[tid.x][tid.y] = noisy[dtid.xy]; // 各线程搬一块进共享内存 GroupMemoryBarrierWithGroupSync(); // 等全组搬完 float4 sum = 0; [unroll] for (int dy = -1; dy <= 1; ++dy) for (int dx = -1; dx <= 1; ++dx) sum += tile[tid.x + dx][tid.y + dy]; // 共享内存内做邻域平均 clean[dtid.xy] = sum / 9.0; // 写回输出 }
CPU 侧的调度代码异常短小——这正是计算着色器的魅力:
cmdList->SetComputeRootSignature(csRootSig.Get()); cmdList->SetPipelineState(csPSO.Get()); // 计算型 PSO,无光栅化状态 cmdList->SetComputeRootDescriptorTable(0, srvHandle); cmdList->SetComputeRootDescriptorTable(1, uavHandle); cmdList->Dispatch(width / 16, height / 16, 1); // 按 16×16 网格派工
两处细节值得点破:其一,UAV(无序访问视图)是计算着色器的读写通道,u 槽位与读写语义都来自它,3.4 节资源表里那位"可读写的角色"在此登场;其二,Dispatch 的线程组数要覆盖数据,除不尽的边界要靠着色器里判越界——这是新手常见 bug:边缘像素没处理,画面留下一圈黑边。
图1 图形与计算同卡共驾
计算与图形之间也要红绿灯:UAV 屏障
还有一个同步细节,实战里撞上才知道疼:同一个命令列表里,先跑一个写入某纹理的计算 pass,再跑一个读它的 pass,调试层大概率报 UAV 冲突——GPU 可能把两个 pass 的线程混着跑,读的一方拿到半成品数据。解法是两者之间插一道 UAV 屏障(UAV Barrier):它告诉驱动"前面的写必须全部落地,后面的读才能开工"。这与第三章 ResourceBarrier 是同一门亲亲戚——状态屏障管"资源换了个用法",UAV 屏障管"读写换了波人马"。多 pass 计算链里,每条依赖边都得有屏障或换队列后的栅栏把秩序钉死;漏一道,症状是偶发的画面异常而非稳定的报错,排查成本极高。纪律一句话:谁写谁读换手时,屏障必须在场。屏障的粒度也有讲究:UAV 屏障默认作用于全局(等所有 UAV 的写入落地),粗粒度意味着代价不小——把能合并的计算 pass 归到一起再插屏障,比 pass 之间各自为政插一串屏障便宜。这与 6.1 节状态屏障的合并思路同款:同步点本身是钱,会过日子的人少插、合并插。
常见疑问:同一件事计算和像素着色器都能做,怎么选
判断题只问三个字:要不要光栅化。需要插值、需要深度、需要与屏幕像素对齐——那是像素着色器的主场,它天生按覆盖率并行;纯数据搬运与变换(模糊、降采样、粒子积分、前一层结果复用)——计算着色器更直,不用假装画三角形,中间结果也不必经过渲染目标的状态切换。经验法则是:图像链的每一站若都是"整幅图进、整幅图出",用计算着色器串;某站需要利用三角形与插值信息,留在图形管线里。两者还能混编:几何相关的前几站走图形管线,后处理链整体搬进计算 pass,用 UAV 屏障衔接——很多现代渲染框架正是这么组织的。
案例两则
案例一:后处理链的计算化。 背景:渲染管线的泛光与景深后处理原写在像素着色器里,多 pass 之间靠渲染目标来回切换。操作:把两个高斯模糊 pass 改为计算着色器,中间结果放 UAV 纹理,免掉渲染目标切换与光栅化开销。结果:后处理段帧时间下降明显,且代码里"写 UAV 再读回来"的路径让数据流向一目了然。解读:图形与计算的边界是流动的——不需要光栅化加工的图像操作,用计算着色器往往更直。变式:粒子系统是同思路的放大版——更新逻辑全在计算着色器,渲染只是把粒子位置画出来,数据与呈现解耦。
案例二:DirectML 跑超分模型。 背景:工具类应用要在用户机器上做图像超分,不假设用户装了特定推理框架。操作:用 DirectML 加载 ONNX 格式模型,输入输出都是 D3D 12 纹理,与现有图像处理链直接衔接;会话建立时让 DirectML 自动查询设备能力选执行路径。结果:模型跑在用户已有的 GPU 上,安装包不带额外运行时。解读:DirectML 的价值在随系统分发、纹理直通——适合"产品要带一个模型"的场景;训练与大型部署则另请专业框架,定位不同不必强求。两套方案同卡共存时,队列与同步纪律照旧——这正是本章与全书概念反复咬合的又一处。
本节要点回顾
- 计算着色器的编制:线程组为基本单位,组内共享内存 + 全局缓冲两级通信,Dispatch 按网格派工。
- UAV 是读写通道:无序访问视图让计算直接读写纹理与缓冲,边界越界要自己在着色器里判。
- DirectCompute 与 DirectML 的分工:自写并行算法用前者,跑现成模型用后者,同卡同队列共存。
- 图形与计算的边界是流动的:免光栅化的图像操作,用计算着色器常常更直。
算力电路接通,还剩两根"神经":声音与触觉——XAudio2 与 XInput 的低延迟世界,下一节收尾本章。